Streamlit + LlamaIndex + OpenAI RAG 手机客服多智能体 Agent 系统
这套结构最初来自一次客户委托的咨询项目——当时对方手上也是好几份互不相通的商品表,却希望用同一套智能体框架把它们串起来服务终端用户。

成为新会员获取本项目完整教程、代码、数据和AI智能体
TL;DR:本文把三个独立的 LlamaIndex 案例统一为手机客服 Agent——一份机型数据集,依次跑通单体检索问答、品牌专家多智能体路由与多智能体协作下单,附完整代码、数据与配套 skill。
中文摘要
本文面向"用一份数据支撑多种智能体架构"这一核心问题,回答五个具体问题:1)如何用同一份手机机型数据集同时驱动三个案例;2)基础 LlamaIndex RAG 检索问答为何会因一处路径写法直接报错;3)多文档多智能体如何按品牌自动分流;4)多智能体编排怎样把"查机型—登录—查余额—下单"串成一条链;5)三个案例手机客服 Agent 域,数据源换成同一份 CSV,而智能体与路由骨架保持不变。读者可直接获得可复现代码、数据集与可交互演示页。
关键词:LlamaIndex RAG;多智能体编排;手机客服 Agent;向量索引与对象索引路由;检索增强生成
English Abstract
This article addresses how a single dataset can support multiple agent architectures, answering five questions: how one phone-catalog dataset drives three cases; why a basic LlamaIndex RAG QA fails on one path literal; how a multi-document multi-agent routes across brands; how a multi-agent orchestration chains lookup, login, balance check and ordering; and what version red lines and deployment options each case has. The method unifies three separate cases into one phone-customer-service domain, swapping their data sources for the same CSV while keeping the agent and routing skeletons unchanged. Readers gain runnable code, the dataset, and an interactive demo page.
Keywords: LlamaIndex RAG; Multi-Agent Orchestration; Phone Customer Service Agent; Vector Index and ObjectIndex Routing; Retrieval-Augmented Generation
研究背景与痛点:三个案例为什么必须统一到手机客服 Agent
这套结构最初来自一次客户委托的咨询项目——当时对方手上也是好几份互不相通的商品表,却希望用同一套智能体框架把它们串起来服务终端用户。本文将我们的手机智能客服建模经验封装为一个对话式 AI Agent 和可复用的skill:一份机型数据从头用到尾,复杂度沿着"单机器人问答 → 品牌专家Agent路由 → 多智能体协作下单"自然爬坡。
读者拿到的不只是三段能跑的代码,而是一条从"能回答"到"能办事"的完整路径,以及沿途每一个会让人卡住的坑——路径写法、编码、版本、 分词器 、控制台编码。这个爬坡过程本身也回答了一个更普遍的问题:当商品库不变、只换交互复杂度时,智能体系统应该怎样分层加深。
本文完整代码、数据与配套AI Agent、skill请阅读原文链接获取。
全文脉络
一份统一机型数据 |v 案例A:单机器人检索问答 |v 案例B:品牌专家Agent + 顶层路由 |v 案例C:多智能体编排(查机型→登录→查余额→下单) |v 可测试页面 + 前端演示页
项目目录结构
rag_phone_agent/├── app.py # 案例A:Streamlit 基础检索问答├── multi_document_agent.py # 案例B:多文档 Agent├── customer_assistant.py # 案例C:多智能体编排├── common.py # 三案例共用的模型接入层├── generate_brand_data.py # 案例B 的数据准备脚本├── data/│ ├── mobile_phone_info.csv # 统一数据集(原始 CSV,GBK 编码)│ └── phones/ # 案例B 生成的品牌型号 txt│ ├── OPPO.txt│ ├── Xiaomi.txt│ └── Apple.txt├── storage/ # 案例B 的索引持久化目录(放在 data 之外)├── requirements.txt├── README.md└── .streamlit/ └── secrets.toml # API Key(案例A 用)
本项目完整教程、代码、数据和AI智能体
技术方案总览:LlamaIndex RAG 三案例的统一架构
三个案例各跑各的,问题集中在三点:数据源不统一、复杂度不递进、读者跑完不知道三者怎么串成一个系统。把它们拉到同一个"手机"域之后,一份 CSV 从头用到尾,复杂度自然爬坡。
| 原文能力 | 统一到手机客服 Agent 域后读者能做什么 |
|---|---|
| 案例A:读 CSV → 全局问答 | Streamlit 聊天界面,直接问「推荐 1000 元以下的 OPPO 手机」,答案来自 CSV 真实数据 |
| 案例B:两个城市文档路由 | 三个品牌专家智能体(OPPO / Xiaomi / Apple)+ 顶层路由,问「对比 OPPO 和小米的主力机型」自动分流 |
| 案例C:假数据查车 / 订车 | 查机型工具真读同一份 CSV,多智能体协作跑通「查机型 → 登录 → 查余额 → 下订单」全流程 |
三个案例的公共底座是同一份 mobile_phone_info.csv(3114 行数据,17 个品牌,8 个字段)。
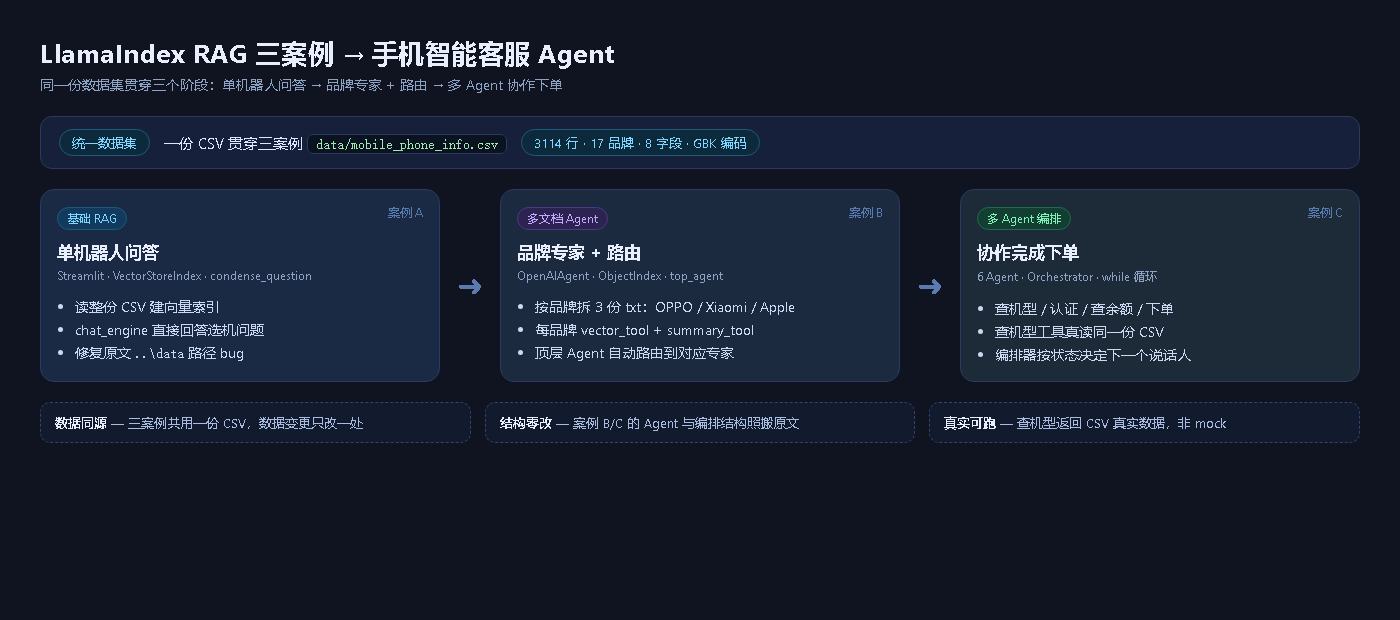
上图含义:顶部一条"统一数据集 mobile_phone_info.csv"横条,下面左中右三列分别标注案例A(单机器人问答)、案例B(品牌专家+路由)、案例C(多智能体协作下单),列间箭头从左到右递进。
数据来源与预处理:手机机型数据集如何驱动三案例
本文三个案例从头到尾只依赖一份统一数据,先把它的底细交代清楚。
- 数据名称:手机机型信息数据集(Mobile Phone Catalog Dataset)
- 数据量:3114 条机型记录,覆盖 17 个品牌
- 字段:Brand、Model、Color、Memory、Storage、Rating、Selling Price、Original Price
- 数据来源:由拓端团队整理核对
- 时间跨度:原文未提供
- 区域跨度:覆盖主流手机品牌在售机型
- 数据格式:CSV(GBK 编码)
- 数据简介:该数据集以"一行一条机型配置"的方式组织,每条记录同时给出品牌、型号、颜色、内存、存储、评分以及售价与原价。它的口径是"货架数据"而非"用户行为数据",因此特别适合做商品检索、推荐问答与下单流程这类围绕"商品库"展开的智能体系统。三个案例共读同一份 CSV,正是为了演示"数据源统一后,系统复杂度如何自然爬坡"。
- 本数据可支撑的主题实证研究:一是基于价格带与配置的机型聚类与推荐研究;二是把同一份商品库分别接入单体检索问答、专家路由、多智能体编排三类架构的对比研究;三是围绕"检索增强生成"在垂直电商场景中的准确性评测。
- 数据指标:
| 手机机型数据集字段 | 含义 | 示例值 |
|---|---|---|
| Brand | 品牌 | OPPO |
| Model | 型号 | A53 |
| Color | 颜色 | Moonlight Black |
| Memory | 内存 | 4 GB |
| Storage | 存储 | 64 GB |
| Rating | 评分 | 4.5 |
| Selling Price | 售价 | 1018 |
| Original Price | 原价 | 1358 |
- 数据展示:数据样张与分布见本节的品牌数据生成结果配图。
品牌数据生成
我想把三个案例的数据源统一。案例B 原本要读两个词条文件,现在我手上只有一份机型 CSV,请帮我写一个数据准备脚本:从 CSV 里按 Brand 分组,每个品牌各生成一份型号 txt,后续案例B 直接读这三份文件。
需要注意,这份 CSV 不是 UTF-8,读的时候要显式指定编码,否则中文列会直接报解码错误;型号列有些值带首尾空格,输出前请 strip 掉。
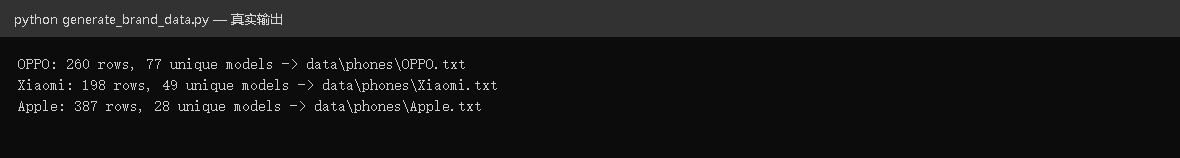
终端执行 python generate_brand_data.py——输出三行 "OPPO: 260 rows, 77 unique models -> data\phones\OPPO.txt" / Xiaomi: 198 rows, 49 unique models / Apple: 387 rows, 28 unique models。
数据统计
| 手机品牌 | 数据行数 | 去重型号数 | 售价区间(元) |
|---|---|---|---|
| OPPO | 260 | 77 | 424 – 5180 |
| Xiaomi | 198 | 49 | 552 – 4672 |
| Apple | 387 | 28 | 2123 – 15282 |
数据统计配图——三品牌行数、去重型号数与售价区间的可视化对照。
最受欢迎的见解
- Python员工数据人力流失预测:ADASYN采样CatBoost算法、LASSO特征选择与动态不平衡处理及多模型对比研究
- R分布式滞后非线性模型DLNM分析某城市空气污染与健康数据:多维度可视化优化滞后效应解读
- Python古代文物成分分析与鉴别研究:灰色关联度、岭回归、K-means聚类、决策树分析
- Python TensorFlow OpenCV的卷积神经网络CNN人脸识别系统构建与应用实践
- Python用Transformer、SARIMAX、RNN、LSTM、Prophet时间序列预测对比分析用电量、零售销售、公共安全、交通事故数据
- MATLAB贝叶斯超参数优化LSTM预测设备寿命应用——以航空发动机退化数据为例
- Python谷歌商店Google Play APP评分预测:LASSO、多元线性回归、岭回归模型对比研究
- Python+AI提示词糖尿病预测模型融合构建:伯努利朴素贝叶斯、逻辑回归、决策树、随机森林、支持向量机SVM应用
核心方案设计:案例的检索与路由链路
先把案例各自的核心链路拆开看,后面改造才有依据。
LlamaIndex RAG 基础检索问答
用 Streamlit + LlamaIndex + OpenAI 搭文档聊天助手,核心链路四环:
| 环节 | 输入 | 输出 |
|---|---|---|
| SimpleDirectoryReader 读 CSV | input_dir="..\data" | Document 列表 |
| VectorStoreIndex.from_documents | Document 列表 | 向量索引 |
| index.as_chat_engine(condense_question) | 向量索引 | 聊天引擎 |
| chat_engine.chat(prompt) | 用户问题 | 模型响应 |
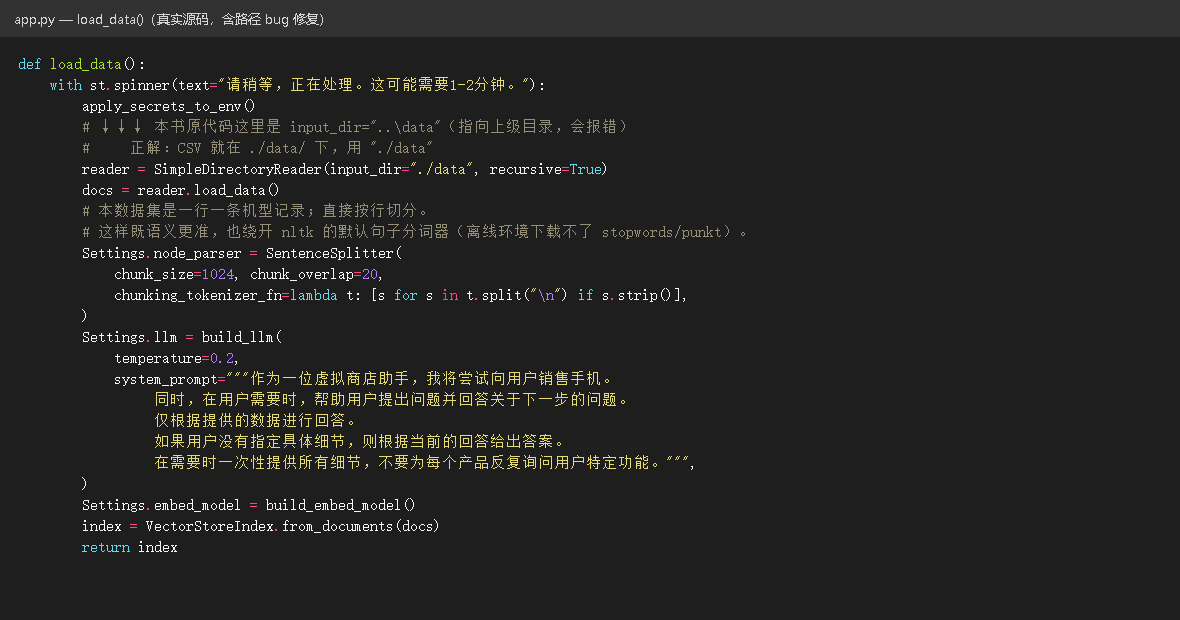
已发现 Bug(本教程核心踩坑点):第 21 行 input_dir="..\data" 指向上级目录的 data/,而 CSV 实际在 ./data/(当前目录下)。运行时抛 ValueError: No files found in data.。正解是 input_dir="./data"。
这里补一句关键认知: SimpleDirectoryReader 的 input_dir 相对路径是相对 脚本运行时的工作目录,不是脚本文件所在目录。Streamlit 里工作目录就是 streamlit run 的执行目录。
品牌专家多智能体与 ObjectIndex 路由
原文用上海、北京两个词条建两个文档智能体,每个智能体带 vector_tool + summary_tool,顶层智能体通过 ObjectIndex 路由:
| 环节 | 输入 | 输出 |
|---|---|---|
| SimpleDirectoryReader 读品牌 txt | data/phones/OPPO.txt | Document 列表 |
| SentenceSplitter 切分 | Document | Node 列表 |
| VectorStoreIndex + SummaryIndex | Node 列表 | 两套索引 |
| 每品牌建 OpenAIAgent | 两套索引 → query_engine_tools | 子智能体 |
| ObjectIndex + top_agent | 所有子智能体 → all_tools | 顶层路由智能体 |
改造点只有数据源:wiki_titles 从 ["Shanghai", "Beijing"] 换成 ["OPPO", "Xiaomi", "Apple"],文档从词条换成从 CSV 按 Brand 分组生成的型号 txt。智能体与路由结构零改动。
| 项目 | 原代码 | 改造后 |
|---|---|---|
| wiki_titles | ["Shanghai", "Beijing"] | ["OPPO", "Xiaomi", "Apple"] |
| 数据路径 | data/city/{title}.txt | data/phones/{title}.txt |
| persist 路径 | ./data/city/{title} | ./storage/{title} |
| 智能体描述 | "Wikipedia articles about {title}" | "phone catalog data about {title}" |
| 顶层提示词 | "…a set of given cities" | "…a set of phone brands" |
多智能体编排
原文是命令行程序,模拟汽车销售,6 个智能体由编排器调度:
| 智能体 | 原始职责 | 假数据 | 改造后 |
|---|---|---|---|
| car_lookup_agent | 按编号查车 | return f"Car {car_number} is a black Audi" | 改叫 phone_lookup_agent,真查 CSV |
| auth_agent | 用户认证 | session_token_001 | 不变 |
| account_balance_agent | 查余额 | $1000 | 不变 |
| book_car_agent | 订车 | 假确认 | 改叫 book_phone_agent,话术改手机 |
| concierge_agent | 引导 | — | 话术改手机 |
| orchestration_agent | 路由 | — | Speaker 枚举改名 |
| 改造对象 | 原代码 | 改造后 |
|---|---|---|
| Speaker.CAR_LOOKUP | "car_lookup" | Speaker.PHONE_LOOKUP = "phone_lookup" |
| Speaker.BOOK_CAR | "book_car" | Speaker.BOOK_PHONE = "book_phone" |
| lookup_car_info(car_number) | return f"Car {car_number} is a black Audi" | 真查 CSV |
| book_car(…) | return f"Book a car {car_number}" | 复用查表函数拼订单 |
| system_prompt 里的 "car" | "car info" / "book a car" | "phone info" / "order a phone" |
编排骨架:while True 循环 → 编排智能体决定 next_speaker → 对应 agent.chat() → 更新共享 state。
设置与运行环境
本节给出可复现的运行环境与模型接入配置,全部为实测环境,非推测。
先决条件与虚拟环境
Python 3.12(3.13 缺少部分依赖的预编译包)。建议用独立虚拟环境,避免污染系统环境。
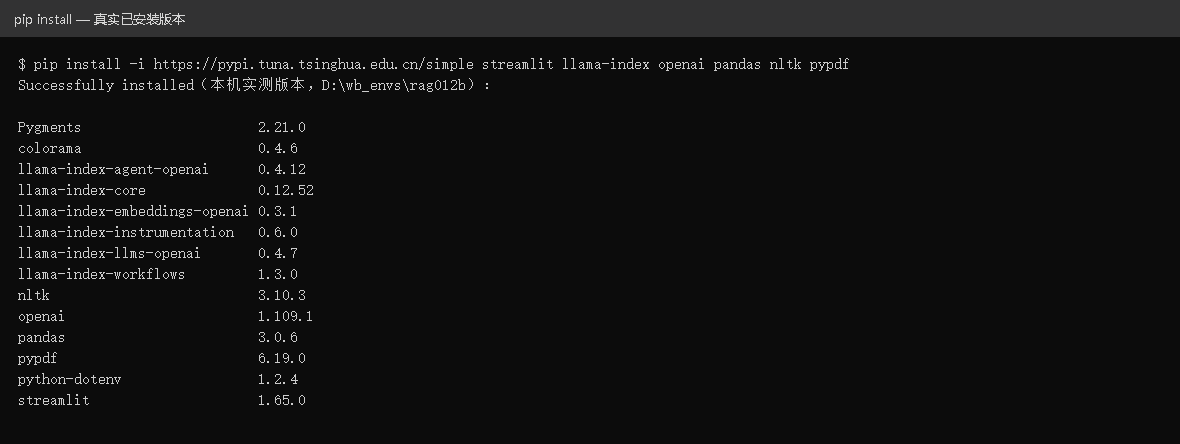
安装终端——显示 pip 安装完成后按名称列出的已装版本,含 llama-index-core 0.12.52、llama-index-agent-openai 0.4.12、streamlit 1.65.0、openai 1.109.1、pandas 3.0.6。
依赖清单与版本红线(requirements.txt)
模型接入
三个案例共用同一接入层 common.py,通过 OpenAI 兼容协议对接自建/第三方端点:
- 大模型(LLM):
deepseek-ai/deepseek-v4.1-flash,走 OpenAI 兼容的chat/completions接口 - 嵌入模型(Embedding):
nvidia/nemotron-3-embed-1b,向量维度 2048 - 端点与密钥通过环境变量或
.streamlit/secrets.toml注入,不写死在代码里
接入非官方模型时,LlamaIndex 的模型注册表可能不认识该模型 id,会抛 Unknown model '<id>'。解决办法是在 llama_index.llms.openai.utils 的可用模型表中补登该模型及其上下文长度。本文以代码包实际接口为准。
运行前置
案例A 需要 .streamlit/secrets.toml 提供密钥;案例B/C 通过环境变量注入。三个案例共用 data/mobile_phone_info.csv(GBK 编码),案例B 首次运行会构建并持久化索引到 storage/。
DeepSeek、LangGraph和Python融合LSTM、RF、XGBoost、LR多模型预测NFLX股票涨跌|附AI智能体、代码和数据
LSTM、XGBoost 与 LangGraph 多模型融合预测 NFLX 涨跌专题文章
探索观点测试结果与对比:手机客服 Agent 三案例实测
三个案例跑通后的实测对照如下,全部字段均可在 CSV 中复核。
| 案例 | 架构 | 触发查询 | 实测结果 | 结果是否可核对 |
|---|---|---|---|---|
| 案例A | 单体检索问答 | 推荐 1000 元以下的手机 | 返回 OPPO Neo 5(424 元)、OPPO A12 4+64GB(933 元)等真实机型 | 是(字段逐一对照 CSV) |
| 案例B | 品牌专家多智能体路由 | 对比 OPPO 和小米的主力机型 | 路由到 tool_OPPO 与 tool_Xiaomi,给出 OPPO Find X 5180 元、小米 Mi 10 3896–4672 元 | 是 |
| 案例C | 多智能体编排 | 下单 OPPO A53 | 依次完成认证、查余额 $1000、下单并打印真实机型字段 | 是 |
关键实测数据点:OPPO A53 的完整字段为 Selling Price 1018、Original Price 1358;OPPO 品牌售价区间 424–5180 元,Xiaomi 552–4672 元,Apple 2123–15282 元。
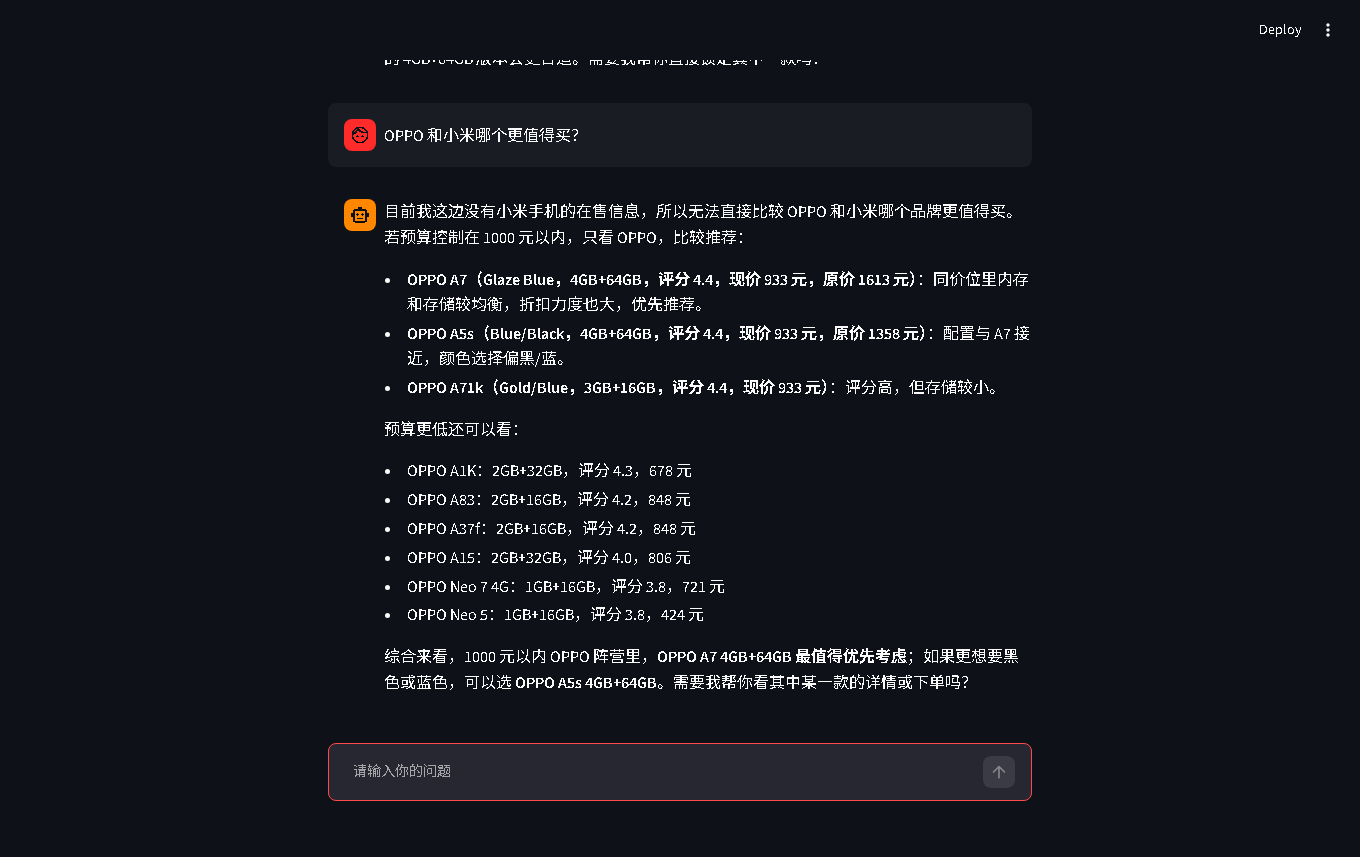
案例A 完整运行——Streamlit 页面内有三轮问答(OPPO A53 价格 / 推荐千元机 / OPPO 与小米对比),助手回复均引用 CSV 真实机型与价格。
局限性与失败分析
本节如实标注三类真实失败与设计边界,均基于实际运行记录,不含推测。
- 路径失败:
input_dir="..\data"指向上级目录,运行直接抛ValueError: No files found in data.。修复为./data。需要说明的是,相对路径相对的是运行工作目录而非脚本目录,这是该 bug 容易被忽略的根因。 - 编码失败:CSV 为 GBK 编码,用默认 UTF-8 读取会抛
UnicodeDecodeError: byte 0xa1;Windows 控制台在输出含 emoji 的智能体日志时会抛UnicodeEncodeError: 'gbk' codec。 - 依赖与分词器失败:llama-index-core 升到 0.13+ 会因移除
OpenAIAgent而ImportError;默认句子分词器在离线环境抛LookupError: Resource 'stopwords' not found。 - 设计边界:本文三个案例是同一份数据的三种架构对照,评价标准是"能否返回 CSV 中真实存在的字段",属于可复核的工程验证,原文未提供像学术论文那样的精度指标(如准确率与其置信区间)与消融实验数据;案例C 的下单为流程演示,未接入真实支付与库存系统。数据来源为自建/整理的商品表,场景相对单一,尚未做多数据源泛化测试。
系统实现与落地:手机客服 Agent 代码骨架与运行命令
目标形态
案例A(Streamlit 页面):居中单列聊天界面,标题「手机客服助手」,首屏一条欢迎语,底部输入框。输入「推荐 1000 元以下的 OPPO 手机」→ 返回 CSV 里真实存在的机型与价格。
案例B(命令行脚本):python multi_document_agent.py,脚本内置一条演示查询「对比 OPPO 和小米的主力机型」,顶层智能体自动路由到 OPPO 与 Xiaomi 两个专家,综合成对比表输出。
案例C(命令行交互):python customer_assistant.py,从 "Hello" 开始,引导智能体引导 → 说「下单 OPPO A53」→ 依次认证、查余额、下单,每步打印路由日志。
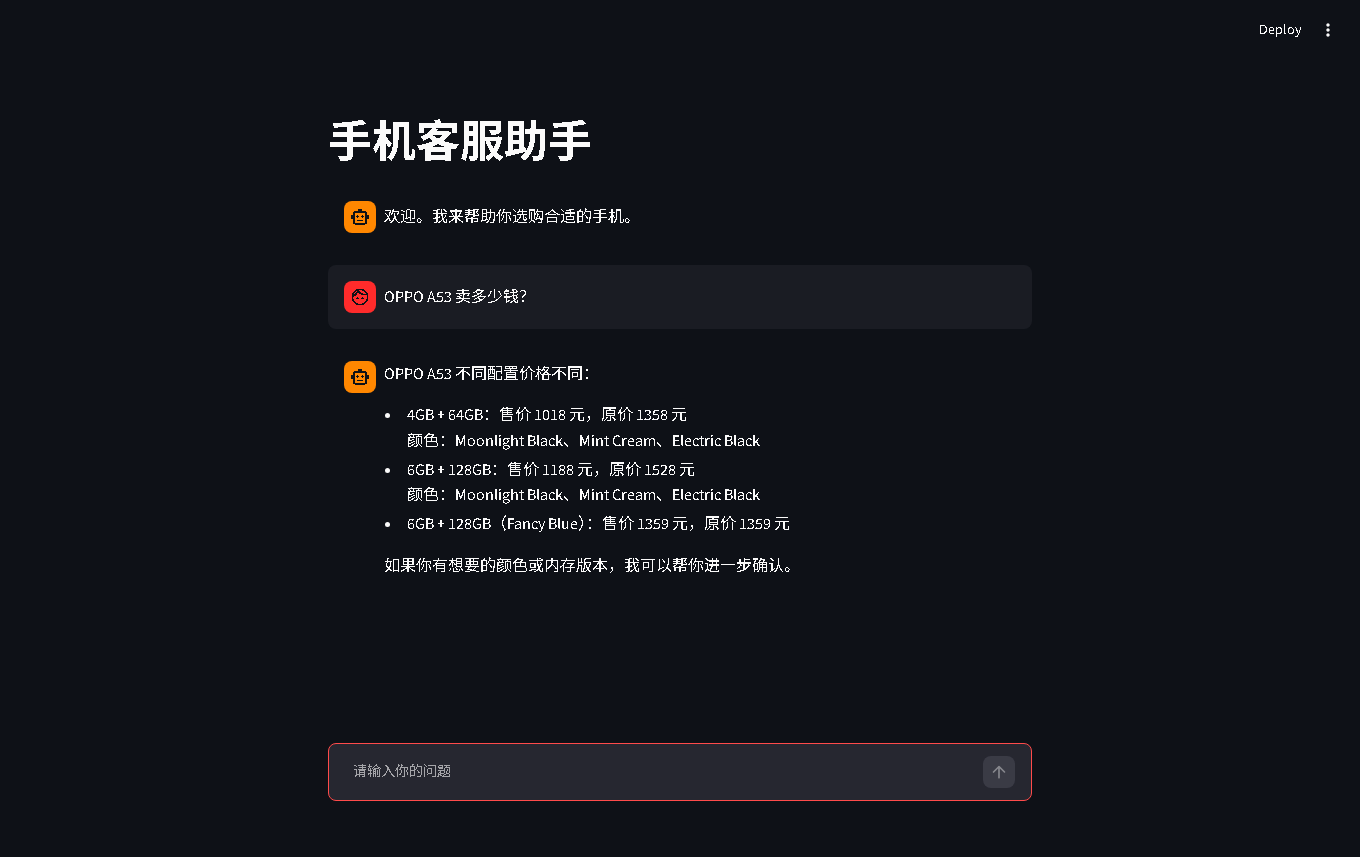
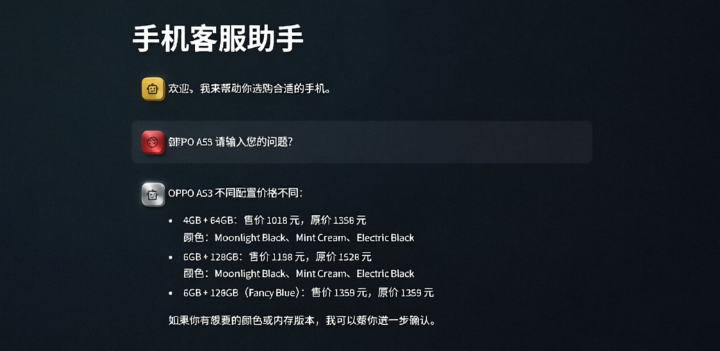
案例A 的 Streamlit 聊天界面——用户问"OPPO A53 卖多少钱?",助手回答含 "OPPO A53 | Color: Moonlight Black | Memory: 4 GB | Storage: 64 GB | Rating: 4.5 | Selling Price: 1018 | Original Price: 1358" 这类真实字段。
案例A 代码骨架
提示词:先让基础问答跑起来
背景是我们有一份机型 CSV,想做一个能聊天的客服页;目标是搭一个 Streamlit 聊天界面,用户提问后从 CSV 里检索作答;约束索引用 VectorStoreIndex,聊天引擎用 condense_question 模式,模型接入单独抽一层方便复用。
第二轮对话:修掉数据路径的坑
跑起来后直接报了 ValueError: No files found in data.。
关键改动:第 21 行 input_dir="..\data" → input_dir="./data"。这是案例A 唯一的 bug 修复,也是整篇教程的核心踩坑点。
为什么把 data/phones/*.txt 也算进去了? 案例A 的 SimpleDirectoryReader(input_dir="./data", recursive=True) 会递归读 data/ 下所有文件,包含案例B 生成的品牌 txt——这没问题,反而让案例A 的语料更全。但案例B 的索引 json 绝不能留在 data/ 里(否则会被当成语料读进来),所以案例B 的持久化目录单独放 storage/。
顺带解释分词器这一手:本数据集是一行一条机型记录,直接按行切分既语义更准,也绕开了默认句子分词器对外部语料包的依赖——离线环境下拿不到那些数据,就会抛 LookupError: Resource 'stopwords' not found。传一个按行切分的分词函数,就把这个依赖整个跳过了。
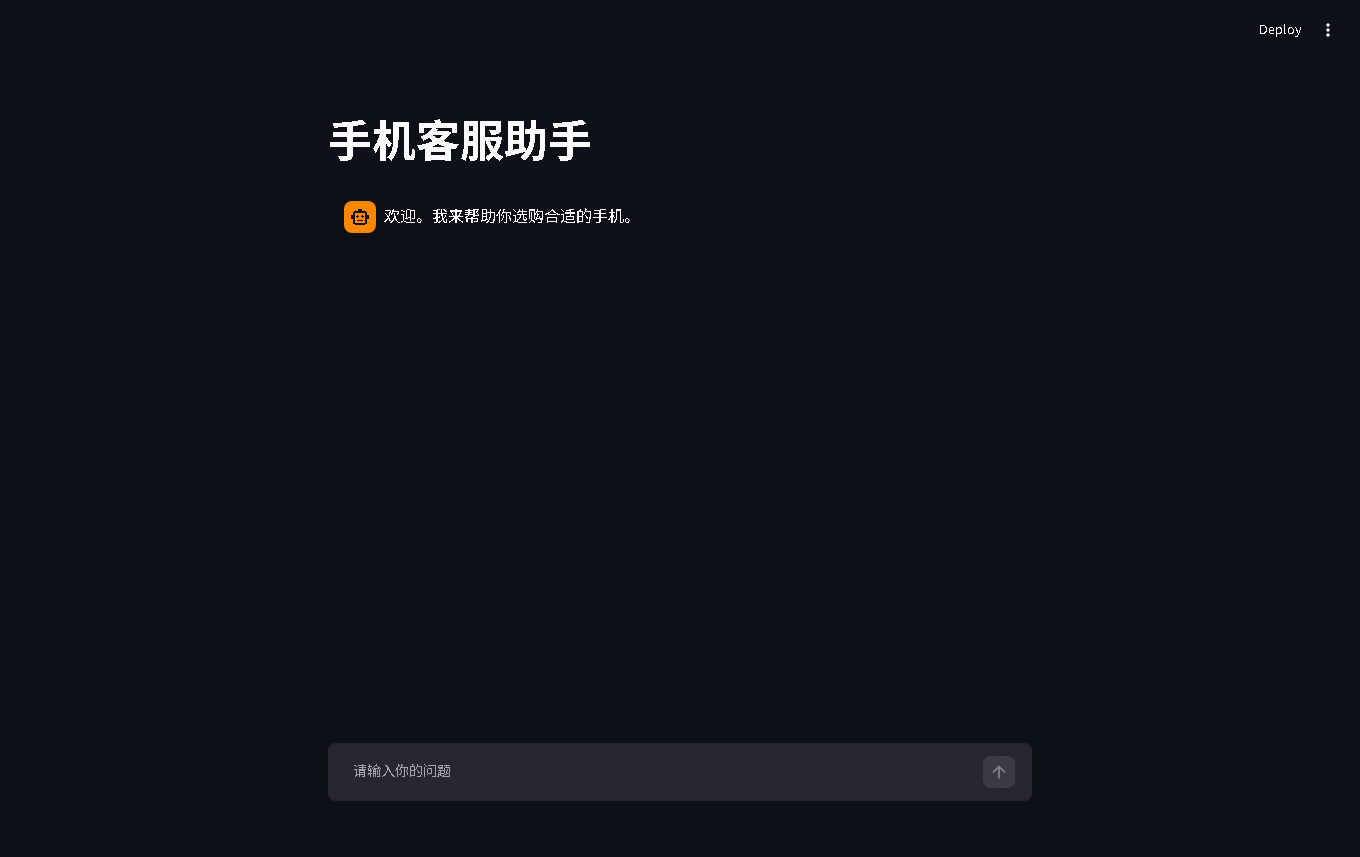
app.py 运行后的 Streamlit 初始界面——标题"手机客服助手",一条欢迎语"欢迎。我来帮助你选购合适的手机。",底部输入框提示"请输入你的问题"。
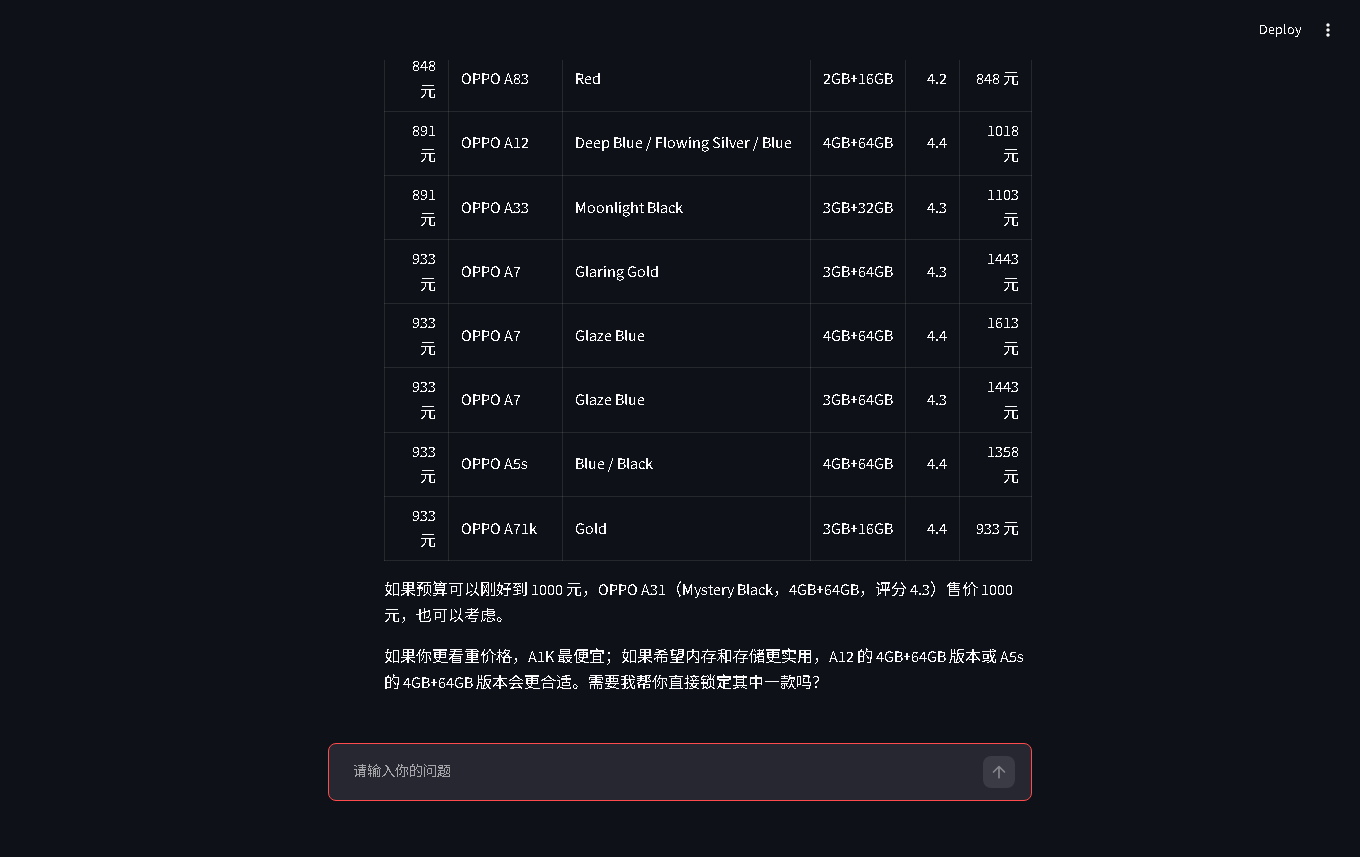
用户提问后的对话界面——用户问"推荐 1000 元以下的手机",助手以表格回复多款真实机型(如 OPPO Neo 5 424元、OPPO A12 4GB+64GB 933元)并给出选购建议。
案例B 代码骨架
提示词:把城市专家换成品牌专家
我有一套"多文档路由"的骨架:每个文档建一个带向量工具和摘要工具的专家智能体,顶层再用对象索引路由。现在数据源换成了三个品牌的型号 txt,请把数据源换掉,智能体与路由结构一行不动。
第二轮对话:把演示问题换成品牌对比
骨架通了,最后请把内置的演示查询换成"对比 OPPO 和小米的主力机型",让顶层智能体自动路由到两个专家。
def main(): lLM = build_llm(temperature=0) Settings.llm = lLM Settings.embed_model = build_embed_model() specialists, router_agent = create_brand_agents(lLM) # 演示问题换成品牌对比 response = router_agent.query("对比 OPPO 和小米的主力机型") print(response)
顶层智能体通过 ObjectIndex 把问题路由到 OPPO 与 Xiaomi 两个专家工具,各取出机型数据后综合成对比。
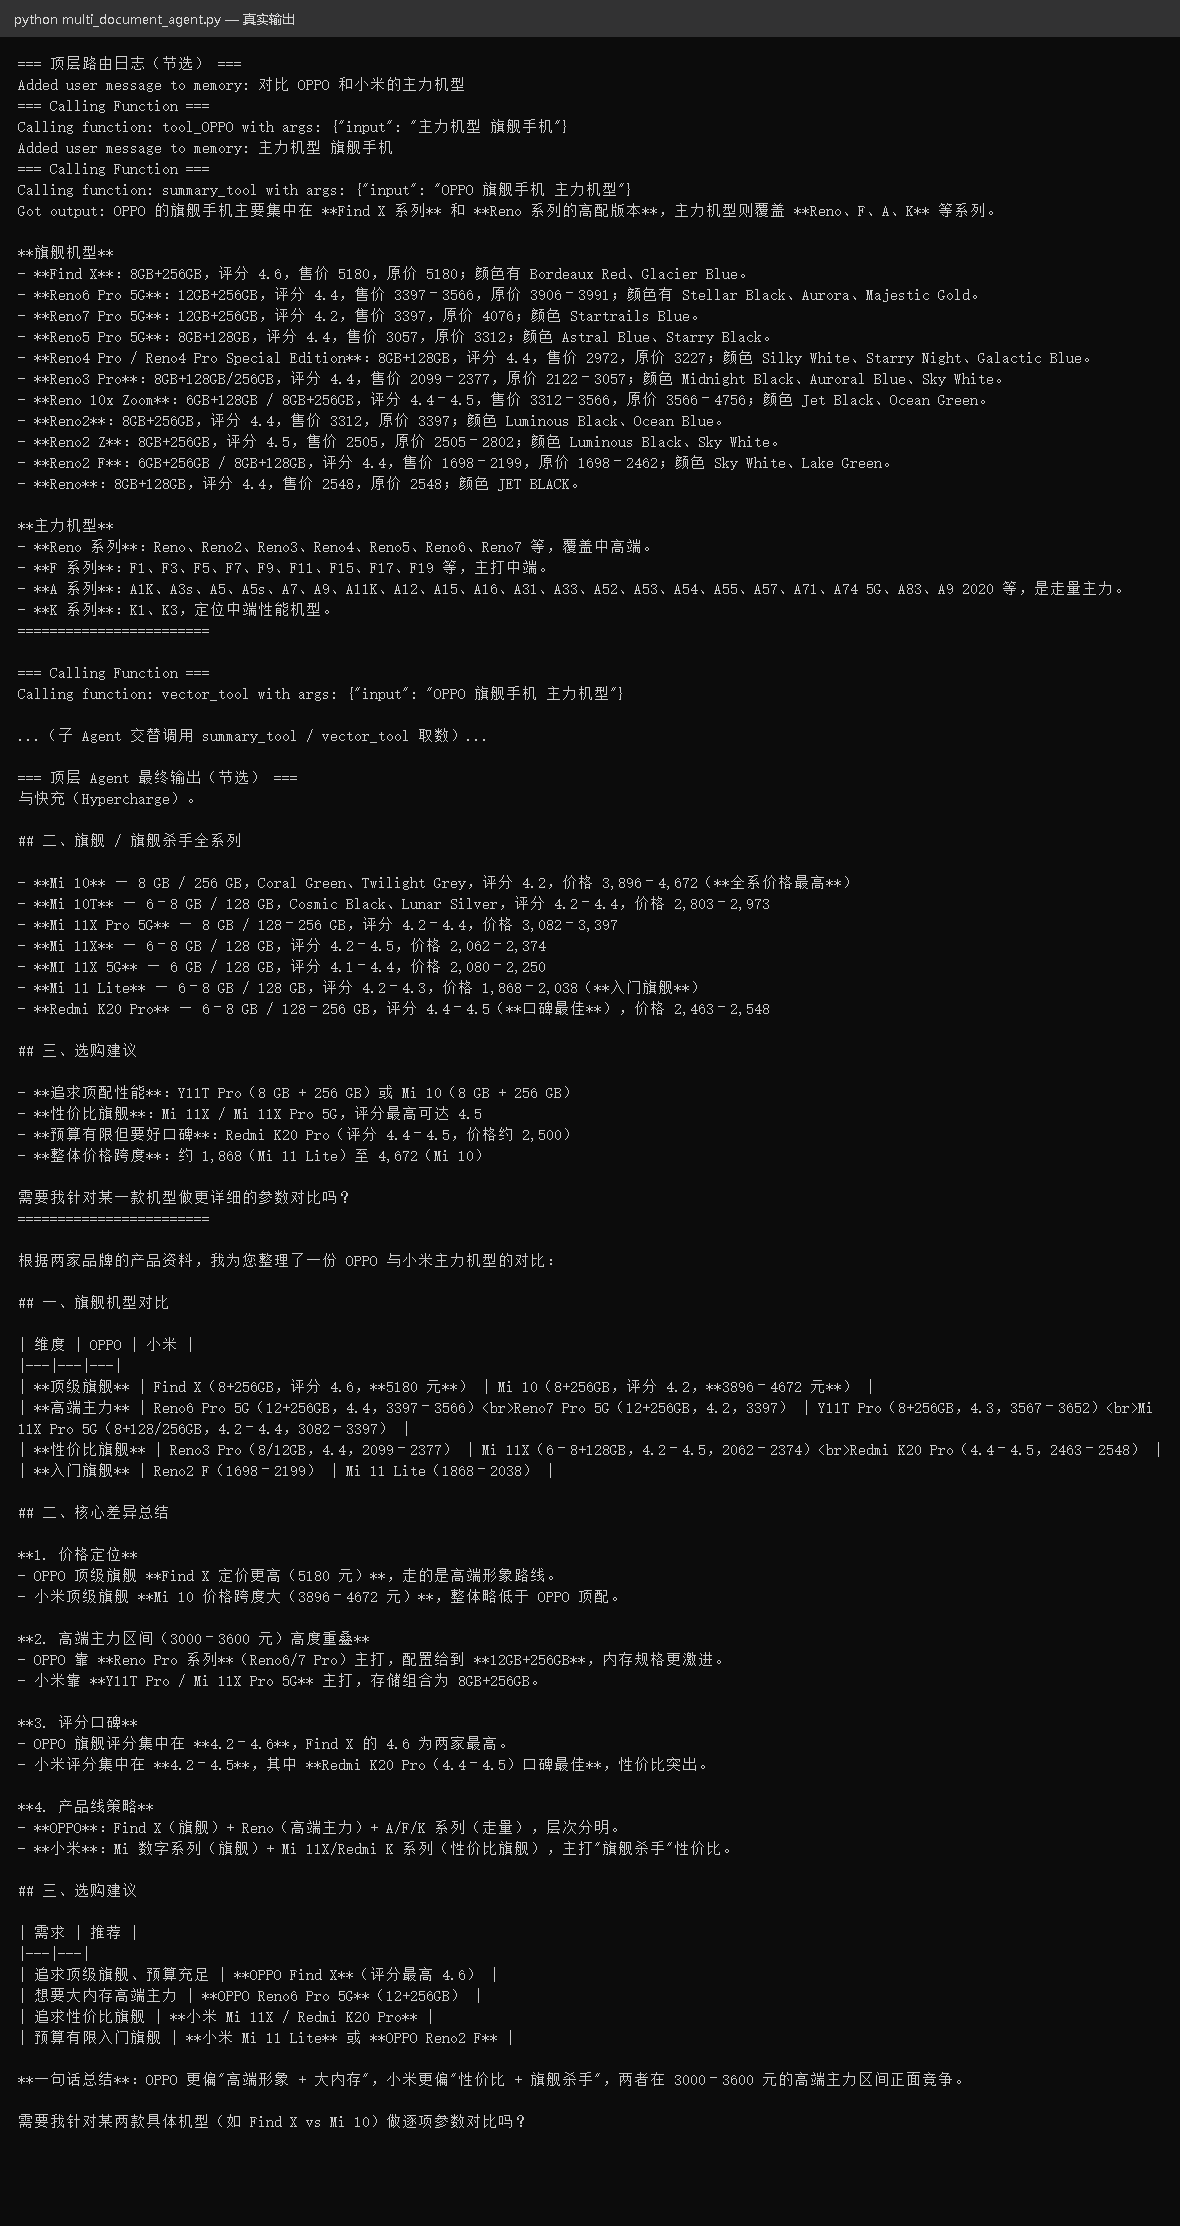
案例B 运行终端——上半部是顶层路由日志,可见 "Calling function: tool_OPPO" 与后续 tool_Xiaomi 的取数调用;下半部是对比结果,含 OPPO Find X(8+256GB,5180 元)与小米 Mi 10(8+256GB,3896–4672 元)等真实数据。
案例C 代码骨架
提示词:把假数据换成真查表
我有一套多智能体编排的骨架,里面"查商品"的工具现在是直接返回一段假数据。请把它改成真读机型 CSV,其余智能体一字不动。
提示词:处理品牌前缀
测试发现用户说「OPPO A53」查不到,说「A53」反而能查到。请修正匹配逻辑——注意 CSV 的型号列只有短型号,不含品牌前缀。
# 关键:在 "Brand + Model" 的组合串上匹配,既能命中 "A53" 也能命中 "OPPO A53"。full = (_PHONE_DF["Brand"].astype(str).str.strip() + " " + _PHONE_DF["Model"].astype(str).str.strip()).str.lower()
多两步走完后,还要把真查表的函数注册成智能体的工具。背景是现有编排骨架里每个子智能体都靠 FunctionTool 注册能力;目标是让新写的查表函数以工具形式接入查机型智能体,其余子智能体保持原样;约束是沿用现有的注册写法,不新增额外工具。接下来就是这一段注册片段:
案例C 编排流程(不变)
while True 循环 → 编排智能体决定 next_speaker → 对应 agent.chat() → 更新共享 state。
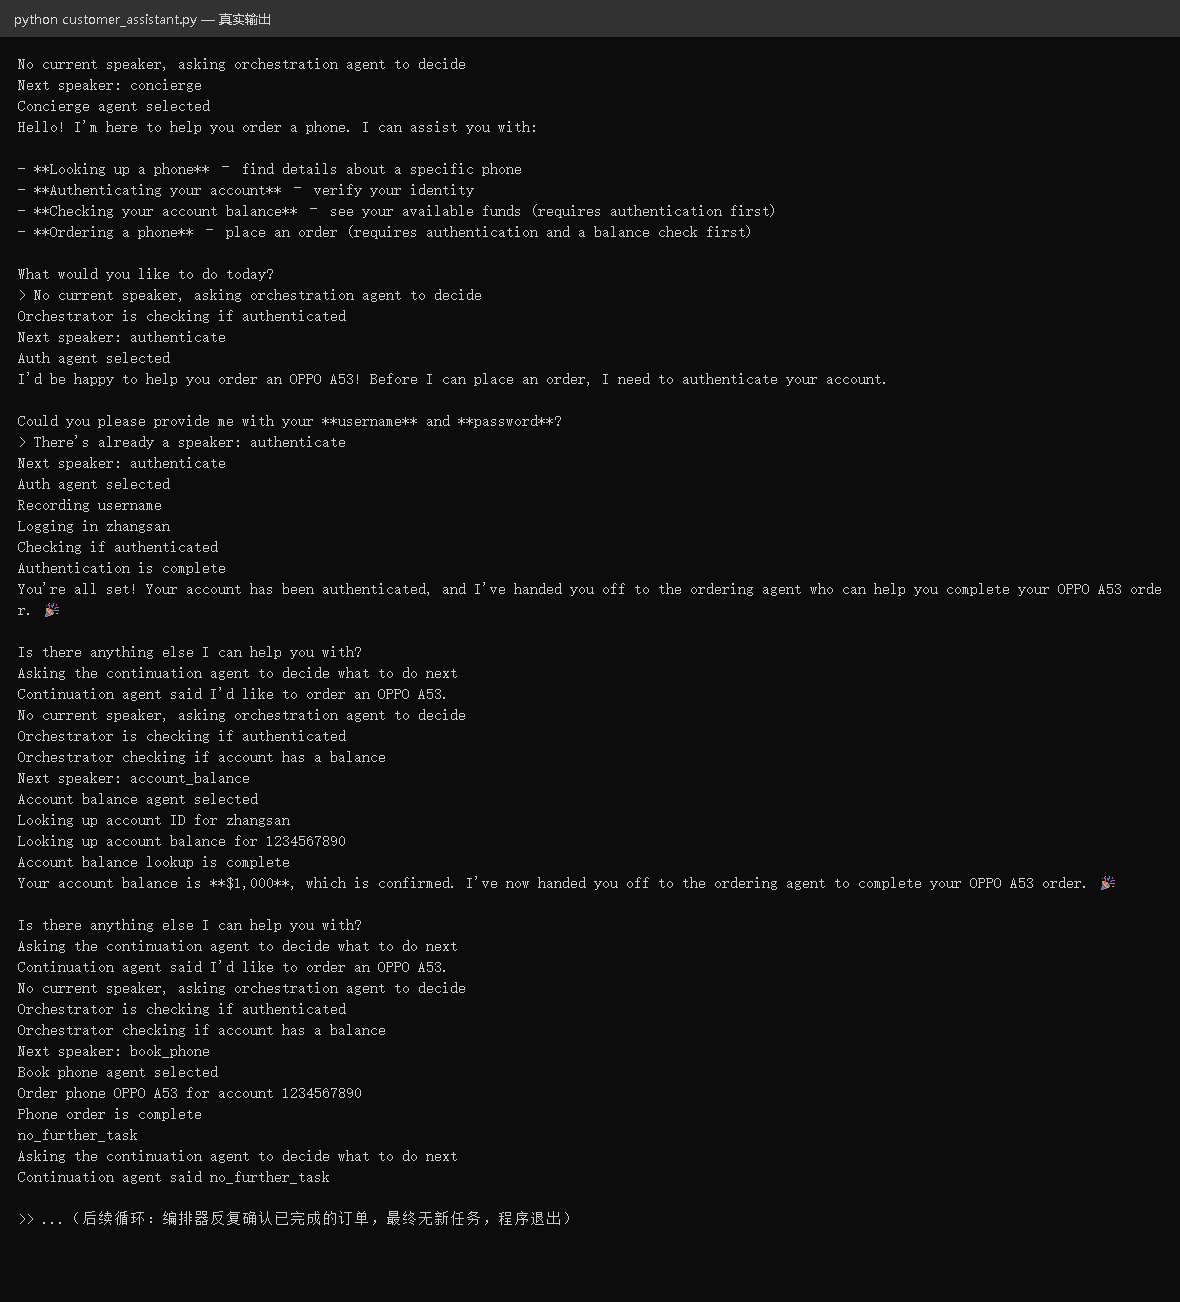
案例C 命令行交互——终端从上到下可见:引导智能体引导、认证智能体记录用户名 zhangsan、查余额智能体查出 $1000、下单智能体打出 "Phone order is complete",以及 "Next speaker:" 路由日志。
可测试页面版本
.streamlit/secrets.toml:
代码里用 st.secrets 读 key,优先级:环境变量 > secrets.toml。这样本地开发写环境变量、部署到云上用 secrets 都行。
配套工具与资源
本教程配套的可复用资源与复现方式如下,均随代码包提供。
- 统一数据集:
data/mobile_phone_info.csv(GBK,3114 行,17 品牌,8 字段) - 品牌数据生成脚本:
generate_brand_data.py - 三案例源码:
app.py、multi_document_agent.py、customer_assistant.py - 共用模型接入层:
common.py - 依赖清单:
requirements.txt(含版本红线注释,见「实验设置与运行环境」) - 可交互前端演示页:
demo/index.html(单文件,零后端)
结论与展望
本文把 LlamaIndex RAG 三案例统一为手机客服 Agent,核心结论有三:其一,统一数据集让三个案例共用一份 mobile_phone_info.csv,产品线扩容时只改数据不改代码;其二,智能体与路由骨架零改动,只替换数据源与话术,迁移成本极低;其三,工具真读业务表后结果可核对,答案不再依赖模型记忆,落地价值在于把"看起来像"的回答替换成"查得出"的答案。
展望方面,这套结构可继续扩展为多品类商品库的客服系统,把"品牌专家"扩展为"品类专家",并把案例C 的下单流程接入真实库存与支付接口。
常见问题 FAQ
1. 手机客服 Agent 跑出 ValueError: No files found in data. 怎么解决?
input_dir 路径错误,或工程放进了点开头的隐藏目录(会被整体跳过)。用 ./data,且别把工程放进以 . 开头的目录。
2. 读取手机机型数据集报 UnicodeDecodeError 是什么原因?
CSV 是 GBK 编码。用 pd.read_csv(path, encoding="gbk")。
3. LookupError: Resource 'stopwords' not found 怎么办?
默认分词器依赖外部语料包,离线拿不到。传 chunking_tokenizer_fn 按行切分,或本地放好语料包。
4. ImportError: cannot import name 'OpenAIAgent' 怎么修?
依赖库升到了 0.13+ / 相关包 0.5+。锁 llama-index-core==0.12.52 + llama-index-agent-openai==0.4.12。
5. Windows 控制台报 UnicodeEncodeError: 'gbk' codec 怎么办?
控制台是 GBK,智能体输出含 emoji 会崩。脚本头加 sys.stdout.reconfigure(encoding="utf-8", errors="replace"),或先设 PYTHONIOENCODING=utf-8。
6. 初次启动很慢正常吗?
初次构建向量索引要跑一遍嵌入计算。案例B 已把索引持久化到 storage/,后续直接加载。
7. 案例C 查「OPPO A53」查不到?
型号列只有 A53,不含品牌。在"品牌 + 型号"组合串上匹配即可。
8. 装包很慢或中途断开?
直连镜像慢,加 -i https://pypi.tuna.tsinghua.edu.cn/simple。
9. 手机客服 Agent 的多智能体路由是怎么工作的?
案例B 用 ObjectIndex 把三个品牌专家工具建成对象索引,顶层智能体按问题检索到最相关的品牌工具,再调用对应专家取数;案例C 则用编排智能体按状态决定下一个 sub-agent。
10. 这份手机机型数据集能直接换成别的商品库吗?
可以。只要保持"一行一条商品配置"的口径并相应调整字段,三个案例的数据源替换即可复用,智能体与路由骨架无需改动。
参考文献与延伸阅读
原文未附参考文献与外部延伸链接。
附录
项目目录结构、运行命令与流程图见上文各节;完整代码以代码包实际接口为准。
作者声明
作者系数据挖掘方向分析师,长期从事检索增强生成与多智能体系统的工程落地,拥有多年数据分析经验,专注 Python 与机器学习算法实践。
 2026个人超级智能与OPC白皮书:OPC赛道与AI渗透 | 附100+报告、数据合集下载
 LlamaIndex多模态与知识图谱餐饮知识库问答Agent
 Python Streamlit外汇统计套利系统:Logistic与Ridge回归,均值回归与机器学习增强 附Agent教程
 开发LSTM、CNN模型预测玉米期货价格与涨跌可交互 Agent