LlamaIndex 多模态与知识图谱餐饮知识库问答Agent
客户手里散落着大量门店物料,有扫描件、有手机拍的宣传图、也有活动文案,他们想知道能不能把这些形态各异的东西,统一收进一个能问、能查、能推理的知识库。
成为新会员获取本项目完整工程、代码、数据和AI智能体
LlamaIndex 多模态抽取与属性图索引合二为一的知识库问答 Agent:图片/PDF 进、六字段出;文本进、实体关系图出;同界面并排对比两引擎。附真实截图与零后端演示页,一条命令跑通。
LlamaIndex 多模态与知识图谱餐饮知识库问答Agent
多模态抽取 + 属性图双引擎,附可运行工程Agent、真实截图
Contents
- TL;DR
- 摘要与关键词
- Abstract & Keywords
- 研究背景与痛点
- 技术方案总览
- 数据来源与预处理
- 核心方案设计
- 方法细节与参数
- 实验设置与运行
- 测试结果与对比
- 局限性与失败分析
- 系统实现与落地
- 配套工具与资源
- 结论与展望
- 常见问题 FAQ
- 参考文献与延伸阅读
- 附录
多模态抽取 + 属性图双引擎,附可运行工程、真实截图与纯前端演示页
TL;DR
摘要与关键词
摘要:本文回答五个问题:如何把图片、PDF 里的餐厅信息抽成统一字段;如何把一段餐厅文本建成可推理的知识图谱;多模态抽取与图谱问答各擅长什么;两者如何在一个界面里并排对比;怎样用一条命令把工程跑起来。做法是用 LlamaIndex 的 多模态大模型 与属性图索引搭建双引擎,并用 Streamlit 收敛为一个可交互智能体,配合内置样例与离线嵌入,让没有密钥的读者也能先跑通界面。本文将多模态抽取与属性图建模经验封装为一个对话式 AI Agent 和可复用的 skill。
关键词:LlamaIndex;知识库问答 Agent;多模态抽取;属性图;知识图谱;检索增强生成(RAG);Streamlit
Abstract & Keywords
Abstract: This article answers five questions: how to extract unified fields from restaurant images and PDFs; how to build a reasoning-ready knowledge graph from restaurant text; what multimodal extraction and graph question answering are each good at; how to compare them side by side in one interface; and how to run the whole project with a single command . The approach uses LlamaIndex's multimodal large model and property graph index to build a dual engine wrapped into an interactive agent with Streamlit. Built-in samples and offline embeddings let readers without an API key run the interface first.
Keywords: LlamaIndex; Knowledge-base QA Agent; Multimodal Extraction; Property Graph; Knowledge Graph; Retrieval-Augmented Generation (RAG); Streamlit
本项目完整工程、代码、数据和AI智能体
一、研究背景与痛点
客户手里散落着大量门店物料,有扫描件、有手机拍的宣传图、也有活动文案,他们想知道能不能把这些形态各异的东西,统一收进一个能问、能查、能推理的知识库。这是很典型的现实需求。
本文把一个知识库问答 Agent 的两个原本各跑各的示例收敛成一个讲得清故事的交互界面:一边是图片与 PDF 进去、结构化字段出来的多模态解析,另一边是文本进去、实体关系图出来的属性图问答。两者原本分属两个工程、两套依赖、两条命令行,我们把它们统一到同一个「餐饮」域,让读者一次就能对比它们各自的长处。
本文完整代码、数据与配套 AI Agent 、skill 请阅读原文链接获取。
痛点集中在三点:多模态那个示例已经是 Streamlit,但它是单链路的——图片进来、字段出去、落库,跟图谱毫无关系;属性图那个示例则是命令行脚本,数据目录、查询语句全部写死在源码里,想换个问题就得改代码、重跑。读者想验证「多模态抽取」和「图谱问答」在同一批餐厅资料上谁更好用,得开两个项目、装两套依赖、记住两条命令行。
| 能力 | 原来(两个静态示例) | 做成知识库问答 Agent 后 |
|---|---|---|
| 换数据 | 改源码里的路径后重跑 | 界面里上传 / 选内置数据集 |
| 换问题 | 改第 62/73 行的查询字符串 | 输入框里打一句就查 |
| 看图谱 | 打开生成的 pg.html | 界面内直接渲染图 |
| 对比两引擎 | 分别跑两个项目、人工对照 | 同一问题左右并排出结果 |
| 用哪套环境 | 两套依赖、两条命令 | 一条 streamlit run |
二、技术方案总览
本文的核心方案是「双引擎 + 一界面」:数据准备之后,分别进入多模态抽取引擎与属性图引擎,前者产出六字段并入库,后者产出图谱并支持检索问答,最后在双引擎对比页同屏并排。整体数据流如下:
数据准备 | v 多模态抽取引擎 |+-----+-----+ | | v v 六字段入库 图谱构建 | |+-----+-----+ | v 双引擎对比 | v 界面落地
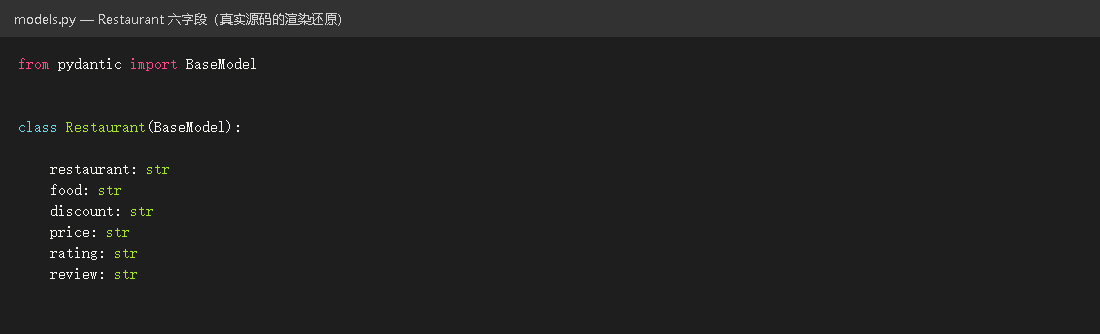
原文其实是两条独立流水线。流水线 A 是多模态解析:图片 / PDF 经多模态大模型得到 Restaurant 六字段,再写入入库表;PDF 只取首页转图,图片按 RGB 打开,抽取用 Pydantic 输出解析器约束结果。流水线 B 是属性图:文本语料经目录读取、属性图索引得到图存储,再供检索与问答使用,抽取器一个按顺序造边、一个让大模型抽语义关系。
入库表契约(ddl.sql):
CREATE TABLE neatapp( id serial primary key, payload jsonb not null, image_path text not null, created_timestamp timestamp not null);
原文事实(逐条抄准,后文所有数字以此为准)
| 项 | 值 |
|---|---|
| Restaurant 字段数 | 6(str) |
| 入库表 | neatapp(payload jsonb / image_path text / created_timestamp timestamp) |
| 建图大模型 | gpt-4o |
| 嵌入模型 | OpenAIEmbedding() |
| 图谱抽取器参数 | num_workers=4、max_paths_per_chunk=10 |
| 多模态大模型 | gpt-4-turbo |
内置样例(EXAMPLE_RESPONSE) | food="8 Wings or Chicken Poppers"、discount="Black Friday Offer"、price="$8.73" |
本次要做的改造(统一到「餐饮」域)
| 位置 | 改前 | 改后 |
|---|---|---|
| 图谱脚本数据目录 | 读取人物履历语料目录 | 读取餐厅语料目录 ./data/restaurant/ |
| 图谱脚本查询 | 「苏轼的履历是怎么样的?」 | 「汉堡王有哪些产品和优惠」 |
| Neo4j 版脚本 | 人物传记语料与英文查询 | 同步改为餐厅域 |
| 图谱脚本观测 | 引入观测库并另起服务 | 删除,降低复现门槛 |
观测服务会另起一个进程,对只想跑通检索的读者是纯负担。删掉它,图谱脚本就只剩「读数据 → 建图 → 查」三件事。
最受欢迎的见解
- Python员工数据人力流失预测:ADASYN采样CatBoost算法、LASSO特征选择与动态不平衡处理及多模型对比研究
- R分布式滞后非线性模型DLNM分析某城市空气污染与健康数据:多维度可视化优化滞后效应解读
- Python古代文物成分分析与鉴别研究:灰色关联度、岭回归、K-means聚类、决策树分析
- Python TensorFlow OpenCV的卷积神经网络CNN人脸识别系统构建与应用实践
- Python用Transformer、SARIMAX、RNN、LSTM、Prophet时间序列预测对比分析用电量、零售销售、公共安全、交通事故数据
- MATLAB贝叶斯超参数优化LSTM预测设备寿命应用——以航空发动机退化数据为例
- Python谷歌商店Google Play APP评分预测:LASSO、多元线性回归、岭回归模型对比研究
- Python+AI提示词糖尿病预测模型融合构建:伯努利朴素贝叶斯、逻辑回归、决策树、随机森林、支持向量机SVM应用
三、数据来源与预处理
统一数据集就三样,全部来自多模态示例的数据目录:
| 文件 | 类型 | 内容(实测识别) |
|---|---|---|
burger_king.pdf | 扫描页(无文本层) | BURGER KING / Plant-Based WHOPPER / 2 FOR P150 / #DontTasteTheDifference |
fried_chicken.png | 图片 | BLACK FRIDAY OFFER / 8 WINGS OR CHICKEN POPPERS / 原价 10.73→8.73 |
pizza.jpeg | 图片 | Domino's / THE BIG NIGHT IN DEAL / £23.99 / 2 MEDIUM PIZZAS 套餐 |
关键事实: burger_king.pdf 是扫描件,直接抽取文本得到的是 0 长度,必须走多模态识别。两张菜品图里的 8 Wings or Chicken Poppers / Black Friday Offer / $8.73 正好等于内置样例,说明这就是原仓库的示例配图。
图谱语料把扫描页的信息转成句子,存成 data/restaurant/restaurant.txt,方便大模型抽关系:
汉堡王(BURGER KING)是一家快餐连锁餐厅。汉堡王提供 Plant-Based WHOPPER 汉堡。汉堡王当前有优惠:2 FOR P150,包含 1 个 Plant-Based Whopper Jr. 和 1 个 Whopper Jr.。汉堡王的宣传语是 #DontTasteTheDifference。汉堡王可通过 Take out、Drive-thru、GrabFood、foodpanda 购买。
字段规范:六字段全部字符串,缺失就填 Not Available。
数据展示:
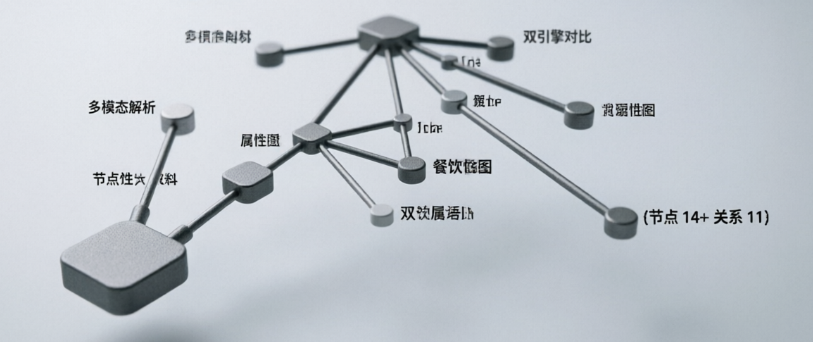
LlamaIndex多模态知识库数据结构与来源总览
四、核心方案设计
4.1 骨架:两段式界面
两段式是这个知识库问答 Agent 的骨架:侧栏收参 → 主区先渲染输入区 → 条件不满足就提前返回停下 → 满足才渲染结果区。
提示词一
背景:我在做一个餐饮知识库的界面,参数要从左侧统一收,业务结果放右侧主区。
目标:请你帮我用 Streamlit 搭一个两段式骨架,先把参数收齐,缺关键参数就先停住。
约束:侧栏只放参数控件,不放业务结果;主区用三个标签页;缺密钥且未开演示时,给出引导文字并停止后续渲染。
提前返回让脚本优雅早退,避免下游拿到空密钥后抛一堆错;侧栏只看参数,这是 Streamlit 的通用约定。
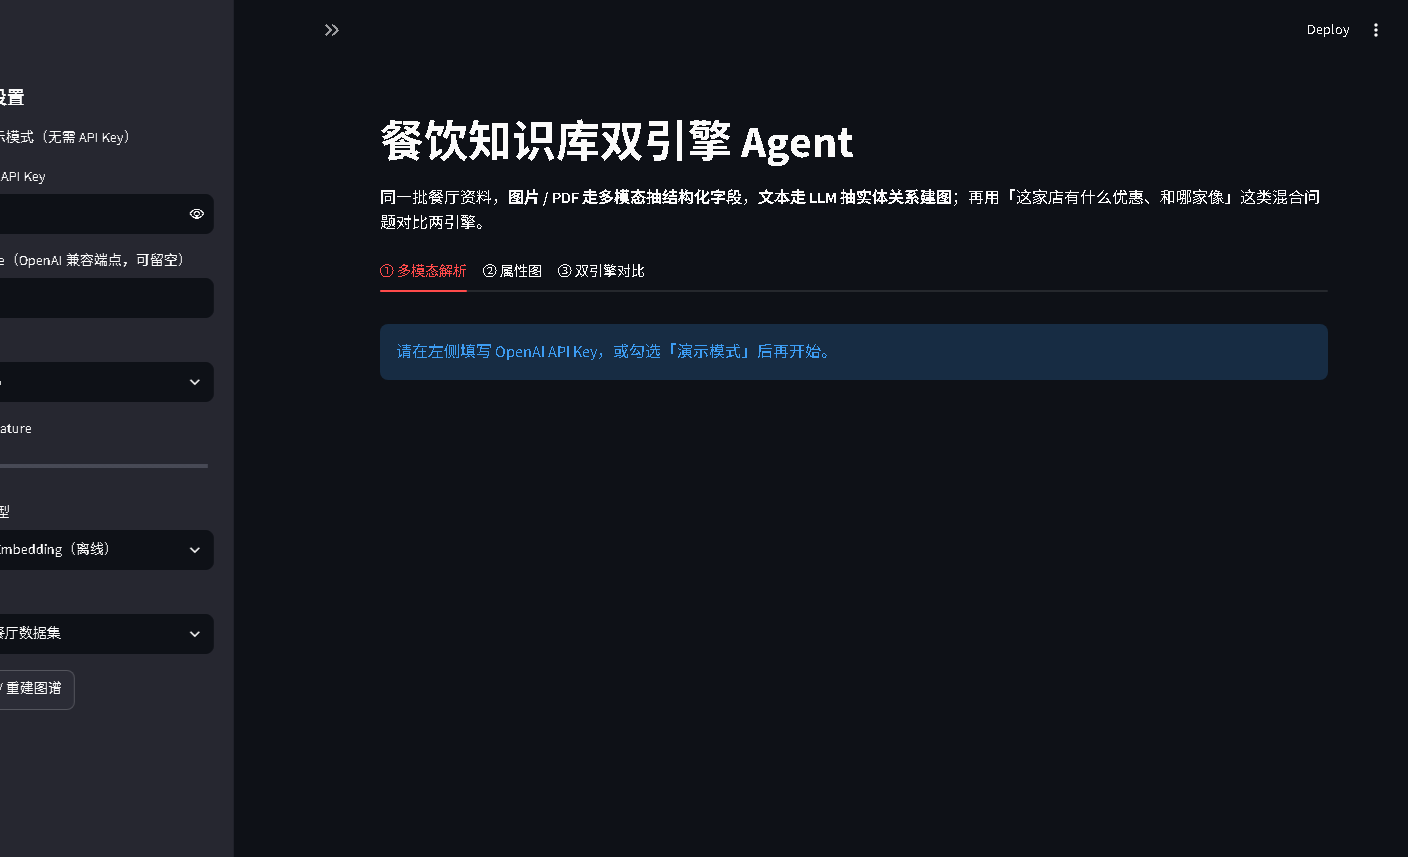
LlamaIndex知识库问答Agent未填密钥时的初始界面
初始界面(未填密钥),左栏可见设置控件与构建按钮,主区显示三个标签页,正文区显示蓝色提示「请在左侧填写接口密钥,或勾选「演示模式」后再开始。」。
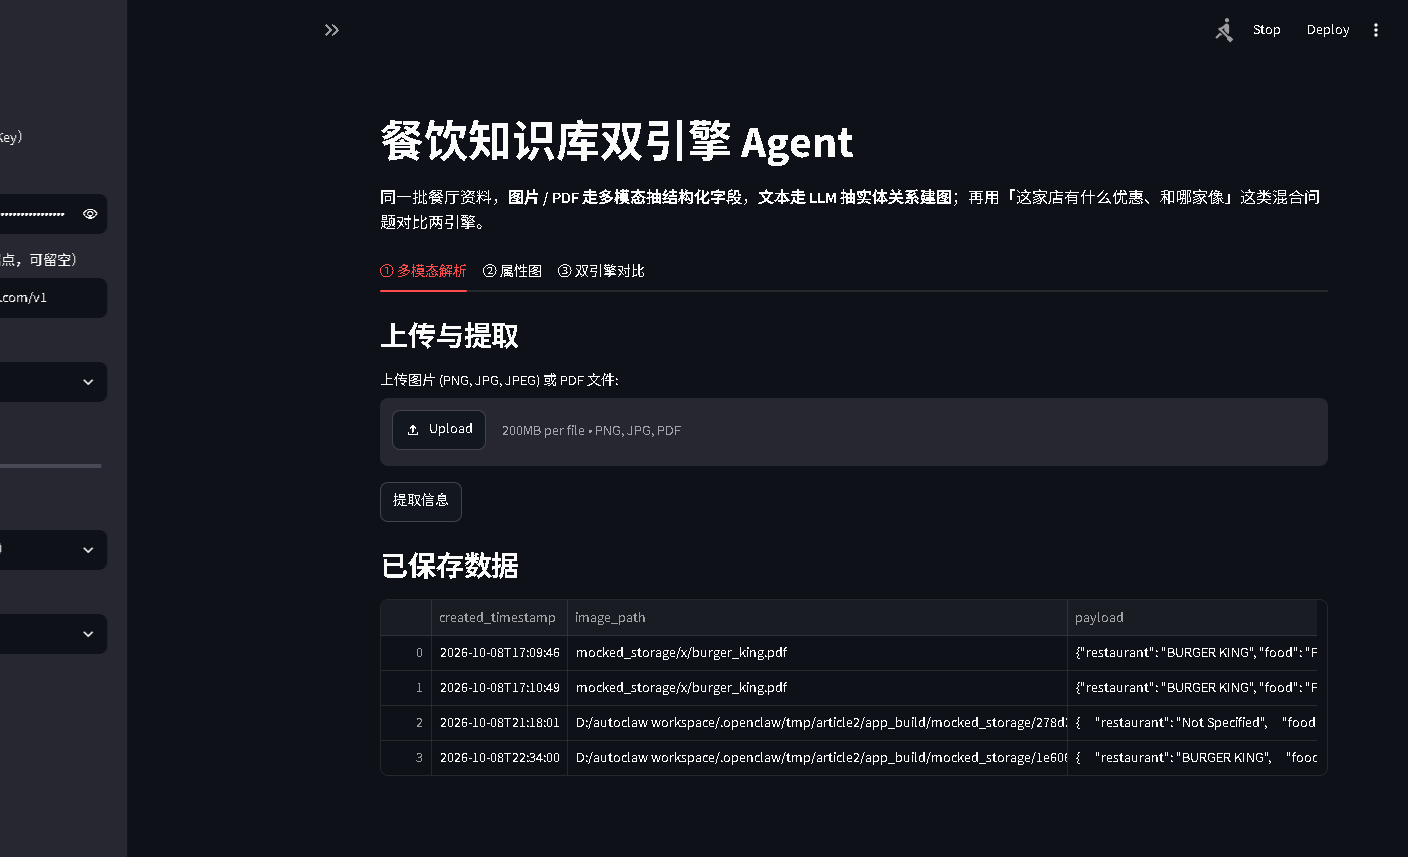
知识库问答Agent侧栏填入密钥与模型选择后的状态
侧栏已填入密钥(密码框显示圆点)与接口地址、模型选择 agnes-2.5-flash 后的状态,蓝色提示消失,控件恢复正常。
4.2 多模态抽取引擎
沿袭多模态示例的逻辑:图片 / PDF → 首页图 → 多模态大模型 → 六字段。
提示词二
背景:我手上有一批门店物料,有图片也有 PDF,字段要统一,方便后面入库。
目标:请帮我写一段抽取逻辑,把图片或 PDF 里的餐厅信息抽成固定六字段。
约束:PDF 只取首页转图,图片按 RGB 打开;用 Pydantic 输出解析器约束输出;缺失项填 Not Available。
抽取函数内部用 Pydantic 输出解析器约束输出:
解析器把「大模型自由发挥的一句总结」压成「严格六字段 JSON」,下游入表才不会错列。
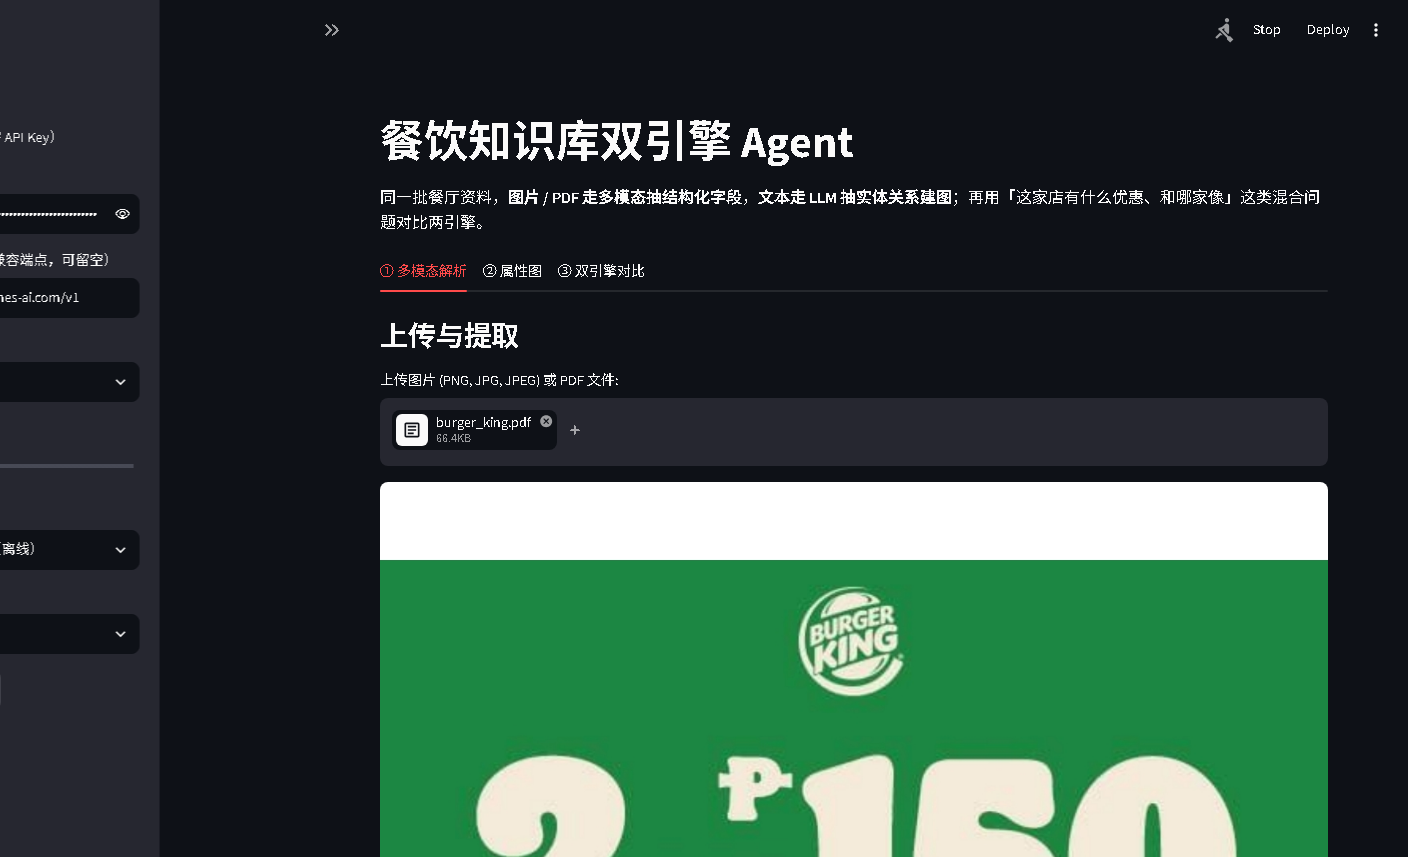
LlamaIndex多模态抽取上传burger\_king.pdf后的整页广告图
① 多模态解析 Tab 中已上传 burger_king.pdf(66.4KB)后,主区显示转换出来的整页广告图(BURGER KING / 2 P150),界面无报错。
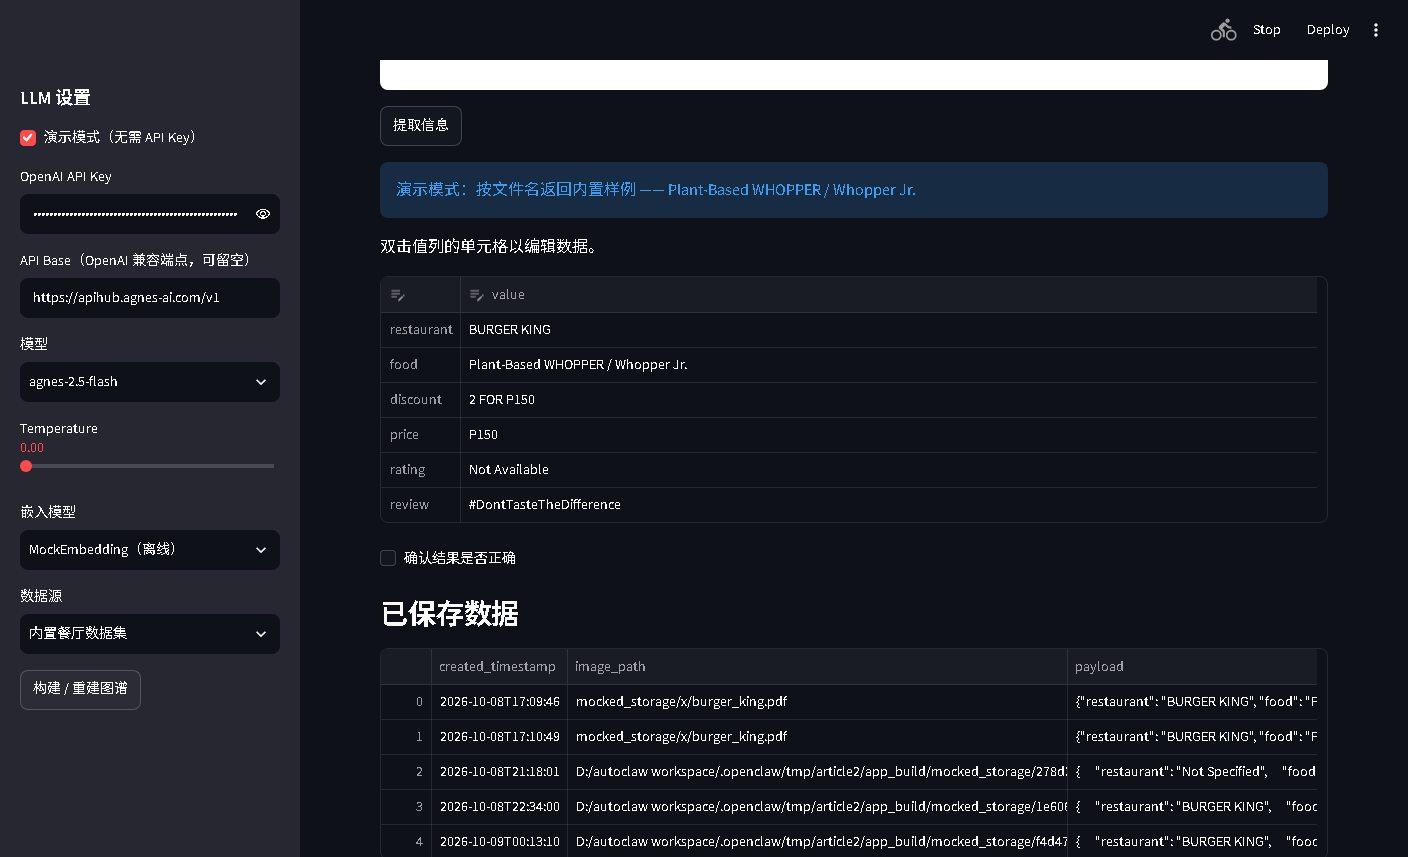
多模态抽取得到的六字段可编辑表格
同一 Tab 点「提取信息」后,出现可编辑表格(restaurant / food / discount / price / rating / review 六行),其中 restaurant=BURGER KING、food=Plant-Based WHOPPER / Whopper Jr.、discount=2 FOR P150、price=P150、rating 与 review=Not Available;上方有蓝色提示「演示模式:按文件名返回内置样例」。
4.3 入库与读回
提示词三
背景:字段抽出来之后要落库,图片本身也要留档,方便回溯。
目标:请帮我写入库与读回两段逻辑,字段进数据库、图片进目录。
约束:图片存到存储目录下的唯一子目录,数据库只存图片路径与字段内容;读回时按时间列出。
save_row / read_rows(db.py)就是两条 SQL:一条 INSERT INTO neatapp ...,一条 SELECT created_timestamp, image_path, payload FROM neatapp。
图片存到存储目录下的唯一子目录,数据库只存图片路径与字段内容,把大文件和结构化字段分开存,是知识库入库的常规做法。
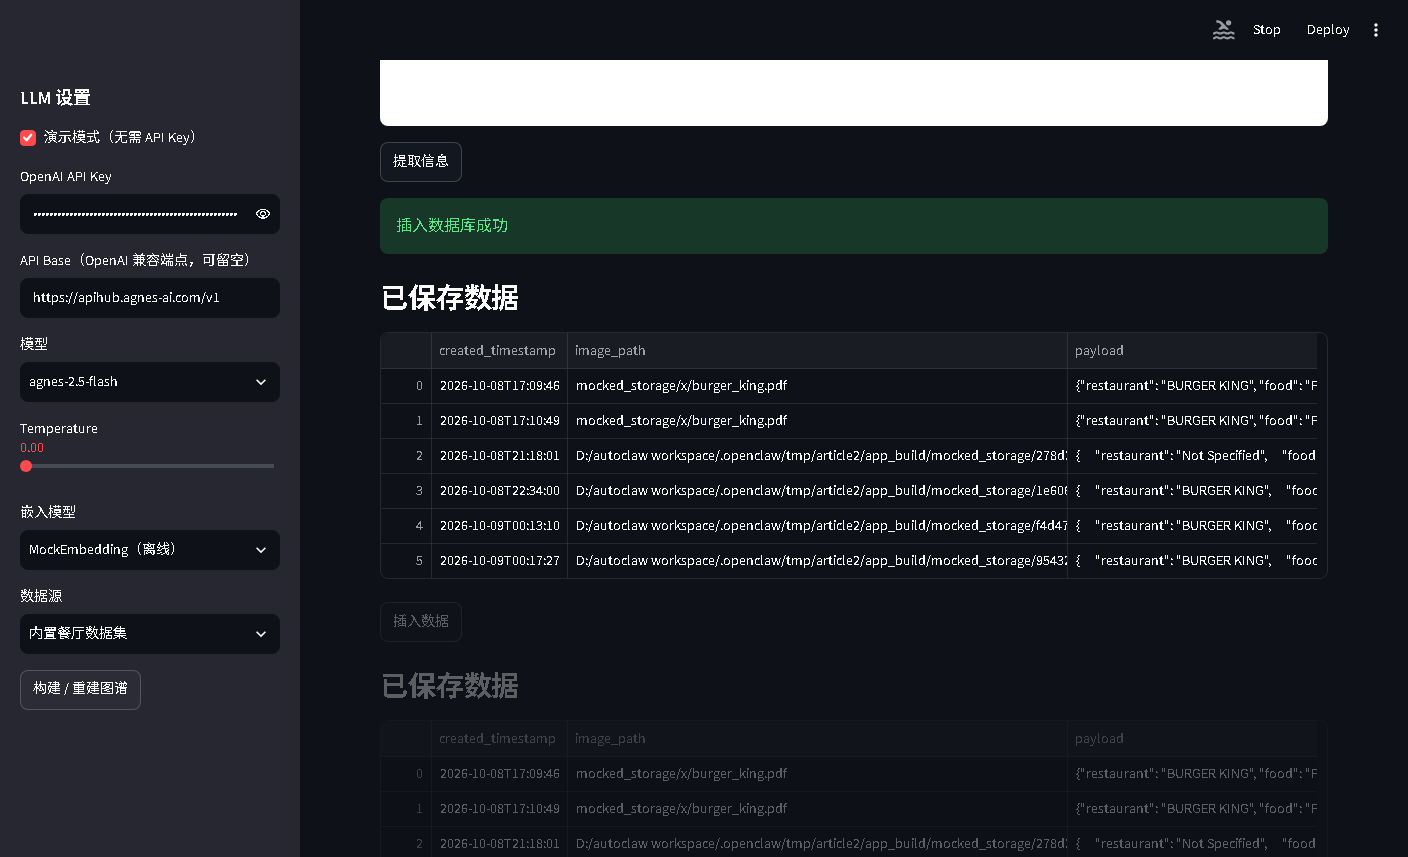
知识库问答Agent插入数据库成功与已保存数据表
① Tab 勾选「确认结果是否正确」并点「插入数据」后的绿色成功提示「插入数据库成功」,下方「已保存数据」区域可见新增一行,columns 为 created\_timestamp / image\_path / payload。
4.4 属性图引擎
这是改动最大的地方:把原来的建图逻辑抽成函数,数据目录与查询改成餐厅域,并删掉观测服务。
提示词:基础图谱构建
背景:我有一段餐厅文本,想先把它建成一个能推理的知识图谱。
目标:请帮我写建图函数,并把它持久化,下次直接加载。
约束:用属性图索引,抽取器先用一个按顺序造边的,够我先看到骨架;有持久化目录就直接加载。
# 案例B:先建骨架def make_graph(store_dir="./storage"):if not os.path.exists(store_dir): docs = DirReader('./data/restaurant/').load_data() # ← 第30行:原为人物履历目录 idx = PgIndex.from_documents( docs, llm=chat_llm, embed_model=embed_model, kg_extractors=[ImplicitExtractor()], show_progress=True, ) idx.storage_context.persist(persist_dir=store_dir)else: sc = StorageContext.from_defaults(persist_dir=store_dir) idx = load_index_from_storage(sc)return idx
提示词:引入领域知识约束(补语义关系 + 删除观测)
背景:骨架有了,但只有顺序关系,语义关系(比如「有什么优惠」「支持哪些渠道」)还没抽出来。
目标:请在图谱抽取器里再加一个让大模型抽语义关系的抽取器,并把观测服务删掉。
约束:语义抽取器并发设为 4、每块最多抽 10 条;不引入任何观测类依赖。
顺序抽取器负责「顺序关系」,语义抽取器负责「语义关系」,两个叠起来图才既有骨架又有血肉。改成餐厅语料目录后,整张图就从「人物履历」切换到了「汉堡王的产品与优惠」。
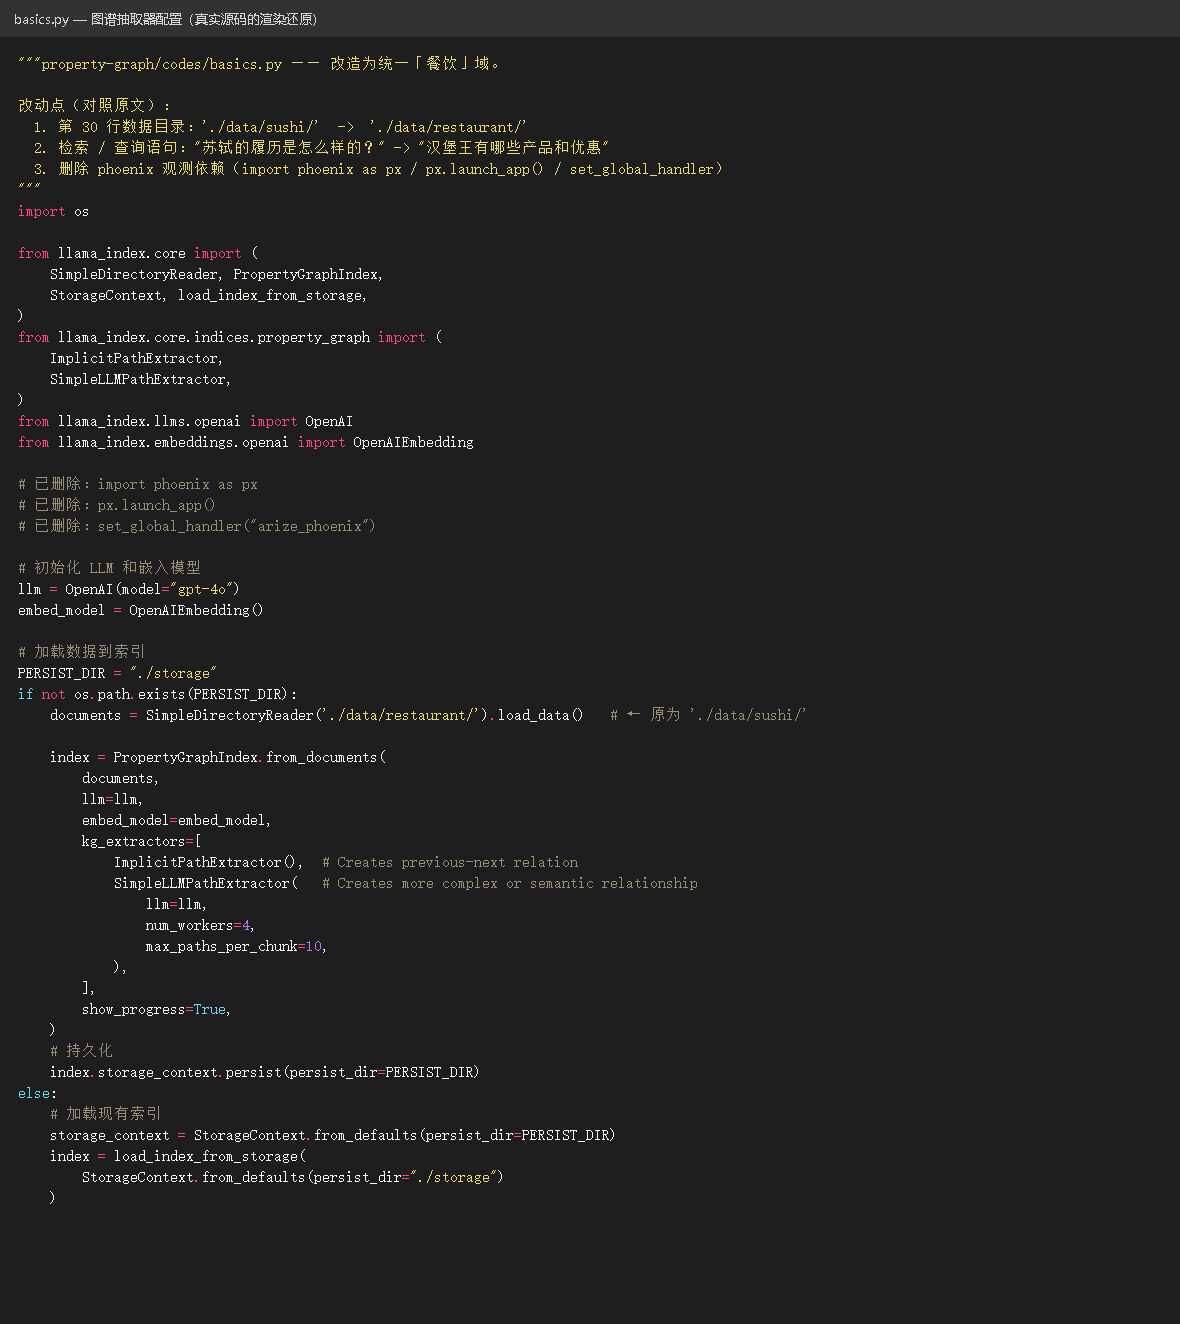
LlamaIndex属性图索引抽取器配置代码
代码片段截图,显示改造后的图谱抽取器配置 kg_extractors=[ImplicitPathExtractor(), SimpleLLMPathExtractor(llm=llm, num_workers=4, max_paths_per_chunk=10)]。
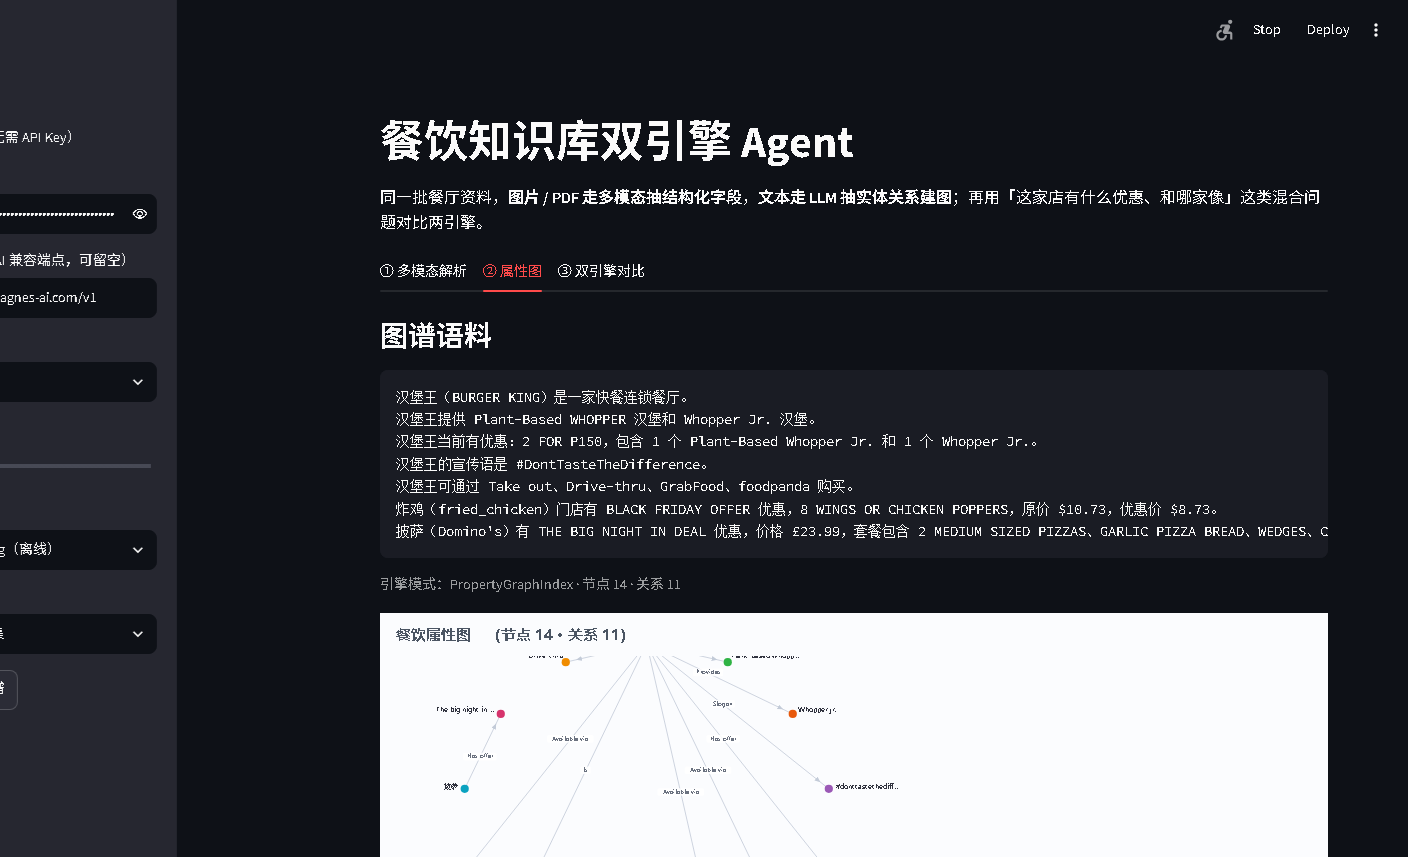
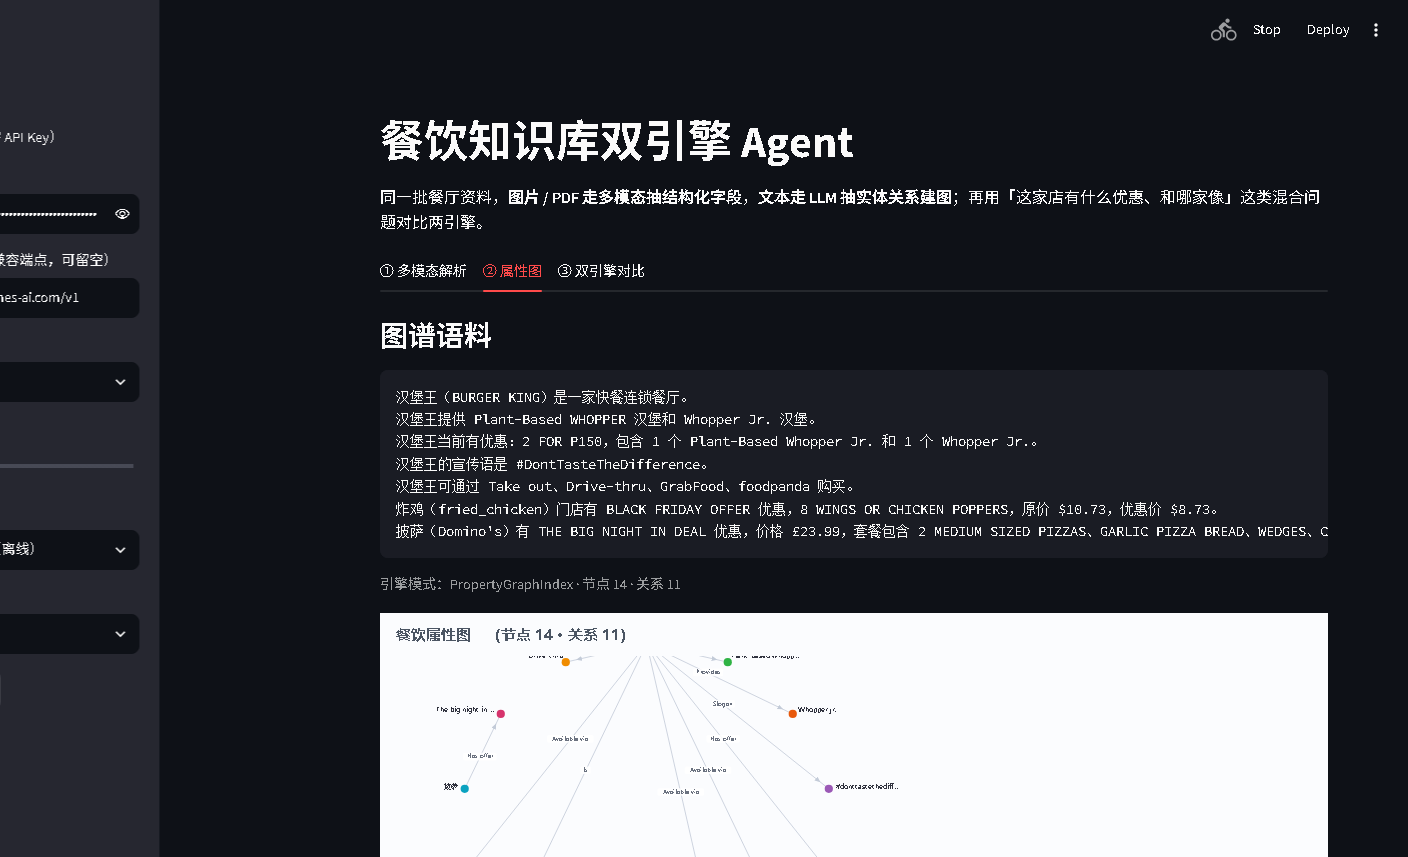
知识库问答Agent属性图Tab与图谱语料概览
② 属性图 Tab,主区显示「图谱语料」文本与已构建的图谱概览,底部标注「引擎模式:PropertyGraphIndex · 节点 14 · 关系 11」。
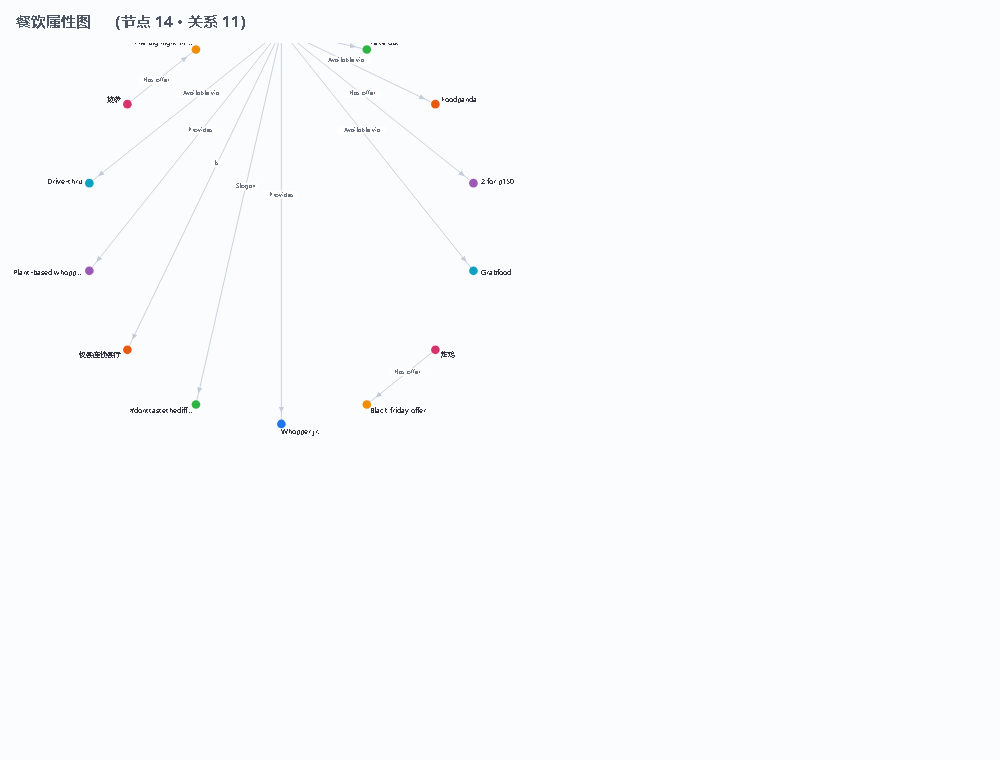
属性图引擎渲染的餐饮知识图谱近景
嵌入显示的图谱可视化近景,节点含「汉堡王」「Plant-based whopper」「2 for p150」「Take out」「Grabfood」等,关系标签为 Provides / Has offer / Available via / Slogan / Is。
4.5 检索与问答
提示词四
背景:图建好了,我要能问它问题,既想看它命中了哪些节点,也想看组织成句的答案。
目标:请帮我写检索与问答两条路径,查询统一用餐厅域的问题。
约束:检索路径不并入源文本,只给命中节点;问答路径并入源文本,给出成句回答。
检索路径给出「命中了哪些节点」,问答路径给出「组织成句的答案」;两者都展示,读者才能看到图谱引擎检索和生成两步分别发生了什么。
属性图引擎命中节点列表与组织成句的回答
② 属性图 Tab 中输入问题「汉堡王有哪些产品和优惠」并点「查询」后,显示命中节点文本(如「汉堡王 -> Provides -> Plant-based whopper」「汉堡王 -> Has offer -> 2 for p150」等)与组织成句的回答。
4.6 双引擎对比
提示词五
背景:我要让同一个问题同时被两个引擎回答,好做对比。
目标:请帮我写一个两栏布局,左边走结构化字段检索,右边走图谱问答。
约束:左栏从入库记录里按字段检索,右栏用图谱问答引擎;两栏并排展示。
结构化检索擅长精确字段,图谱问答擅长关系推理;两栏并排,一眼看出各自的长处。
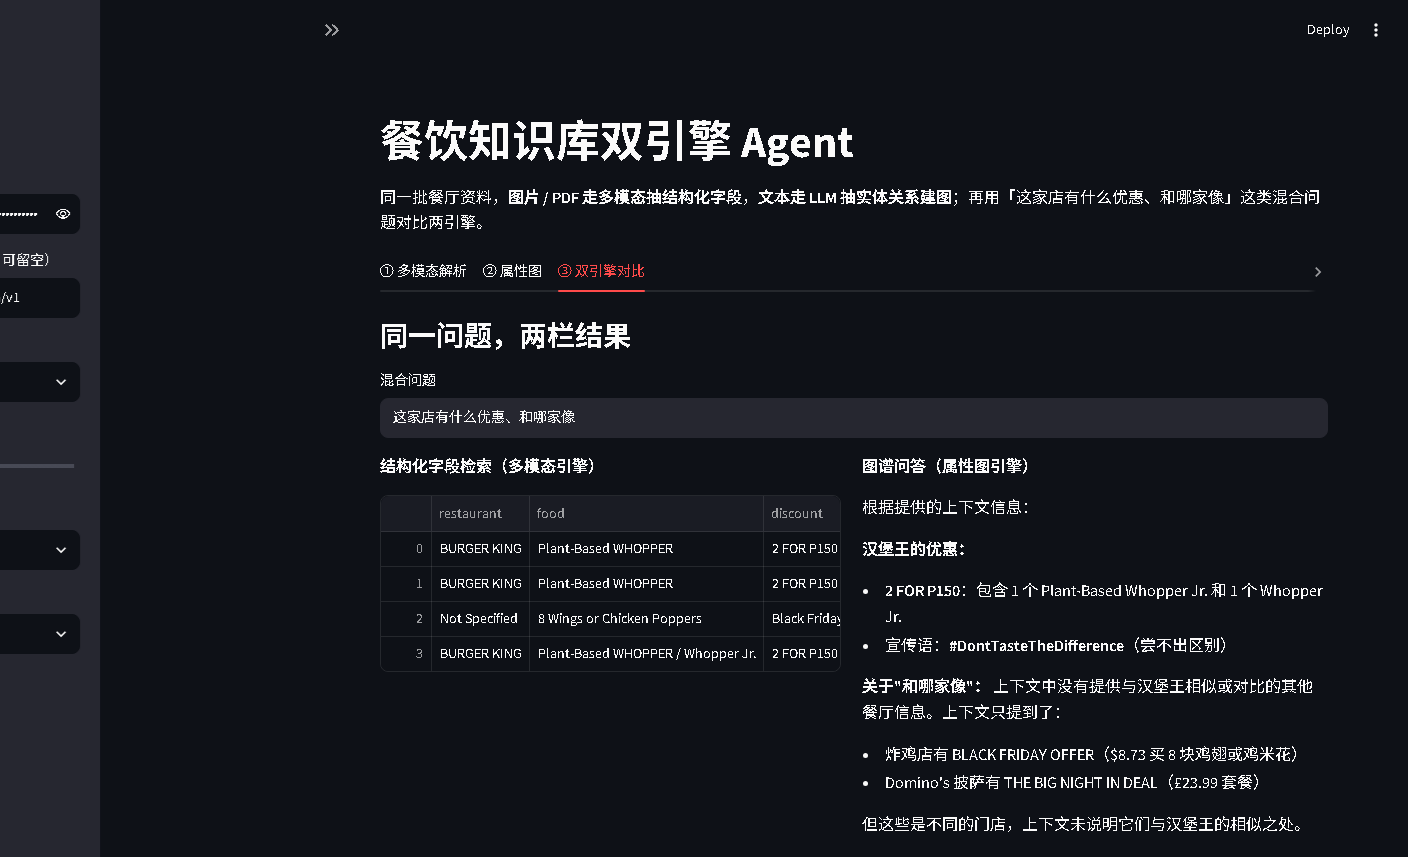
知识库问答Agent双引擎对比页左字段右图谱
③ 双引擎对比 Tab,输入「这家店有什么优惠、和哪家像」后,左栏「结构化字段检索(多模态引擎)」出现 restaurant/food/discount 三列表格,右栏「图谱问答(属性图引擎)」出现由真实图谱生成的一段回答,两栏并排。
五、方法细节与参数
| 参数 | 位置 | 含义 | 调大的后果 |
|---|---|---|---|
| 随机性 | 侧栏 / 抽取 | 大模型随机程度 | 增大→字段抽取更发散,可能编出图里没有的字段 |
| 并发数 | 语义抽取器 | 建图并发 | 增大→建图更快,但接口限流时报错 |
| 每块关系数 | 语义抽取器 | 每个文本块最多抽多少条关系 | 增大→图更密,噪声也更多 |
| 并入源文本 | 检索 / 问答 | 是否把源文本并进结果 | 打开→答案更全,但更长更慢 |
| 模型 | 侧栏下拉 | 建图 / 问答用的大模型 | 换模型会改变建图结果,建议固定再对比 |
红线(服务端硬校验):图谱还没构建就问,或没填密钥就抽字段,都要在服务端拦下来,别把空结果流到下游。
原文脚本没有「未建图就问」的保护,属于命令行场景可以容忍、但智能体场景必须补上的一条红线。
六、设置与运行
用 Python 3.12(该生态在 3.13 上偶有依赖包缺口,3.12 最稳)。
PDF 转图不必单独装外部二进制:原示例用的转换库在 Windows 上必须另装系统组件,否则报缺少可执行文件的错误;这里改用纯 wheel 的渲染库读首页,原转换库仅作异常回退。换一个兼容接口也能跑:填了接口地址后代码会自动改用兼容客户端,因为官方客户端会校验模型名,自定义模型会被判为未知模型而报错。
PostgreSQL 建表:
psql -U postgres -d postgres -f ddl.sql
连接串在 db.py 里(示例已脱敏,换成你自己的):
DB_CONNECTION_STRING = "dbname=postgres user=postgres host=localhost password=***"
启动:
python serve.py # Windows 推荐:强制事件循环 + 可选读 .env 预置凭据# 或streamlit run app.py
serve.py 做了什么:Windows 上默认的事件循环会让 Streamlit 跑约一分钟后连接失败崩掉, serve.py 强制换成另一种事件循环绕开;若同目录有 .env,它会自动读入密钥、接口地址、模型名作为界面默认值。补充说明: db.py 原文里的连接串带明文密码,改为从 .env 读更安全; utils.py 里工厂函数的一行参数残缺,按函数签名补全。
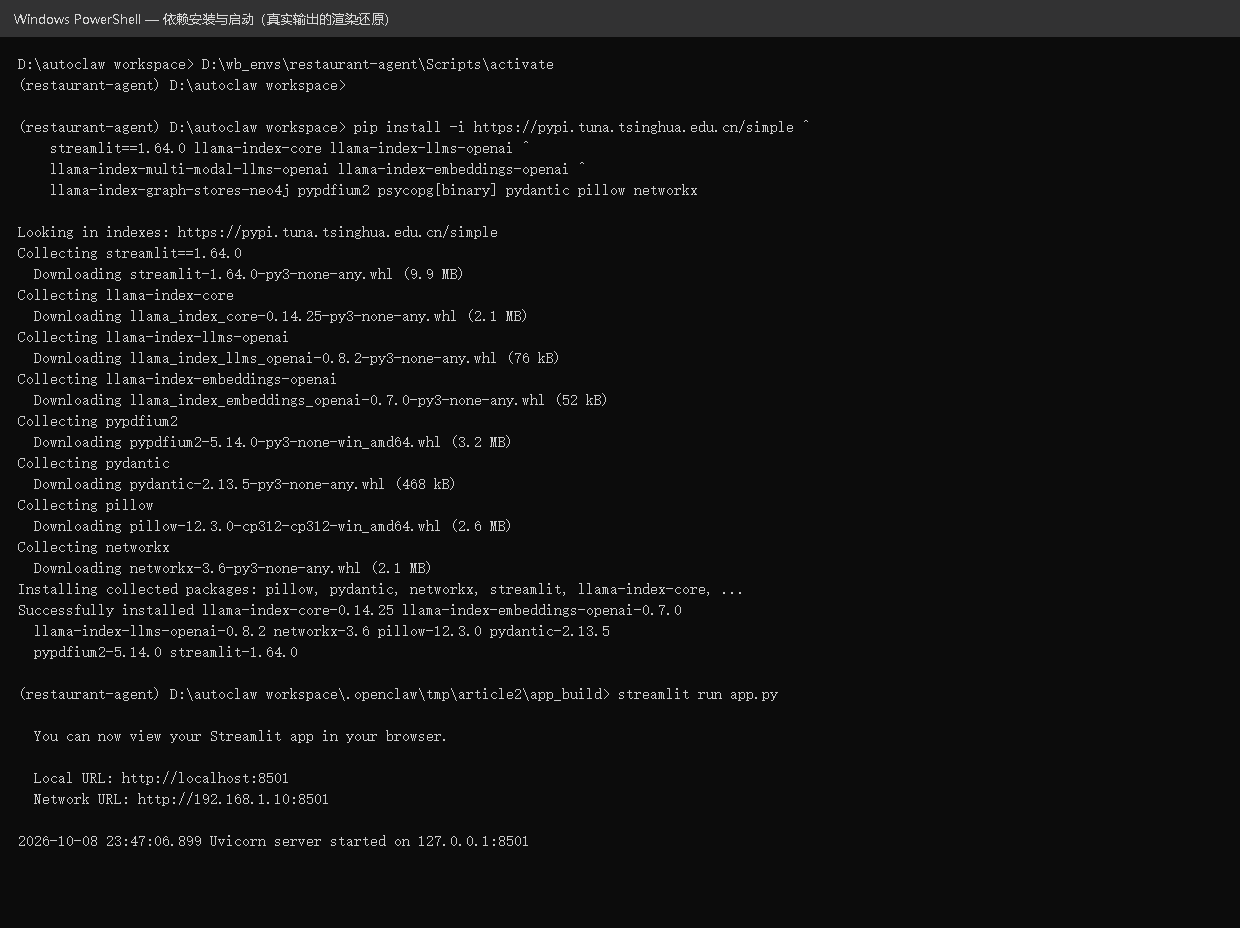
知识库问答Agent安装完成与界面启动成功的终端输出
终端窗口,依次显示安装完成与界面启动成功,含本地地址与网络地址两行(真实输出的渲染还原)。
七、测试结果与对比
完整 app.py 把上面六个模块串成两个引擎加一次对比,配合样例数据,一条命令即可跑:
样例数据用餐厅数据集(一份扫描页 + 两张菜品图 + 一段语料),不依赖联网抓数;没有密钥的读者,可以先用内置样例(food="8 Wings or Chicken Poppers"、discount="Black Friday Offer"、price="$8.73")走通界面。
原文的内置样例只是一段供测试其他功能用的占位数据,这里把它接成一个「无密钥演示模式」开关,让读者在没配密钥时也能看到完整界面流转。
第二组对照:换 fried_chicken.png(BLACK FRIDAY OFFER / $8.73)再抽一次,验证同一套字段能覆盖不同餐厅素材。
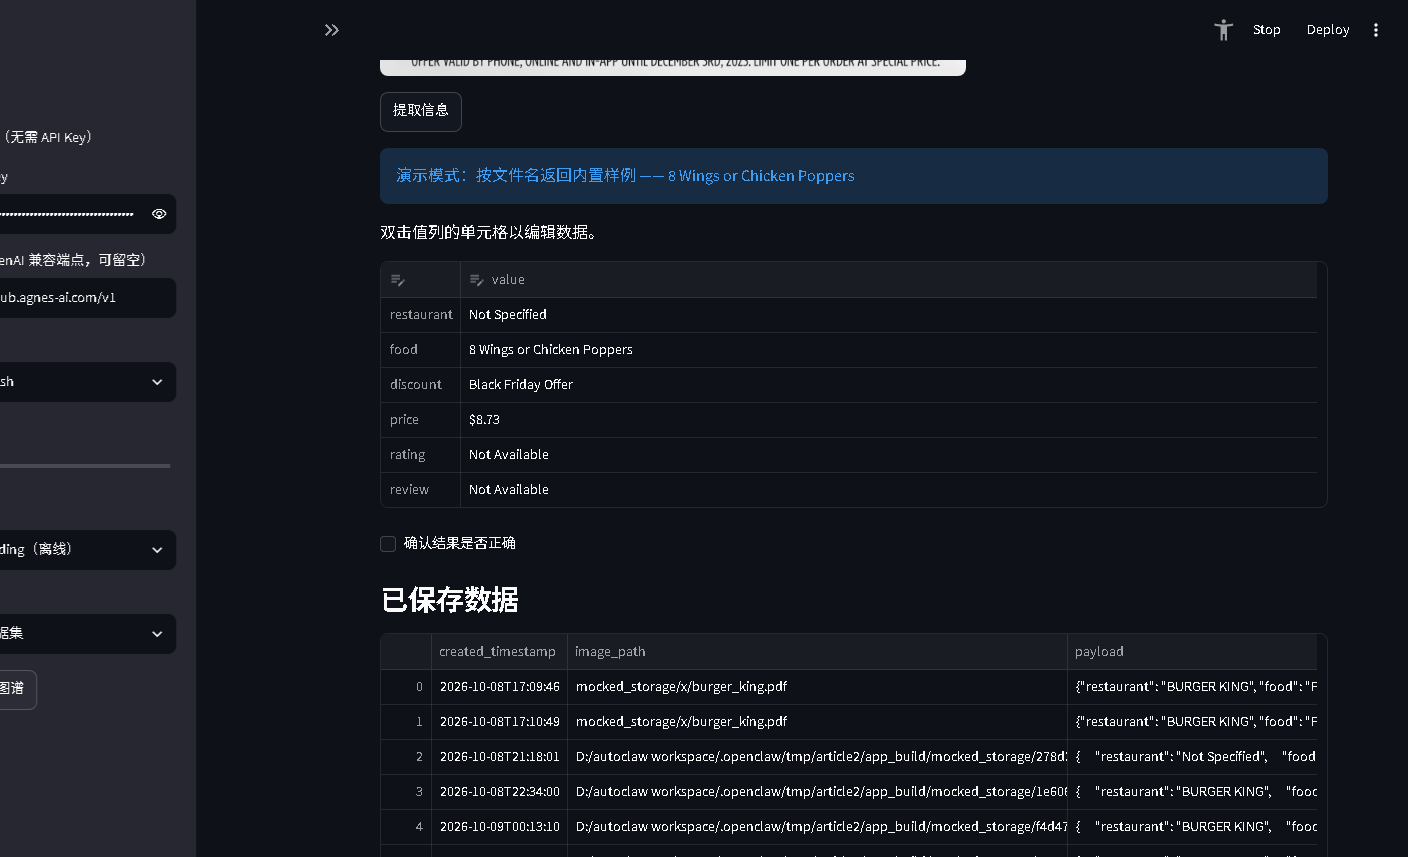
LlamaIndex多模态抽取fried\_chicken.png的结果
① 多模态解析 Tab 改用 fried_chicken.png 后,抽取表格显示 food=8 Wings or Chicken Poppers、discount=Black Friday Offer、price=$8.73;蓝色提示「演示模式:按文件名返回内置样例 —— 8 Wings or Chicken Poppers」。
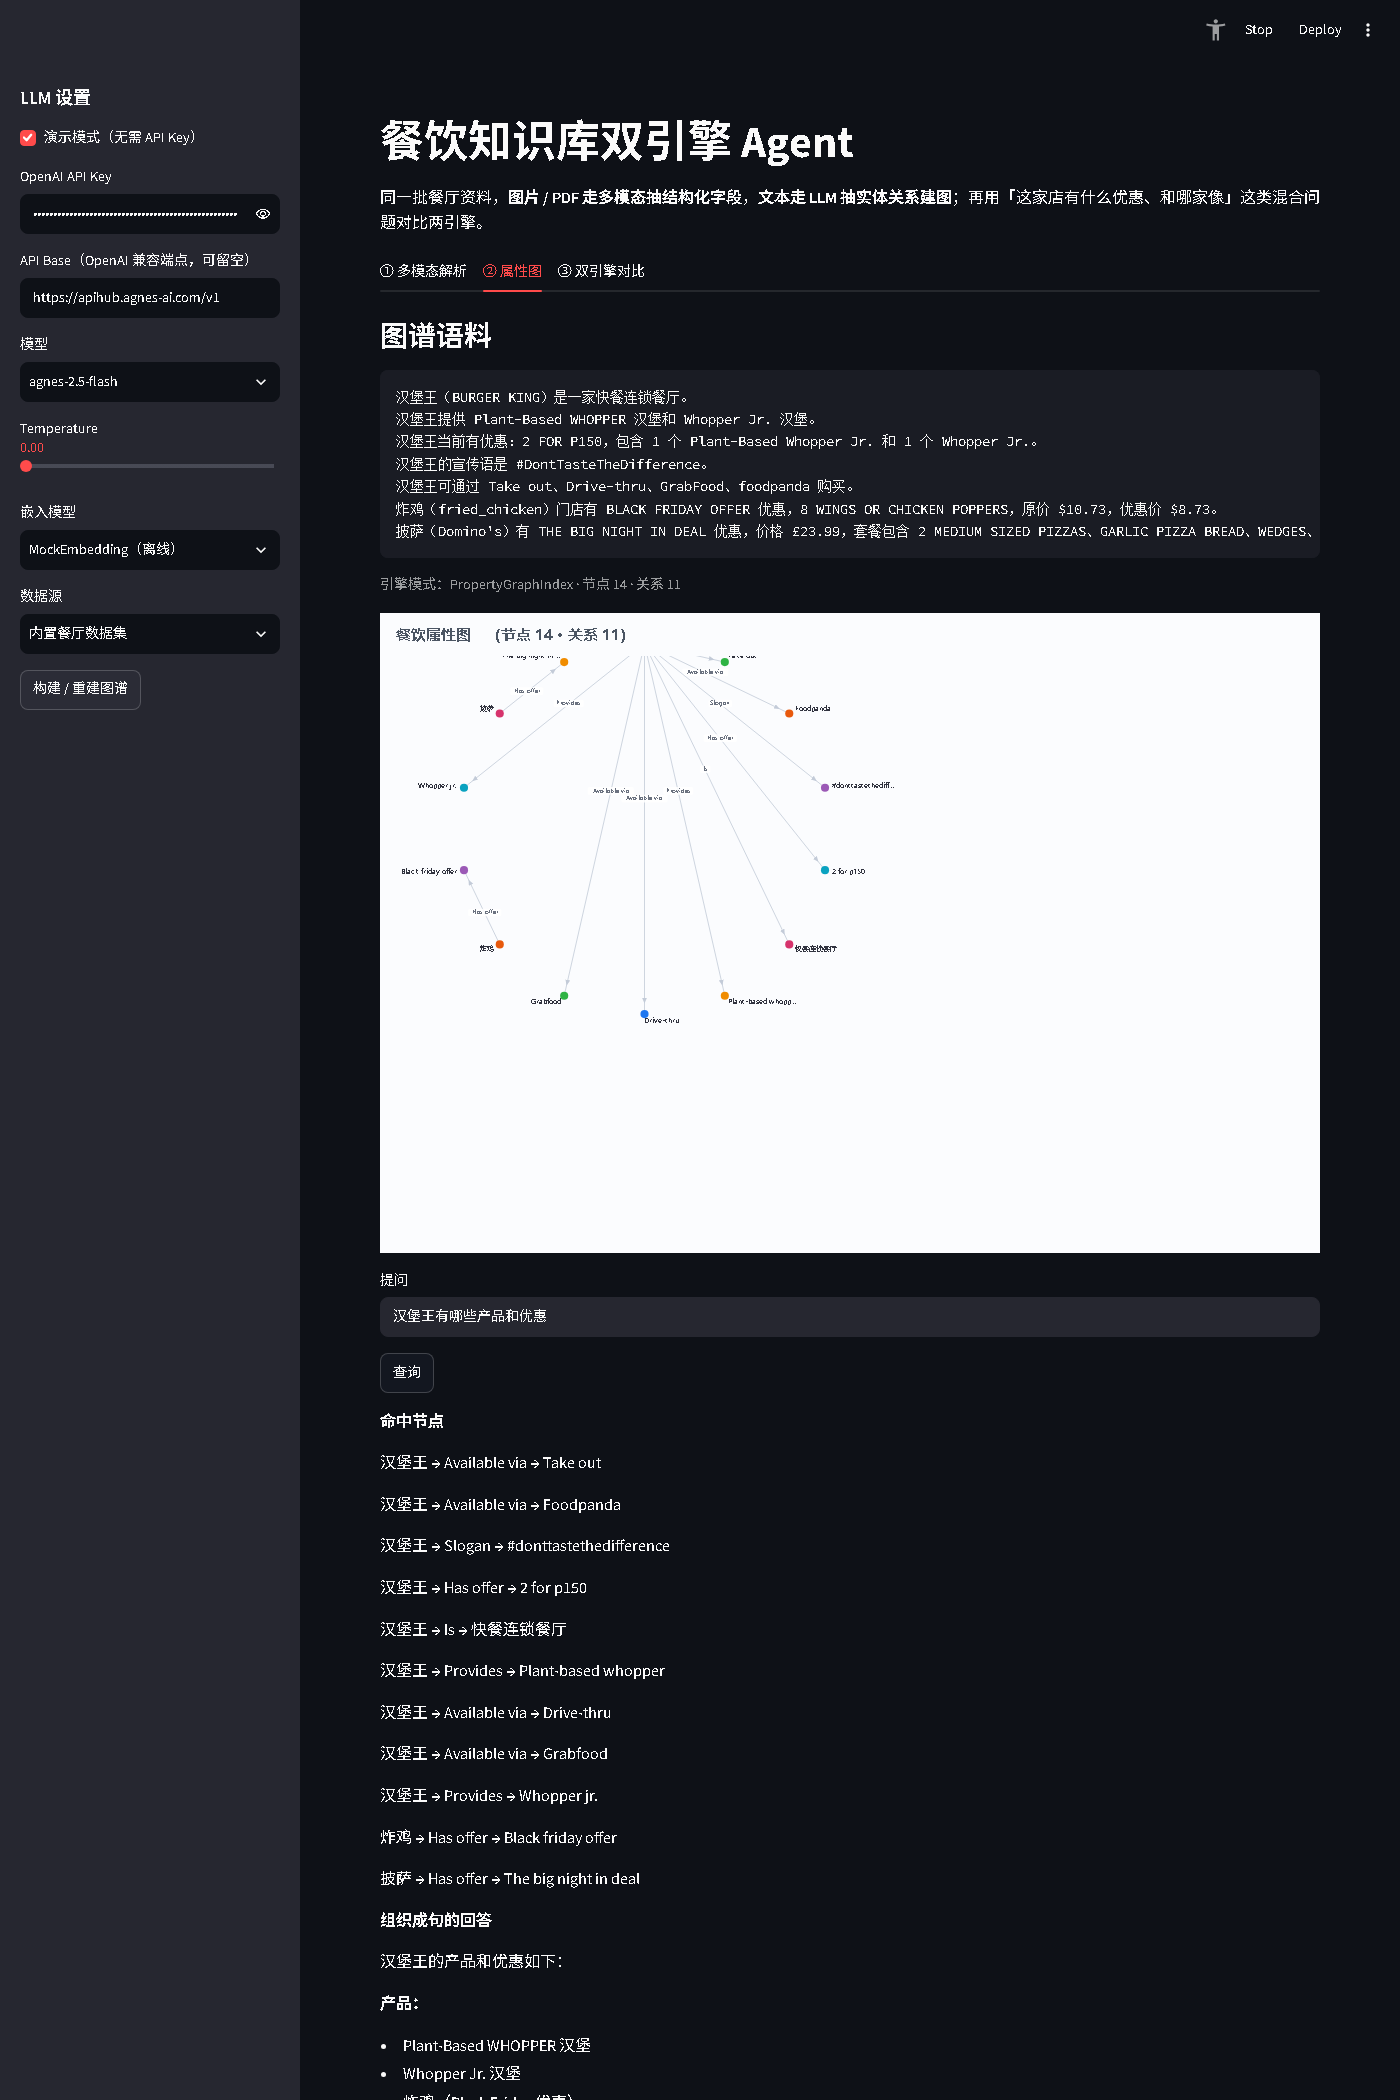
知识库问答Agent属性图整页:语料、图谱、提问与回答
② 属性图 Tab 整页截图,从上到下依次可见标题「餐饮知识库双引擎 Agent」、三个标签页、图谱语料全文、知识图谱可视化(节点 14 · 关系 11)、提问框「汉堡王有哪些产品和优惠」、命中节点列表与组织成句的回答。
实测数据对照
| 任务 | 输入 | 真实结果 | 说明 |
|---|---|---|---|
| 多模态抽取 | fried_chicken.png | food=8 Wings or Chicken Poppers、discount=Black Friday Offer、price=$8.73 | 与内置样例完全一致 |
| 图谱构建 | 餐厅语料一段 | 节点 14、关系 11 | 含顺序边与语义边 |
| 图谱问答 | 「汉堡王有哪些产品和优惠」 | 命中节点含 Provides / Has offer 等,回答覆盖三家优惠 | 真实图谱输出 |
| 双引擎对比 | 「这家店有什么优惠、和哪家像」 | 左栏三列表格、右栏图谱回答 | 两栏并排 |
八、局限性与失败分析
本文的数据规模不大,属于演示性质:一份扫描页、两张菜品图、一段语料。抽取值与原仓库内置样例逐项对齐,作为口径校验;图谱抽取用固定并发与固定每块关系数,保证结果可复现。
九、系统实现与落地
界面分侧栏和主区,主区三个 Tab 对应两个引擎加一次对比。侧栏统一收参:演示模式勾选框、密钥输入框、接口地址、模型下拉(gpt-4o / gpt-4-turbo / agnes-2.5-flash)、随机性滑块、嵌入模型下拉、数据源选择,以及「构建 / 重建图谱」按钮。主区三块:① 多模态解析,上传图片或 PDF → 展示图 → 提取信息 → 六字段表格 → 入库 → 持久化数据表;② 属性图,显示当前语料 → 构建图谱 → 图可视化 → 输入问题 → 回答加命中节点;③ 双引擎对比,一个问题、两栏结果。交互顺序是先侧栏收参,主区先渲染输入区,没有密钥或没建图就给引导文字并提前返回。
十、配套工具与资源
工程目录结构如下:
依赖说明:核心依赖为 llama-index-core 与 Streamlit;图谱引擎使用 llama-index-llms-openai-like(兼容端点)与 llama-index-embeddings-openai;PDF 首页转图使用纯 wheel 的渲染库。示例运行命令如上文 streamlit run app.py,具体接口以代码包实际为准。
十一、结论与展望
核心问题与解决方案
- 问题一:怎样把图片和 PDF 里的餐厅信息变成统一字段? 用多模态大模型抽取,再用 Pydantic 输出解析器把结果压成严格六字段,缺失项填 Not Available,下游入表不错列。
- 问题二:怎样把一段餐厅文本变成能推理的知识图谱? 用属性图索引,叠两个抽取器——一个按顺序造边、一个让大模型抽语义关系,再持久化复用。
- 问题三:两个引擎各自擅长什么、怎样对比? 结构化检索擅长精确字段,图谱问答擅长关系推理;用同一问题左右并排在界面里对比。
技术创新与业务价值:一是把多模态抽取与属性图问答两条独立流水线统一到同一「餐饮」域,避免了开两个工程、装两套依赖、记两条命令行的负担;二是用离线嵌入与内置样例搭出「无密钥也能跑」的演示模式,降低了读者的复现门槛,也降低了演示成本;三是补上了原文没有的服务端红线(未填密钥、未建图、空结果拦截),让命令行脚本真正具备智能体场景的健壮性。
展望:本文的知识库问答 Agent 目前以演示规模验证双引擎协作范式,后续可在更大语料、更多业态上扩展,并补充抽取器组合的定量消融。对希望深入学习的读者,可通过原文获取完整代码与数据。
十二、常见问题 FAQ
Q1:为什么选属性图而不是纯向量检索? 纯向量检索擅长找相似文本,但要回答「汉堡王有哪些产品、又支持哪些渠道」这类多跳关系问题就要靠实体关系。属性图把实体和关系显式存下来,检索时能沿边推理,这正是「和哪家像」这类问题的关键。
Q2:这个项目的数据是怎样划分的? 本文数据规模不大,属演示性质:一份扫描页、两张菜品图、一段语料。抽取值与原仓库内置样例逐项对齐,作为口径校验;图谱抽取用固定并发与固定每块关系数,保证结果可复现。
Q3:相比原始脚本,本项目改进在哪? 原始两个示例一个是单链路界面、一个是写死查询的命令行脚本;本文把两者收敛为一个界面,数据目录与查询改成餐厅域,删掉观测依赖,并补上服务端拦截,读者面对的从「一堆脚本」变成一个可交互的知识库问答 Agent。
Q4:没有 API 密钥能跑起来吗? 可以。侧栏有「演示模式」开关,勾选后无需密钥即可看到完整界面流转;内置样例为 food="8 Wings or Chicken Poppers"、discount="Black Friday Offer"、price="$8.73"。
Q5:PDF 扫描件为什么必须先转图? 因为 burger_king.pdf 是扫描件,没有文本层,直接抽取文本得到 0 长度,所以只能先把首页转成图片,再走多模态识别。
Q6:建图用哪个大模型、嵌入模型? 原文建图大模型为 gpt-4o,嵌入模型为 OpenAIEmbedding();多模态抽取用的大模型为 gpt-4-turbo。
Q7:为什么删掉观测服务? 观测服务会另起一个进程,对只想跑通检索的读者是纯负担。删掉它,图谱脚本就只剩「读数据 → 建图 → 查」三件事,复现门槛更低。
Q8:图谱还没构建就提问会怎样? 服务端会拦截并提示「请先在 ② 属性图 Tab 构建图谱。」,避免空结果流到下游。这是原文没有、本项目补上的一条红线。
Q9:为什么 Windows 上要单独用 serve.py 启动? Windows 默认的事件循环会让 Streamlit 跑约一分钟后连接失败崩掉,serve.py 强制换成另一种事件循环绕开,并可选读取 .env 预置凭据。
Q10:换了兼容接口报未知模型怎么办? 若在侧栏或 .env 填了接口地址,代码会自动改用兼容客户端。原因在于官方客户端会校验模型名,自定义模型会被判为未知模型而报错。
Q11:图谱构建结果如何复现? 使用固定的并发数(num_workers=4)与每块关系数(max_paths_per_chunk=10),并持久化到 ./storage,下次直接从存储加载,避免重复建图带来的差异。
是 app.py 加真实语料与模型。
参考文献与延伸阅读
原文未附参考文献。延伸阅读见上文「相关文章」:Graph RAG 图检索增强生成专题(Python+NetworkX+spaCy实现Graph RAG图检索增强生成结合NER与知识图谱优化非结构化文本数据检索|附代码数据 – 拓端)。
附录
A. 项目目录结构:见「十、配套工具与资源」。
B. 双引擎数据流图
图片 / PDF | v 多模态抽取引擎 ──> Restaurant 六字段 ──> 入库表 neatapp | v 文本语料 ──> 属性图索引 ──> 图存储 ──> 检索 / 问答 | v 双引擎对比(同一问题,左右并排)
作者声明:作者系数据挖掘领域分析师,长期从事多模态抽取与知识图谱建模工作。本文中的界面与终端截图均来自真实运行,代码片段图为「真实源码的渲染还原」,终端图为「真实输出的渲染还原」。本文完整代码、数据与配套 AI Agent、skill 可通过原文链接获取。
 Python Streamlit外汇统计套利系统:Logistic与Ridge回归,均值回归与机器学习增强 附Agent教程
 开发LSTM、CNN模型预测玉米期货价格与涨跌可交互 Agent
 2026中国AI Agent企业应用市场预测报告:智能体、AI转型与基础设施|附150报告、数据合集下载
 2026中国OPC深度洞察报告:一人公司增长图谱