开发LSTM、CNN模型预测玉米期货价格与涨跌可交互 Agent
把深度学习引入商品期货预测,难点从来不在模型本身,而在于金融序列的非平稳性会一步步瓦解模型的假设。
LSTM价格回归三轮迭代与CNN涨跌分类回测全流程,2022年样本外最大回撤从-5.2%收窄至-1%,附完整代码、数据与AI agent、skill资源。
TL;DR:本文用 Python 对玉米期货十年日频行情建模:LSTM 价格回归两次迭代后仍陷滞后陷阱,改用 CNN 融合 TA-Lib 技术指标做涨跌分类,2022 年样本外回测最大回撤从 -5.2% 收窄至 -1%。文末附代码、数据与 AI agent 资源获取方式。
摘要
本文围绕玉米期货的深度学习建模回答五个问题:为什么未经归一化的价格序列会让 LSTM 训练发散?归一化后预测收盘价为何退化为滞后一天的朴素预测?对数收益率为何难以直接回归?如何用 CNN 把涨跌判断变成可执行的仓位信号?预测信号经回测能否跑出更低回撤?
关键词:LSTM期货价格预测;CNN涨跌分类;TA-Lib技术指标;量化择时回测;Python深度学习
Abstract
This article answers five questions on deep learning for corn futures: why unnormalized prices make LSTM training diverge; why normalized price regression collapses into a one-day-lagged naive forecast; why log returns are hard to regress; how a CNN turns up-down classification into position signals; and whether the signal-based strategy shows smaller drawdowns in backtesting.
Keywords: LSTM futures price prediction; CNN direction classification; TA-Lib technical indicators; backtesting; Python deep learning
研究背景与痛点
成为新会员获取本项目完整代码、数据与AI智能体
把深度学习引入商品期货预测,难点从来不在模型本身,而在于金融序列的非平稳性会一步步瓦解模型的假设。本文改编自我们此前承接的一个期货量化研究咨询项目,客户希望评估 神经网络 能否为玉米期货提供可交易的择时信号。
本项目完整代码、数据与AI智能体
常见痛点有三个:一是原始价格量级大、分布漂移严重,模型训练容易发散;二是价格回归看似收敛,实际只是复制前一天价格的朴素预测;三是收益方向极难回归,模型输出退化成常数。本文沿”价格回归→归一化改进→收益率建模→涨跌分类→信号回测”的路径逐层推进,完整呈现了模型从发散、退化到可用的全过程。文中所有代码均以 Python 编写,配套 TensorFlow 、scikit-learn 与 TA-Lib。
技术方案总览
本文的技术路线是一条递进式流水线:先用 LSTM 做价格回归定位问题,再切换预测目标与模型结构,最后落地成可回测的择时策略。全文脉络如下:
数据准备 | v 价格回归建模 |+-----+-----+ | | v v 未归一化 MinMax归一化 (发散) (滞后陷阱) | |+-----+-----+ | v 对数收益率回归 | v CNN涨跌二分类+-----+-----+ | | v v 仅收盘价 TA-Lib技术指标 | |+-----+-----+ | v 策略回测落地
数据来源与预处理
数据名称:玉米期货行情数据(Corn Futures Daily Quotes Dataset)
数据量:约 2400 余条日频记录,其中 2022 年约 242 个交易日作为样本外区间
字段:日期、开盘价、最高价、最低价、收盘价、成交量
数据来源:由拓端团队整理核对,全部内容真实有效
时间跨度:2013—2022 年
区域跨度:国内商品期货市场
数据格式:Excel 时间序列,以交易日为索引
数据简介:数据覆盖玉米期货主力合约连续行情,恰逢 2016 年收储政策改革引发的价格重估与 2020 年后的上行周期,兼具深度回撤与趋势行情,适合检验深度学习模型在不同市场状态下的稳健性。
本数据可支撑的主题实证研究:
- 一是深度学习时序预测建模对比;
- 二是技术指标在期货涨跌分类中的有效性检验;
- 三是基于机器学习信号的量化择时策略回测。
数据指标:
| 指标 | 含义 |
|---|---|
| 开盘价、最高价、最低价 | 日内价格边界 |
| 收盘价 | 建模主变量 |
| 成交量 | 市场活跃度(5 日均线入模) |
数据展示:
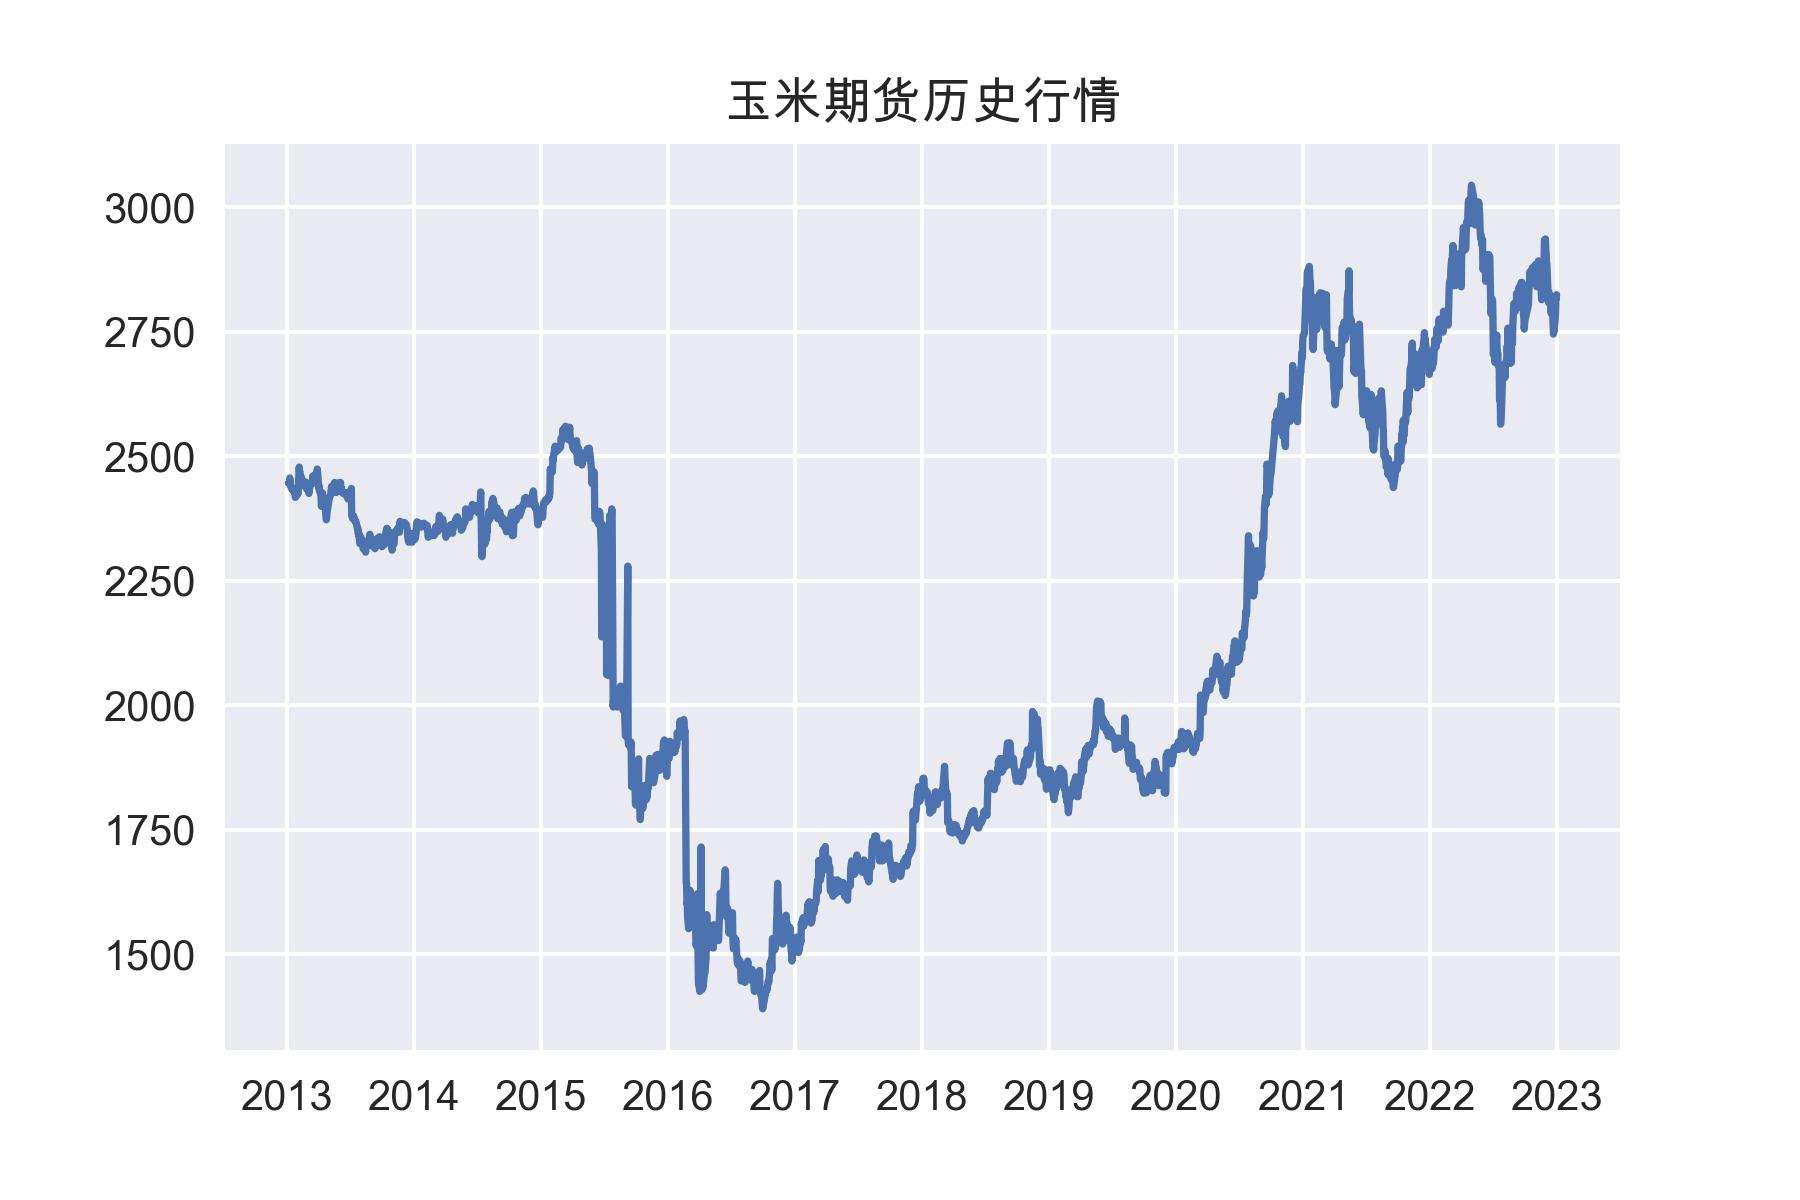
十年间价格从 2400 附近高位震荡,到 2016 年跌破 1500,再到 2022 年上冲 3000,非平稳特征显著,是检验预测模型的试金石。
最受欢迎的见解
- Python员工数据人力流失预测:ADASYN采样CatBoost算法、LASSO特征选择与动态不平衡处理及多模型对比研究
- R分布式滞后非线性模型DLNM分析某城市空气污染与健康数据:多维度可视化优化滞后效应解读
- Python古代文物成分分析与鉴别研究:灰色关联度、岭回归、K-means聚类、决策树分析
- Python TensorFlow OpenCV的卷积神经网络CNN人脸识别系统构建与应用实践
- Python用Transformer、SARIMAX、RNN、LSTM、Prophet时间序列预测对比分析用电量、零售销售、公共安全、交通事故数据
- MATLAB贝叶斯超参数优化LSTM预测设备寿命应用——以航空发动机退化数据为例
- Python谷歌商店Google Play APP评分预测:LASSO、多元线性回归、岭回归模型对比研究
- Python+AI提示词糖尿病预测模型融合构建:伯努利朴素贝叶斯、逻辑回归、决策树、随机森林、支持向量机SVM应用
核心模型设计:LSTM价格回归的两次迭代
本章核心结论:价格回归路线的价值不在于预测结果,而在于暴露两个经典陷阱——量纲发散与滞后复制。
提示词:数据准备与走势检查
背景:我手上有一份玉米期货十年日频行情 Excel,以交易日为索引,想用深度学习做预测。目标:先完成环境配置,读取数据并画出十年收盘价走势做直观检查。约束:请用 Python、pandas 和 matplotlib,可视化用 seaborn 样式,注意中文字体与负号显示,图片按 300dpi 保存。
从走势看,价格先后经历高位震荡、2016 年前后的断崖下跌与 2020 年后的加速上行(见上文数据展示图),三个阶段的分布差异极大——这为后文模型的两次翻车埋下伏笔。这里先讲一段背景:2016 年前后国内取消了实施多年的临时收储政策,玉米定价由政策托底转向市场供需,价格中枢随之重估(行业术语:结构性断点)。对模型而言,这种断点意味着”历史规律”可能失效。
提示词:直接建模预测下一日收盘价
背景:数据已就绪,我想先做最直接的尝试——用过去 30 个交易日的收盘价预测下一日收盘价。目标:构建训练集(2013—2021)与测试集(2022 全年),搭建一个单层 LSTM 回归模型。约束:请用 TensorFlow 的 Sequential 接口,LSTM 50 个单元,损失用均方误差,配早停策略防止过拟合,时间步长设为 30。
LSTM 的记忆能力来自三个门控单元,用简单符号表示:遗忘门 f = σ(W·[h, x] + b) 决定丢弃多少旧记忆,输入门 i = σ(W·[h, x] + b) 决定写入多少新信息,输出门 o = σ(W·[h, x] + b) 决定输出多少;其中 σ 是把数值压到 0 到 1 之间的 sigmoid 函数。损失采用均方误差 mse,即对各样本误差的平方取平均。
LSTM玉米期货价格预测:2013-2022年收盘价历史走势
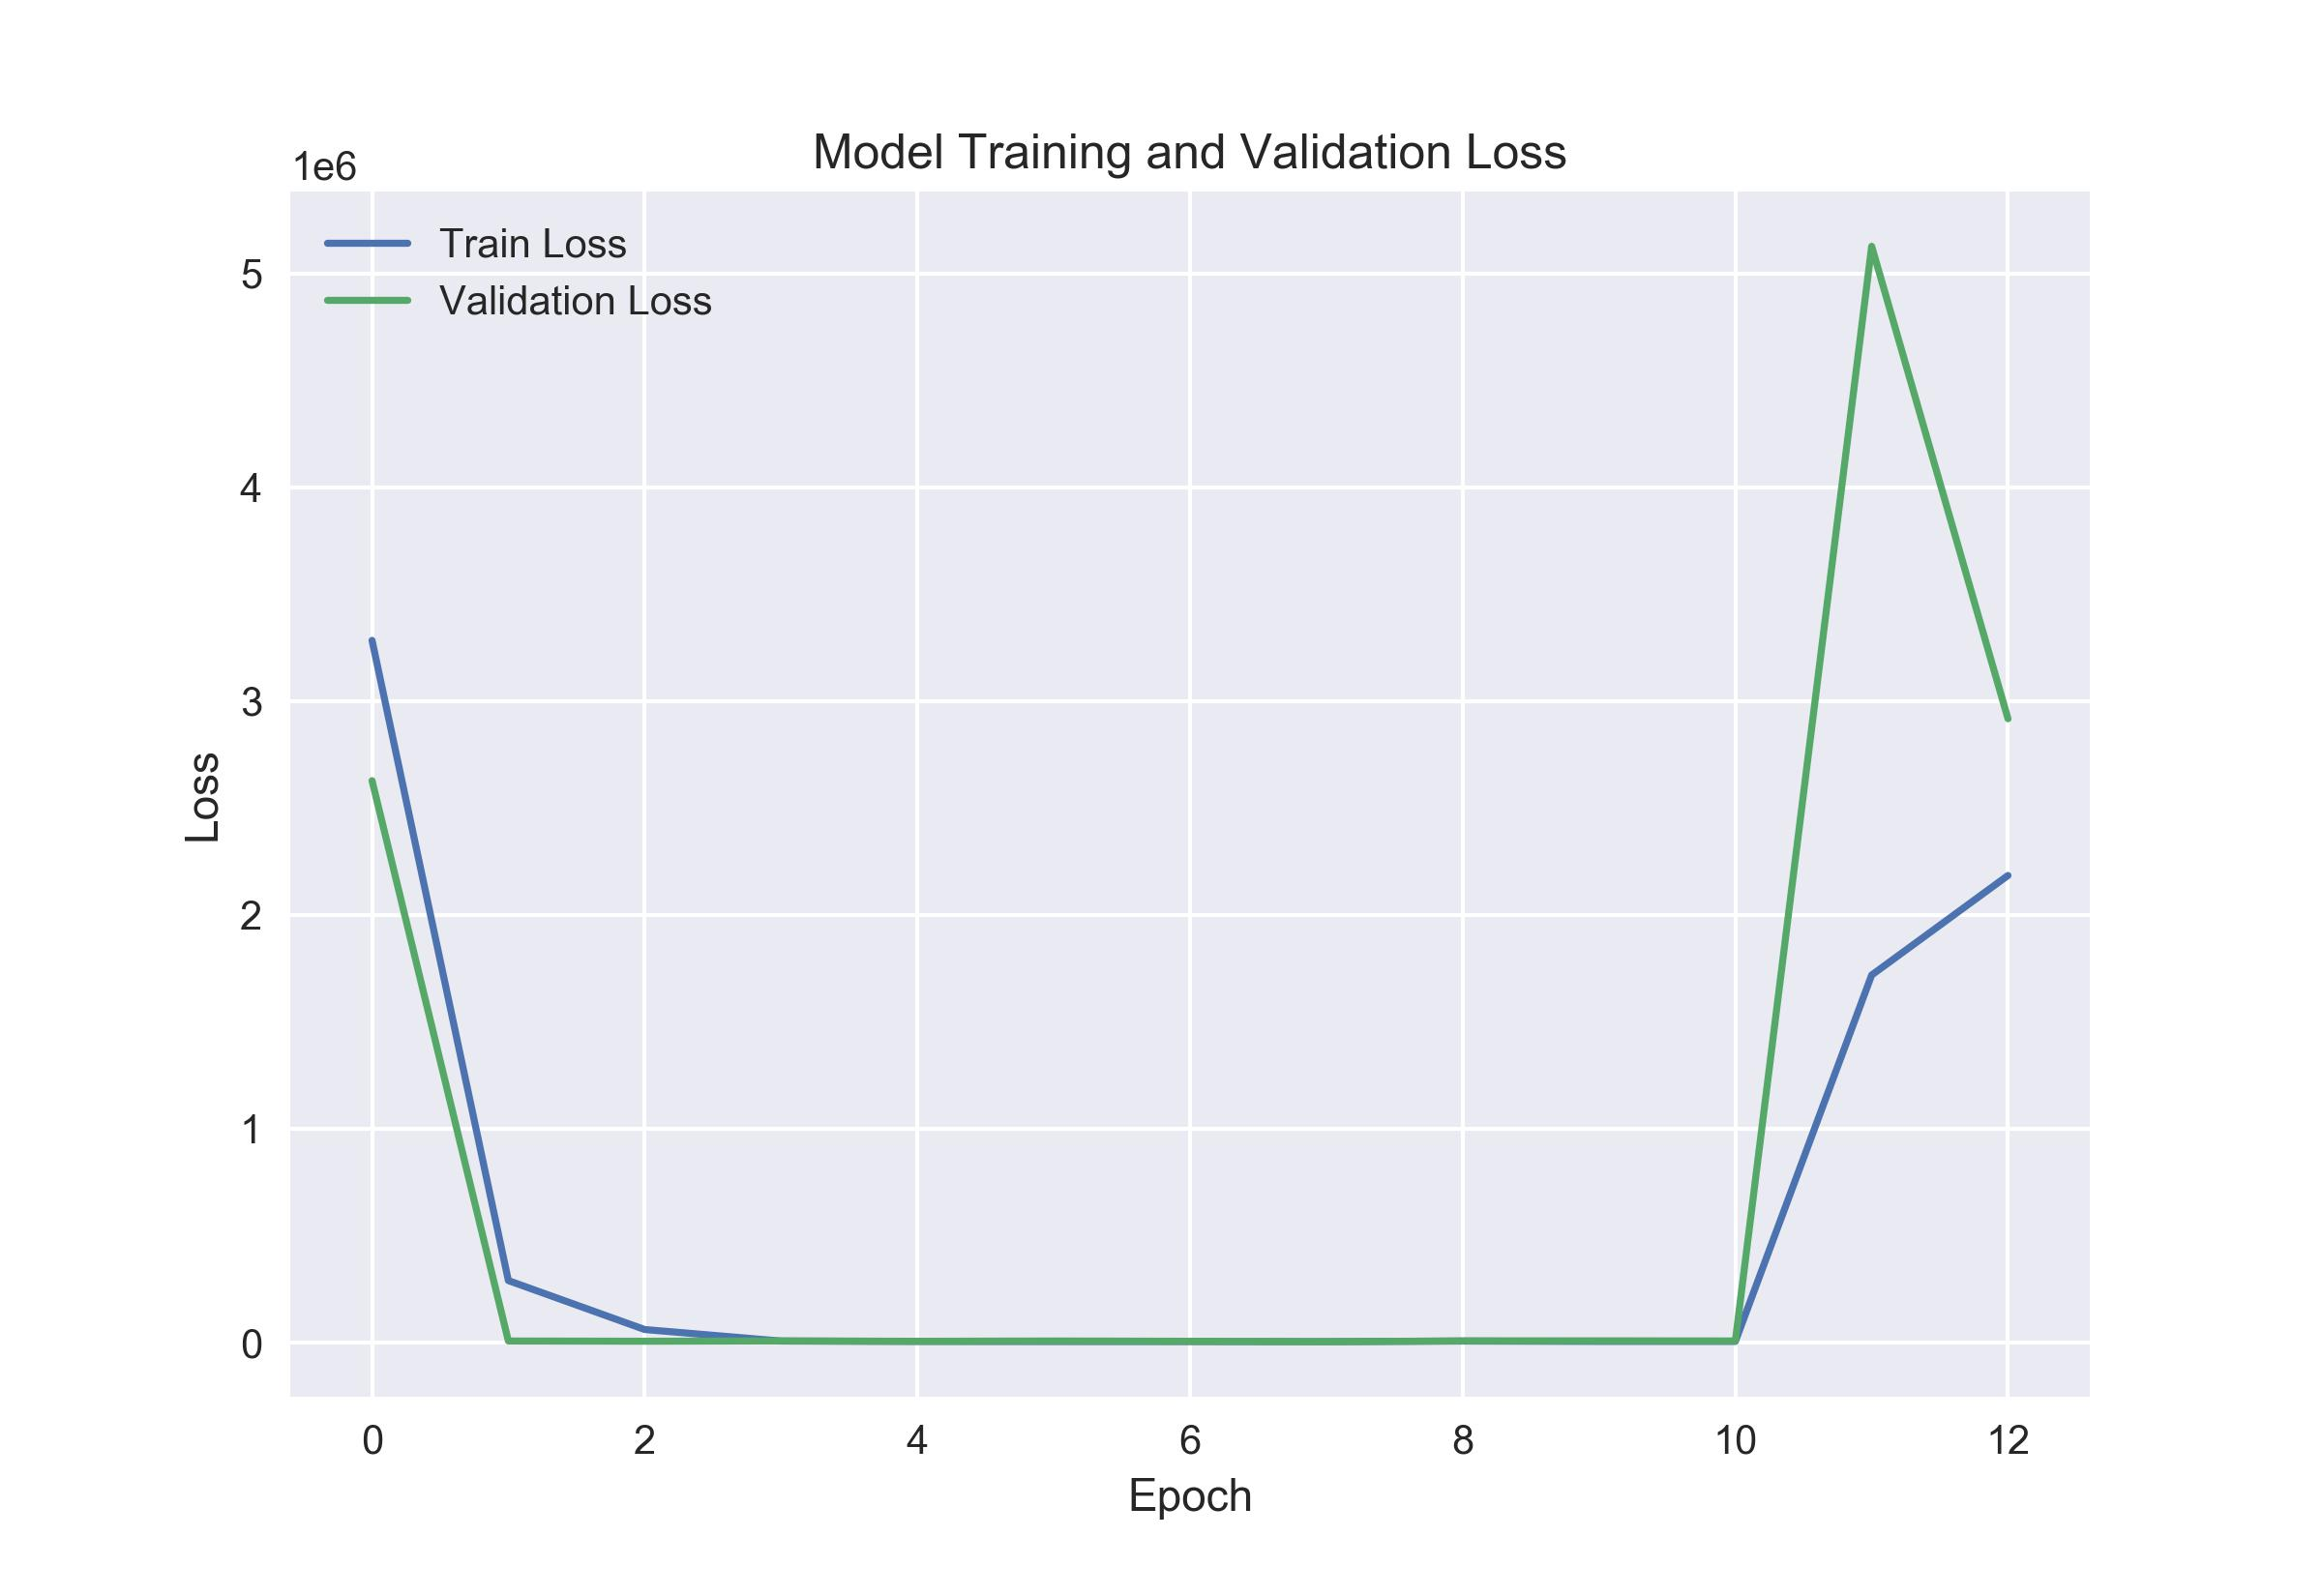
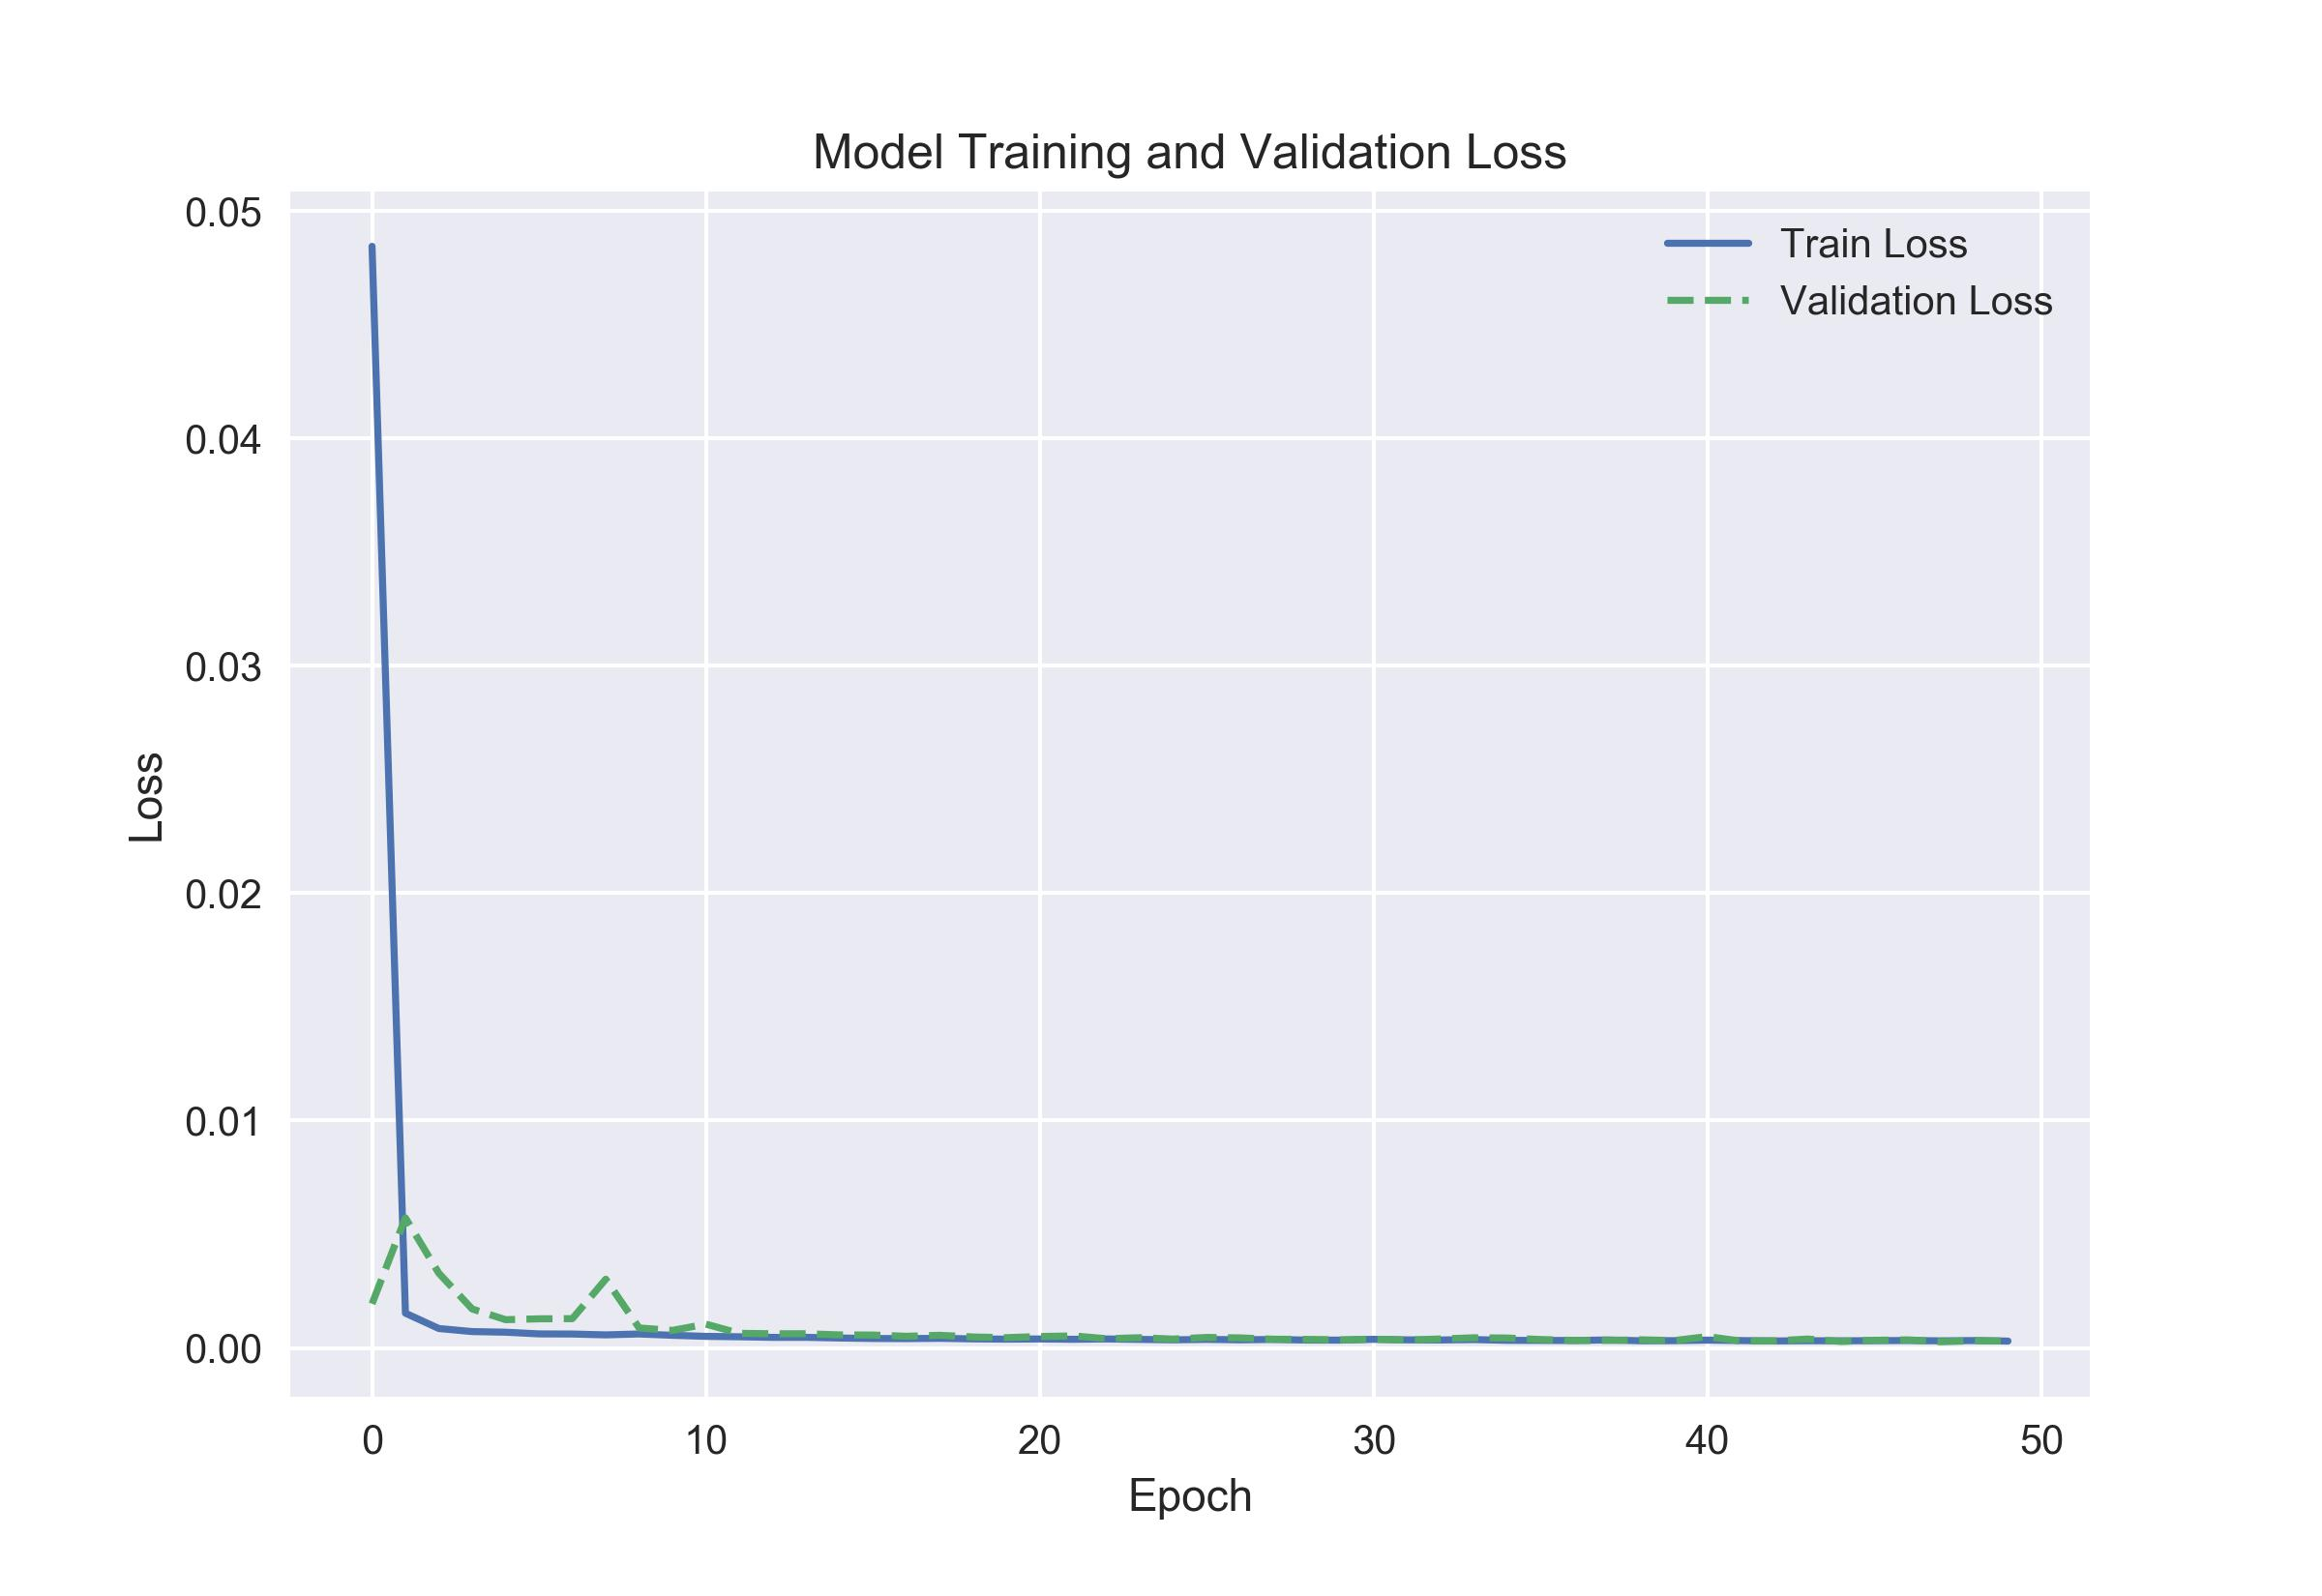
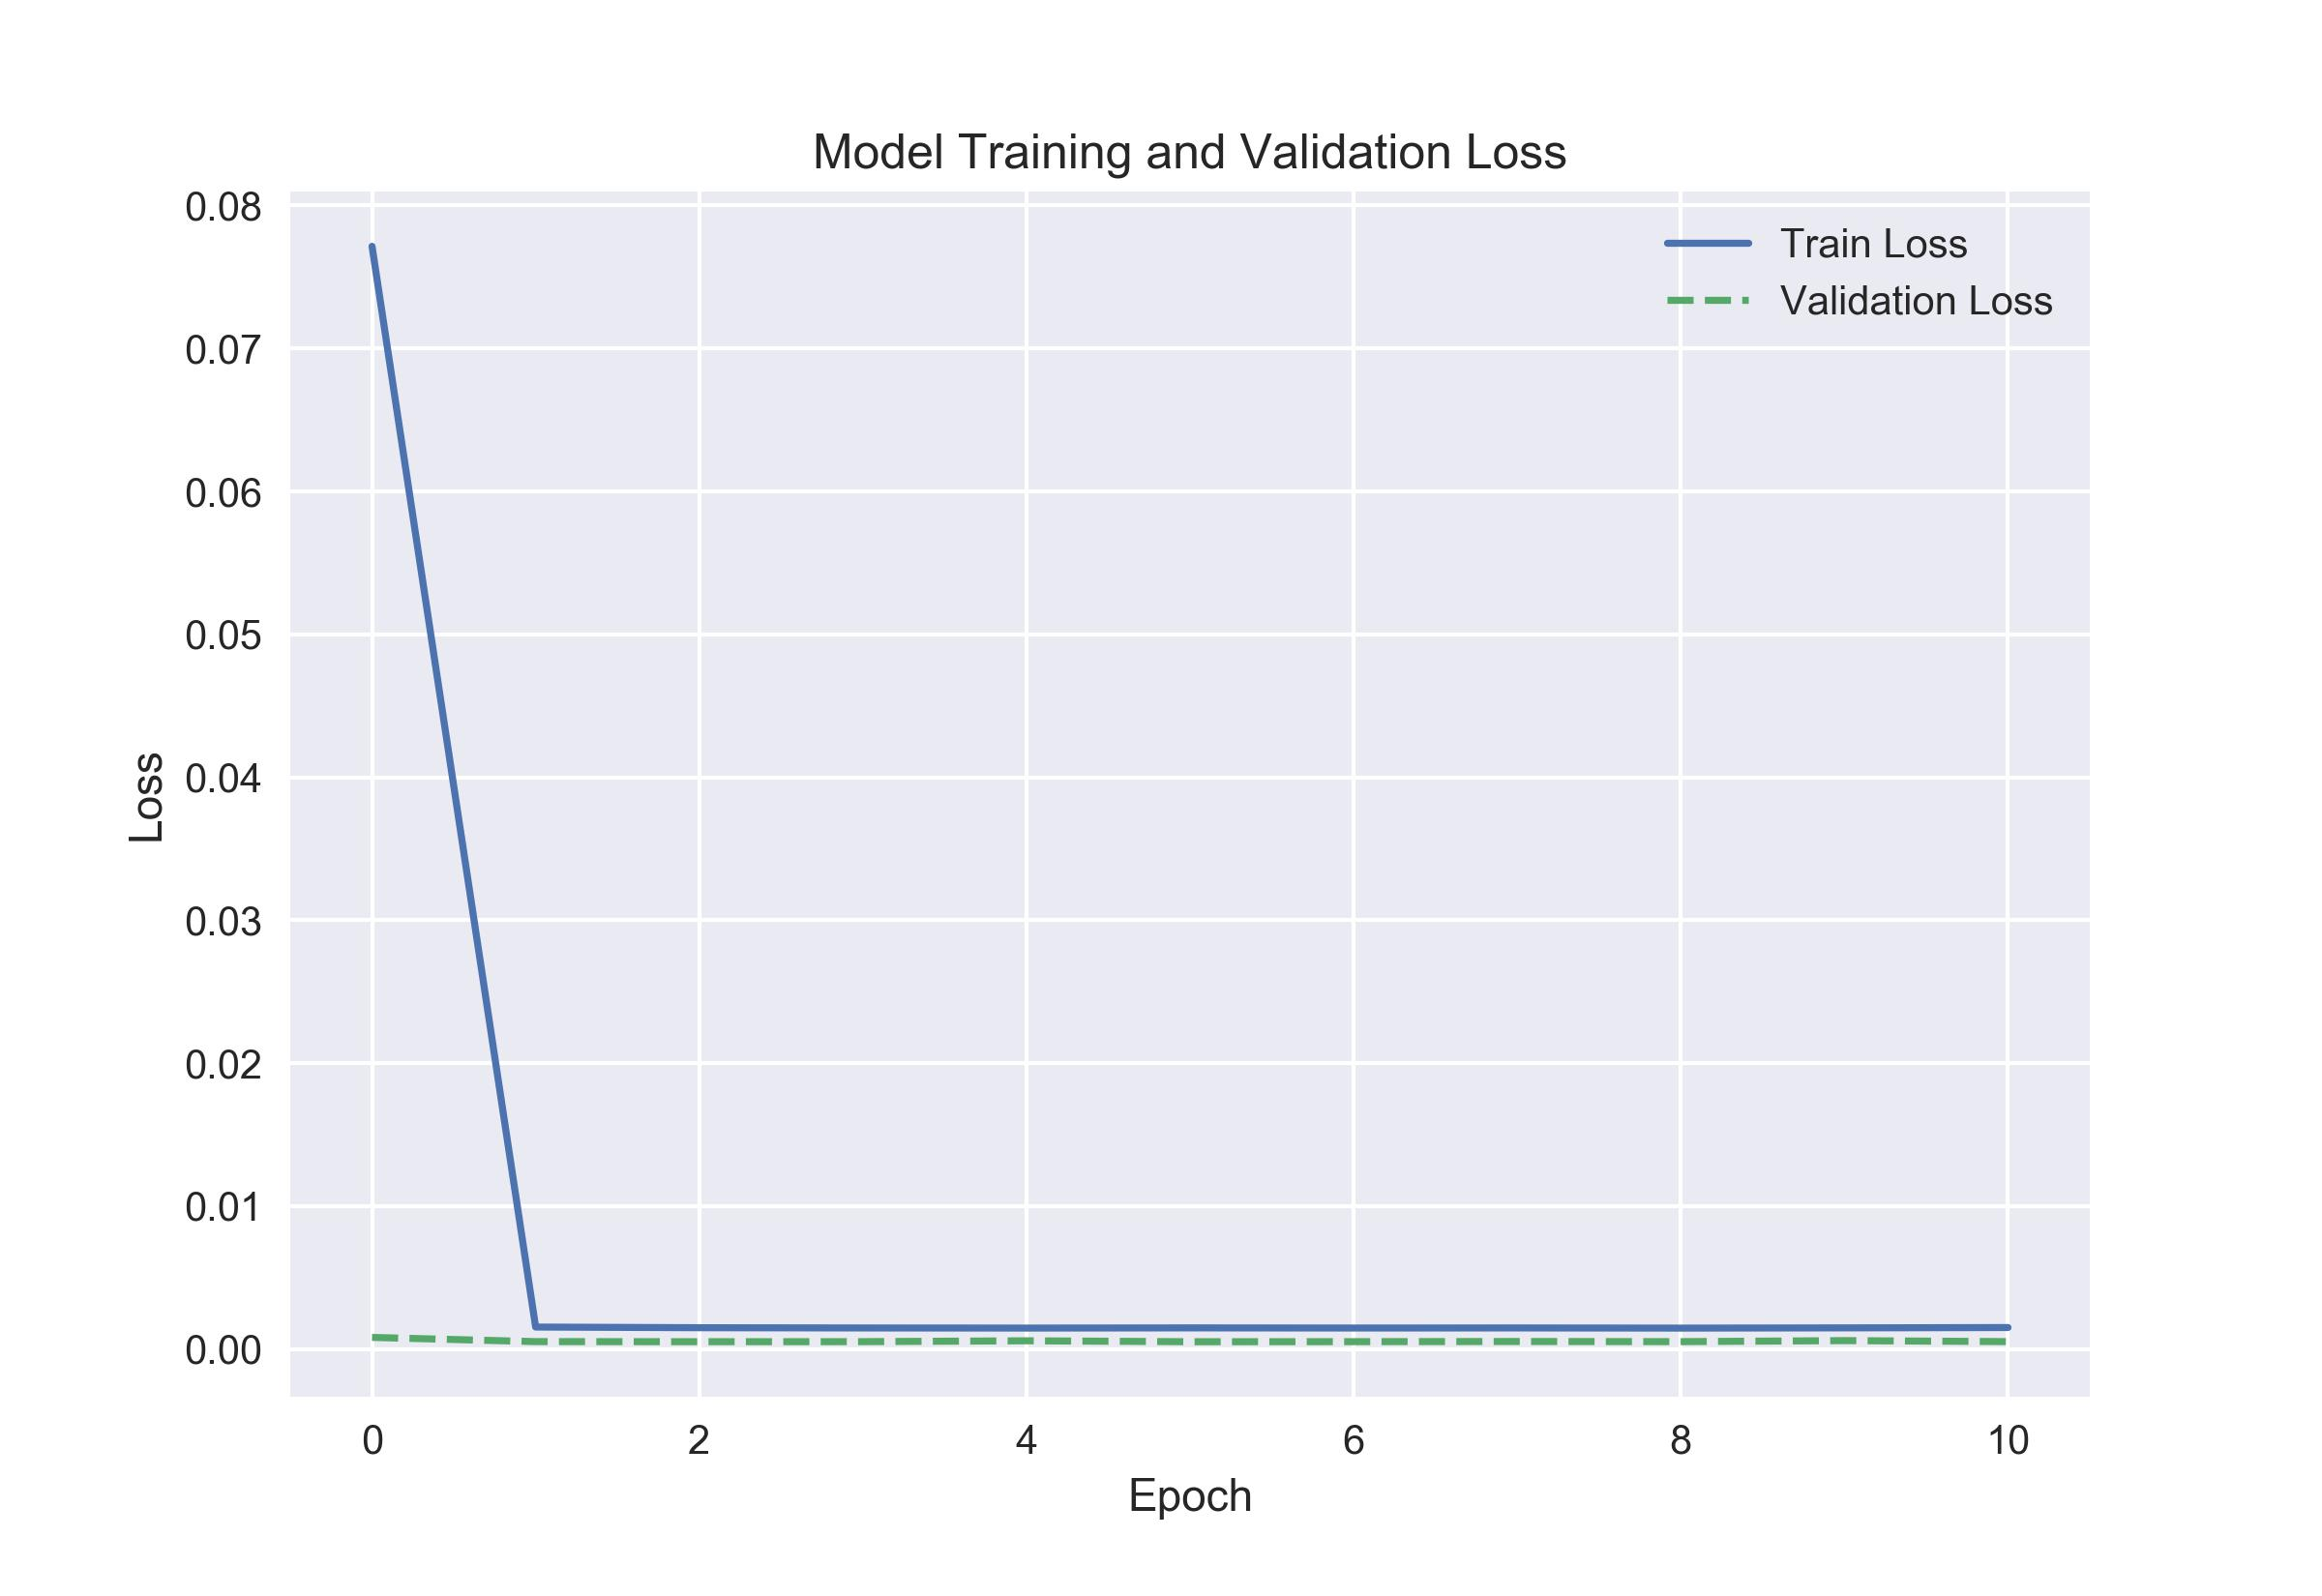
损失量级高达百万级别,且第 10 轮之后验证损失从接近 0 反弹到约 5.1e6,训练彻底发散。原因在于收盘价是 1500 到 3000 的原始量级,均方误差对这种量级极其敏感,而测试集价格整体高于训练集,模型无法同时适配两段分布。
LSTM期货价格预测:未归一化模型的训练与验证损失发散曲线
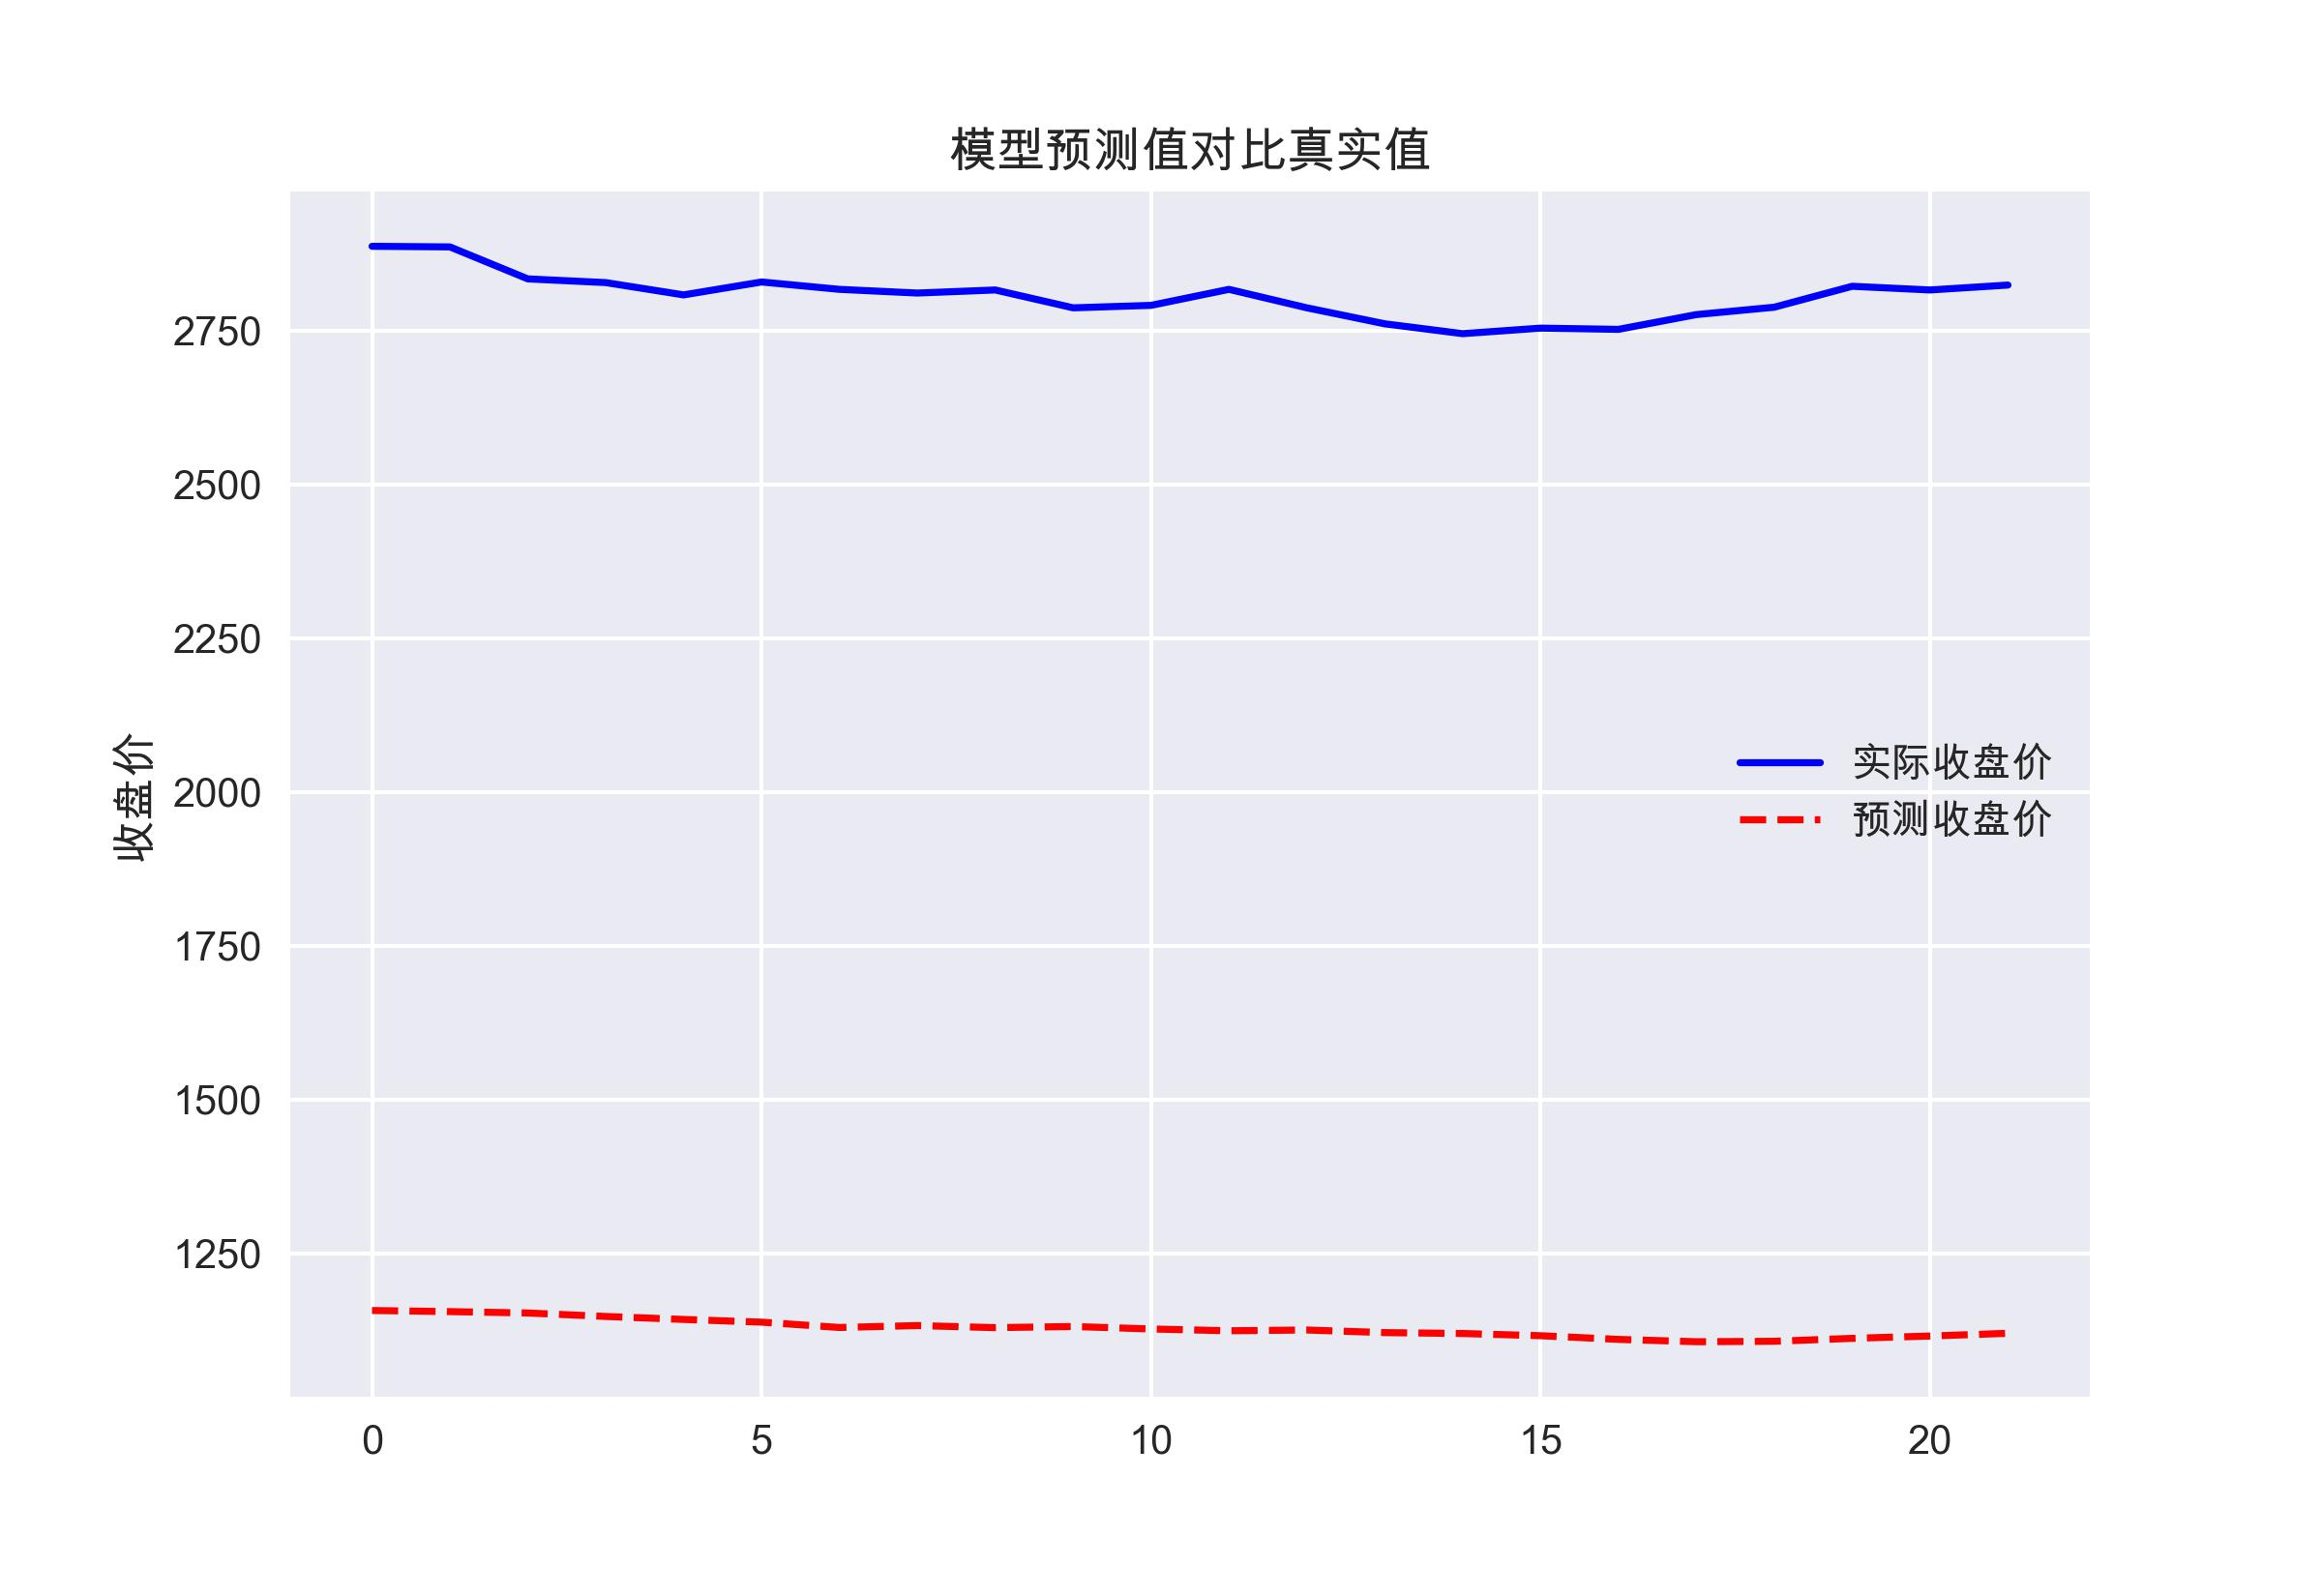
预测值恒定在 1150 附近,与 2800 左右的真实价格完全脱节。这一课的结论很直接:未经归一化的 LSTM 基本不可用,网络内部激活值在大数值下饱和,模型只学到了”输出一个训练集中出现过的低价水平”。
提示词:引入 MinMax 归一化约束
背景:上一版模型发散了,问题出在价格量纲上。目标:把收盘价缩放到 0 到 1 区间后重新训练,并在预测完成后还原回真实价格。约束:请用 sklearn 的 MinMaxScaler,网络结构与超参数保持不变,注意预测值要做反归一化。
归一化公式很简单:x’ = (x − x_min) / (x_max − x_min),即把原值按最小最大值线性映射到 0 到 1。有一点需要提醒:这里的缩放器是在全样本上拟合的,严格做法应当只用训练集拟合再套用到测试集,否则存在轻微的数据泄露,实盘建模时要格外小心。
LSTM期货价格预测:未归一化模型预测值与真实值脱节对比
损失量级降到 0.05 以内,训练与验证曲线平滑收敛、贴合度高,再无发散迹象。
LSTM玉米期货价格预测:归一化后训练与验证损失平滑收敛
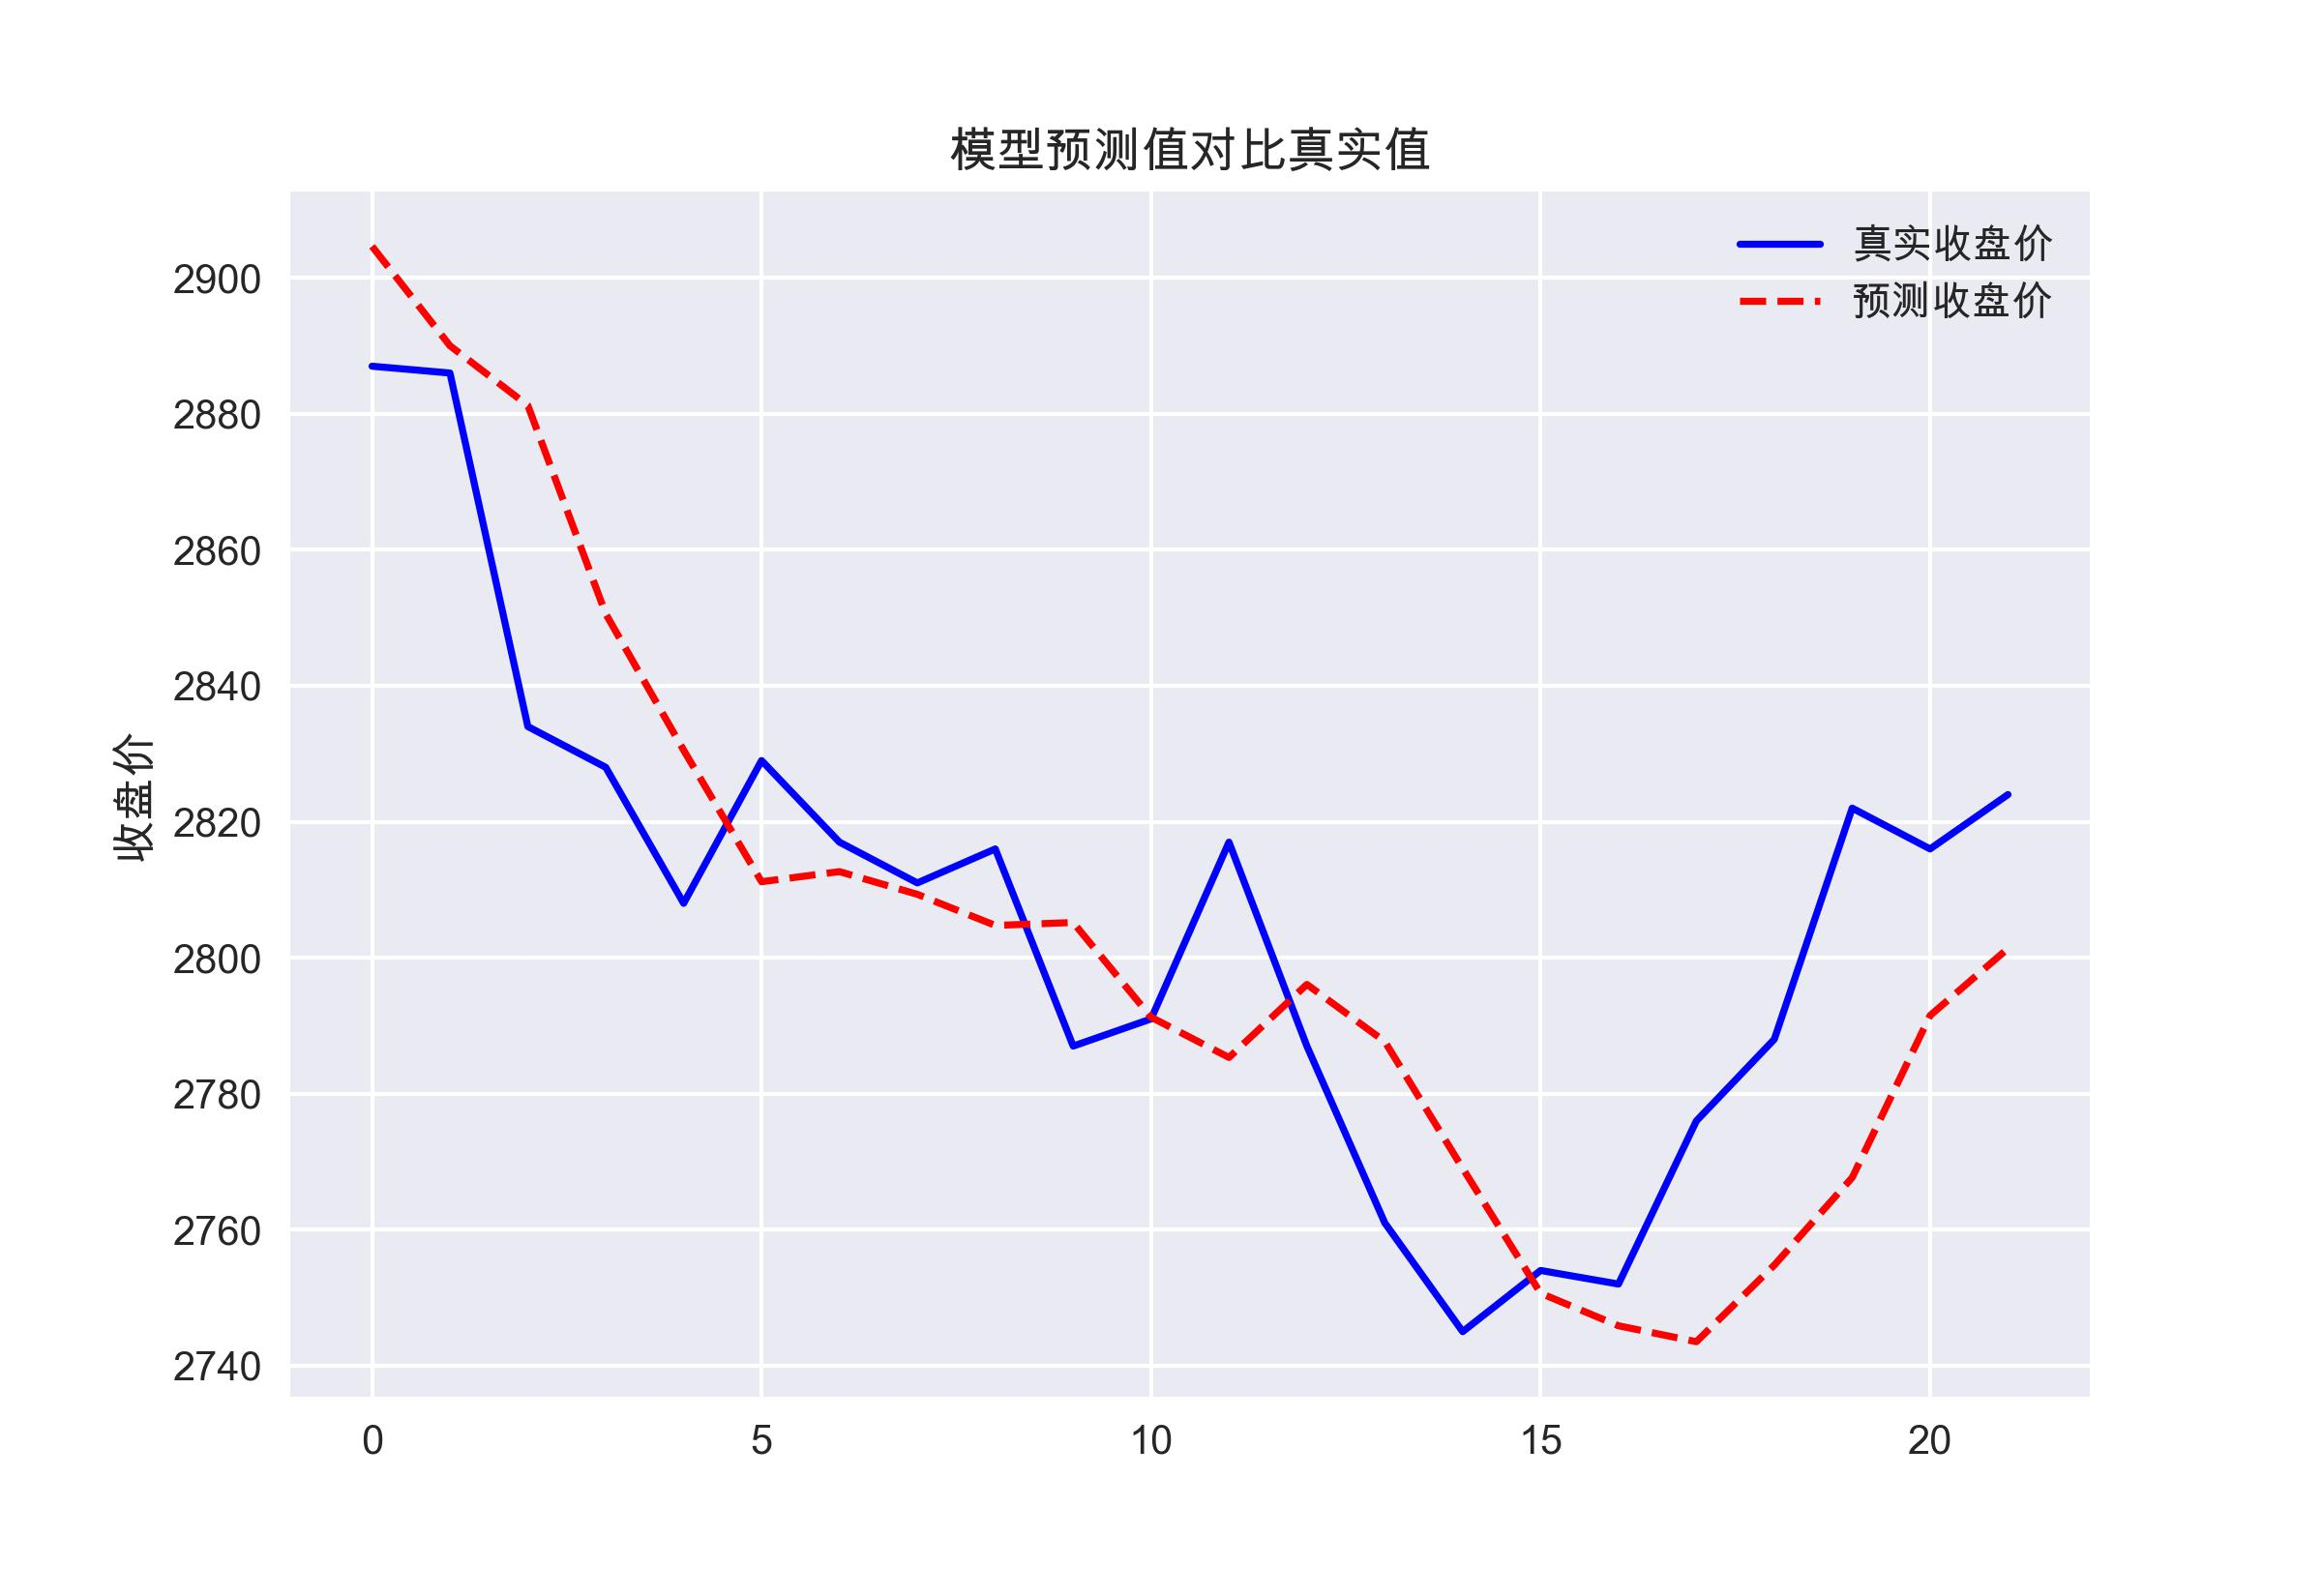
预测曲线与真实曲线形态吻合,但如果答辩席上被问到”这算预测成功了吗”,标准答案藏在细节里:预测线是真实线右移一天的影子。对高度随机游走的金融序列而言,”用昨天的价格预测今天”就是均方误差损失下的近似最优解,模型学会的正是这一点。每个拐点都跟不上,对交易而言没有增量信息——这正是导师们常追问的”基准对比”问题:任何预测模型都必须先跑赢朴素预测才有意义。
方法细节:转向对数收益率建模
本章核心结论:对数收益率更平稳,但收益方向在均方误差损失下不可回归,模型会退化为输出均值。
提示词:改用对数收益率作为预测目标
背景:价格水平预测陷入滞后陷阱,我想改预测对数收益率,它更平稳且有可加性。目标:计算日度对数收益率并可视化检查,再用同样的 LSTM 框架回归收益率。约束:对数收益用相邻两日收盘价之比取自然对数,缺失首行要剔除,模型超参数沿用上一版。
对数收益的定义:r = ln(P / P_prev),P 为当日收盘价,P_prev 为前一日收盘价。
LSTM期货价格预测:归一化后预测曲线滞后一天的朴素预测形态
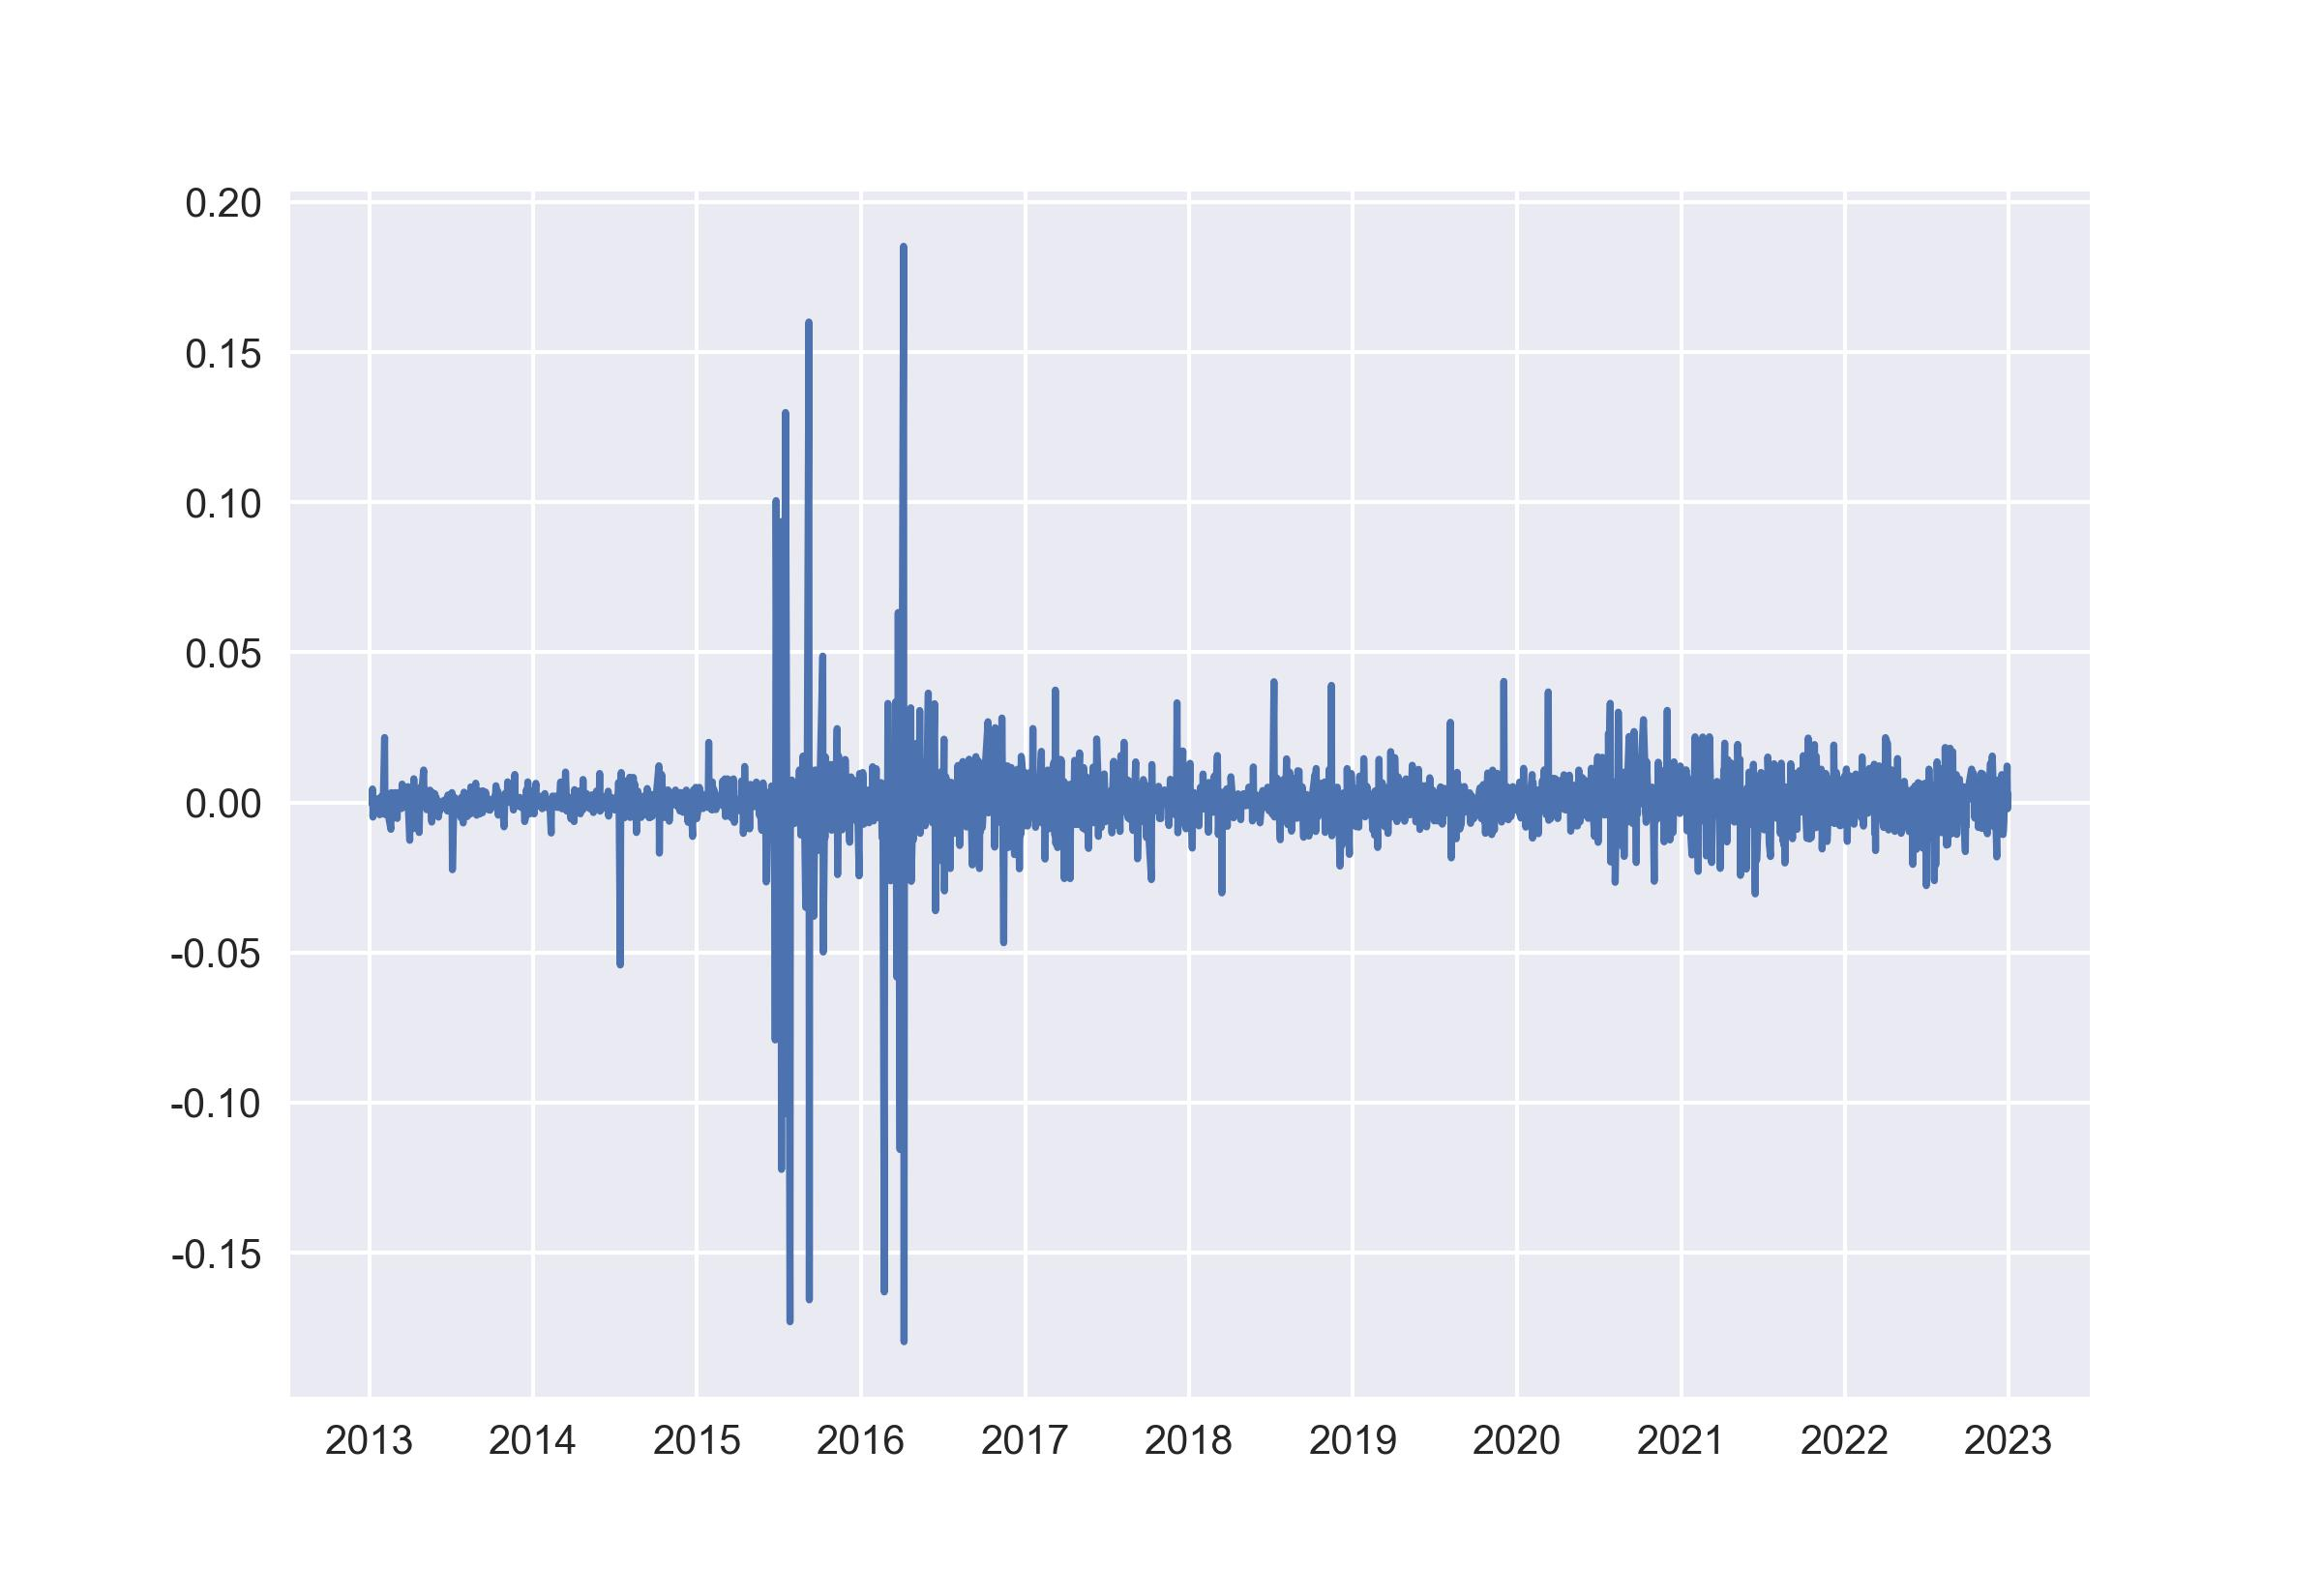
收益率围绕 0 波动,2015 到 2016 年出现幅度超过 ±0.15 的剧烈波动簇,之后明显收窄——金融收益率序列的波动聚集特征一览无余。这就像天气里的台风季:大波动往往扎堆出现,平静期则持续平静(行业术语:波动聚集效应)。
玉米期货对数收益率序列:2015-2016年波动聚集特征
LSTM对数收益率回归:训练与验证损失收敛曲线
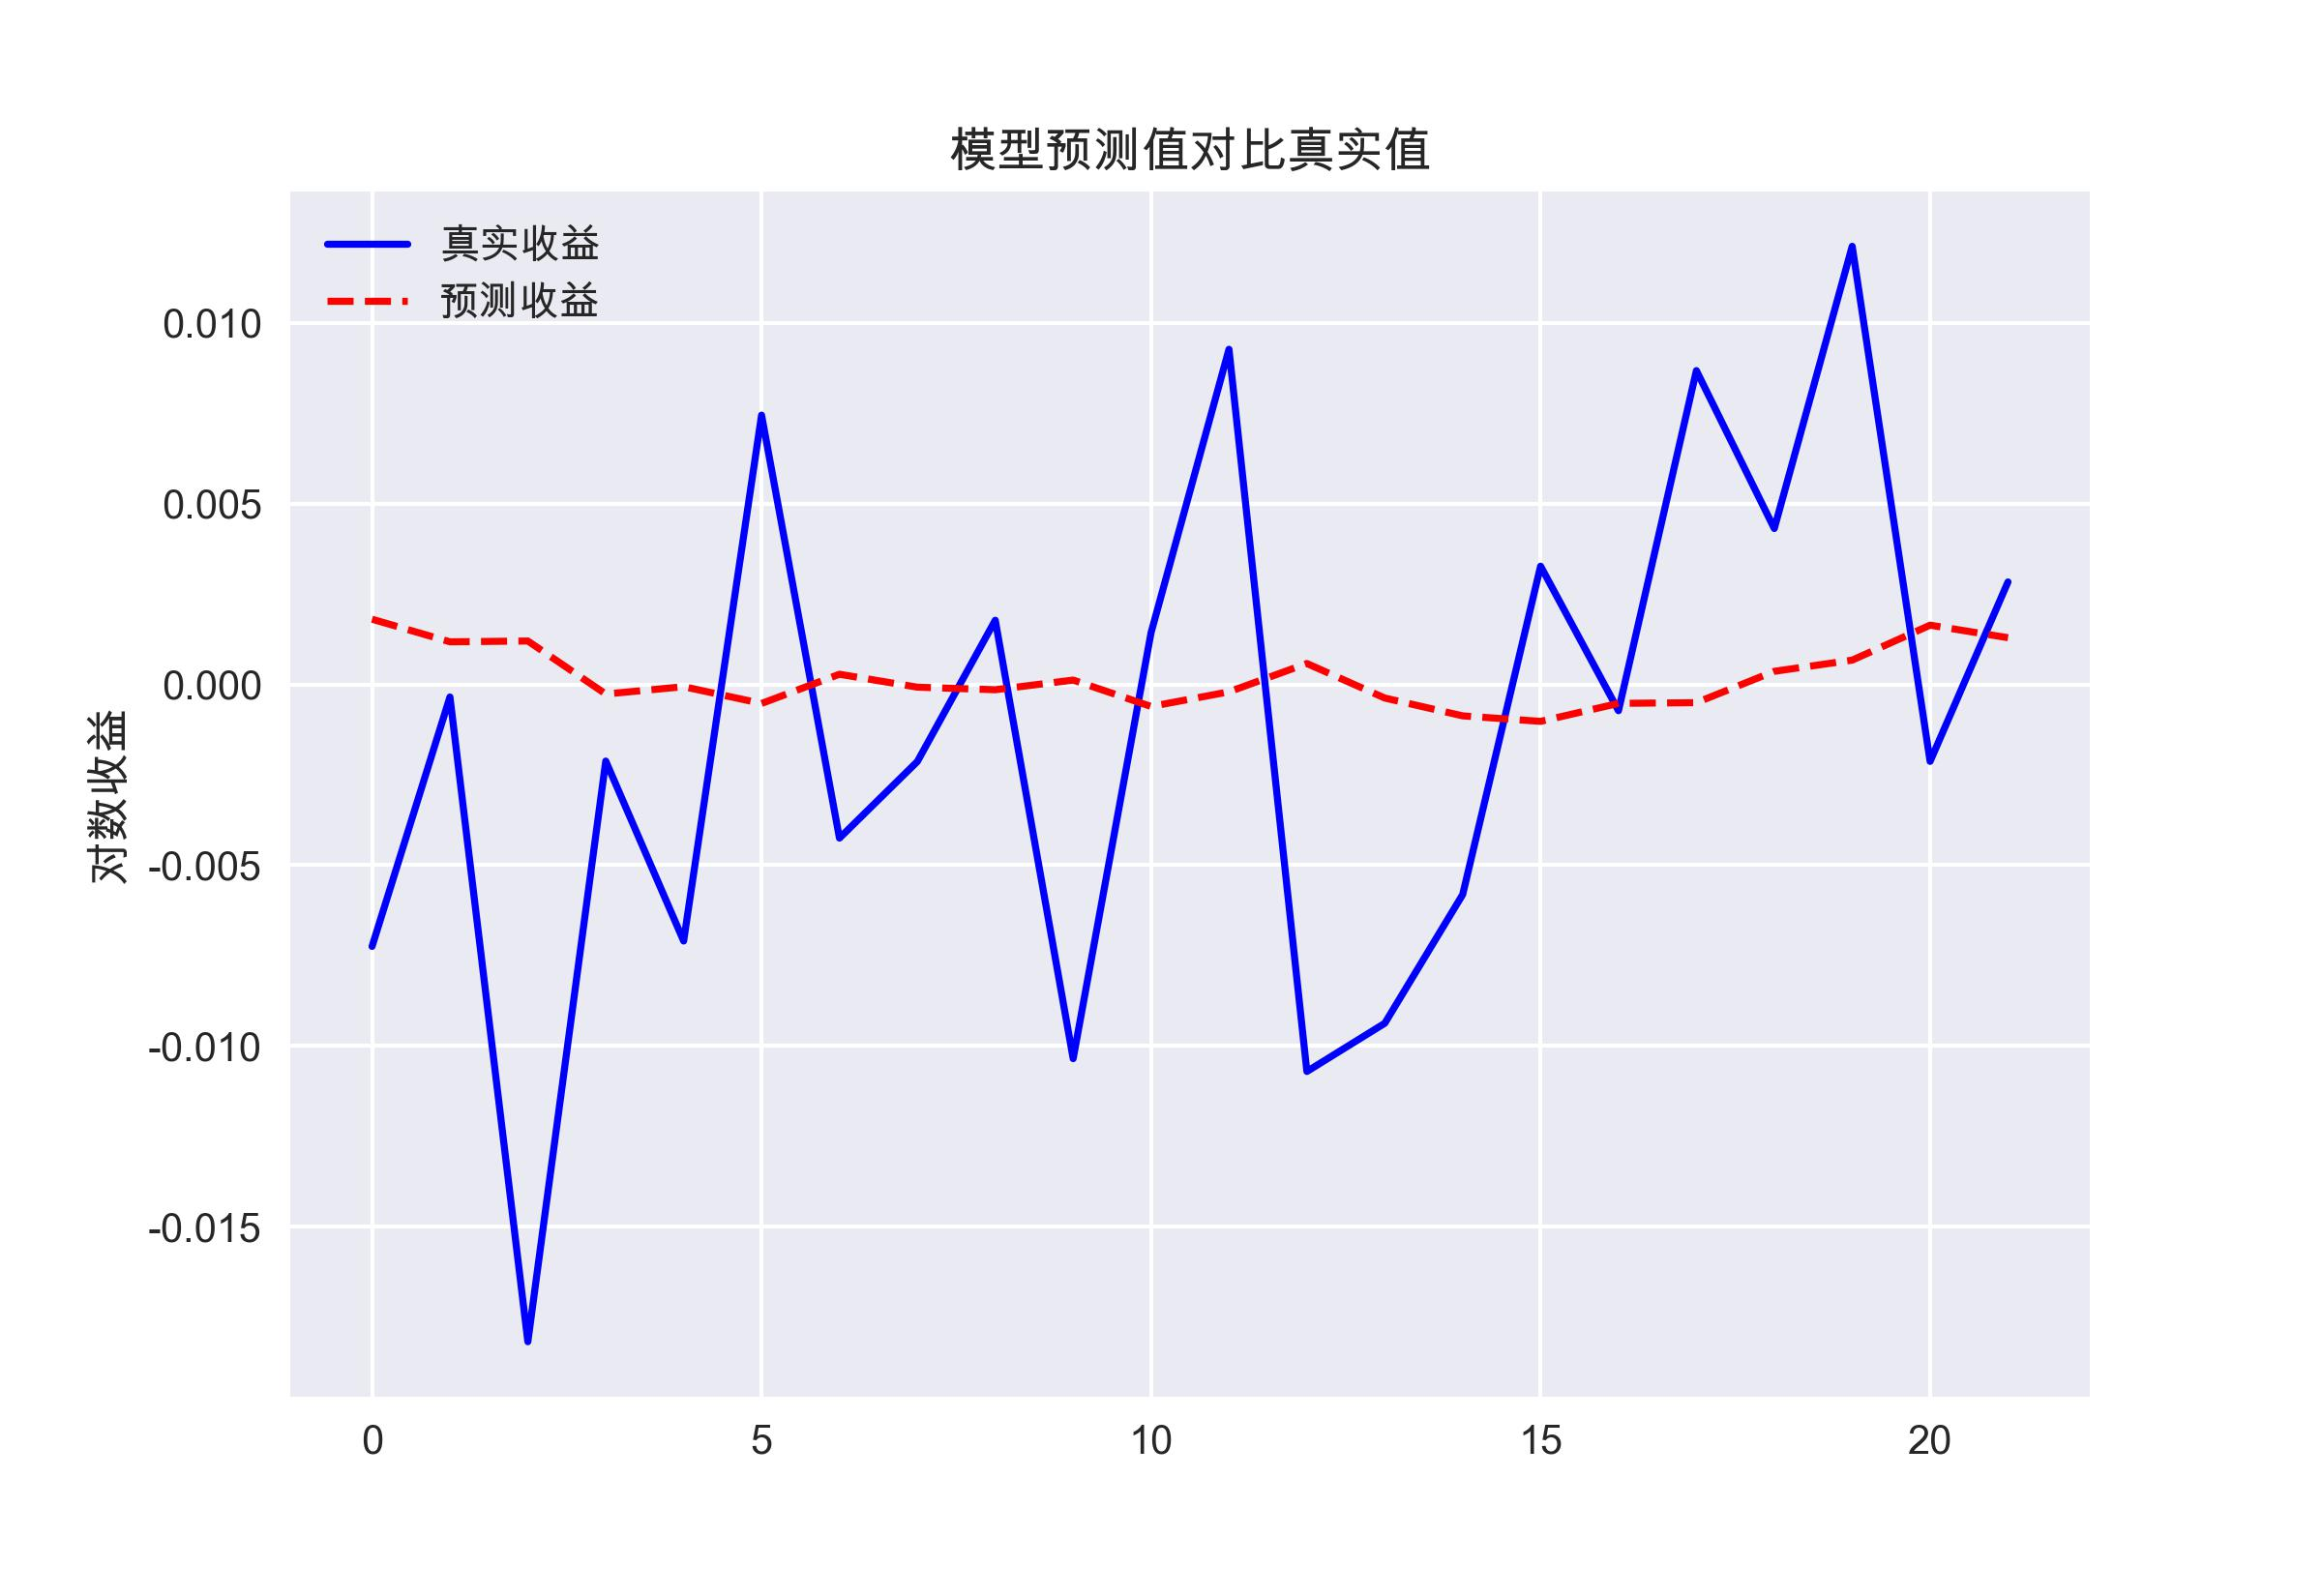
损失收敛得很漂亮,但预测值几乎是一条贴着 0 的水平线,而真实收益在 ±1% 以上剧烈跳动。模型在均方误差损失下选择了最保险的答案——输出无条件均值。这印证了金融计量的经典结论:收益率接近随机游走,条件均值极难预测,能预测的往往是波动率而不是收益方向。
模型训练设置:CNN涨跌分类与TA-Lib技术指标
本章核心结论:把回归改造成二分类后,模型输出才具备交易价值;技术指标特征与合理的标签设计是关键。
提示词:把回归问题改成涨跌分类
背景:回归路线两次碰壁,我想不问”明天涨多少”,只问”明天涨不涨”。目标:以上涨为 1、下跌为 0 构造标签,检查标签分布,再用一维卷积网络做二分类。约束:卷积层 64 个卷积核、核长 3,接池化与全连接,输出层用 sigmoid,损失用二元交叉熵,时间序列切分严禁打乱,最后 242 条(2022 全年)留作测试集。
LSTM对数收益率回归:预测值退化为贴零水平线与真实收益对比
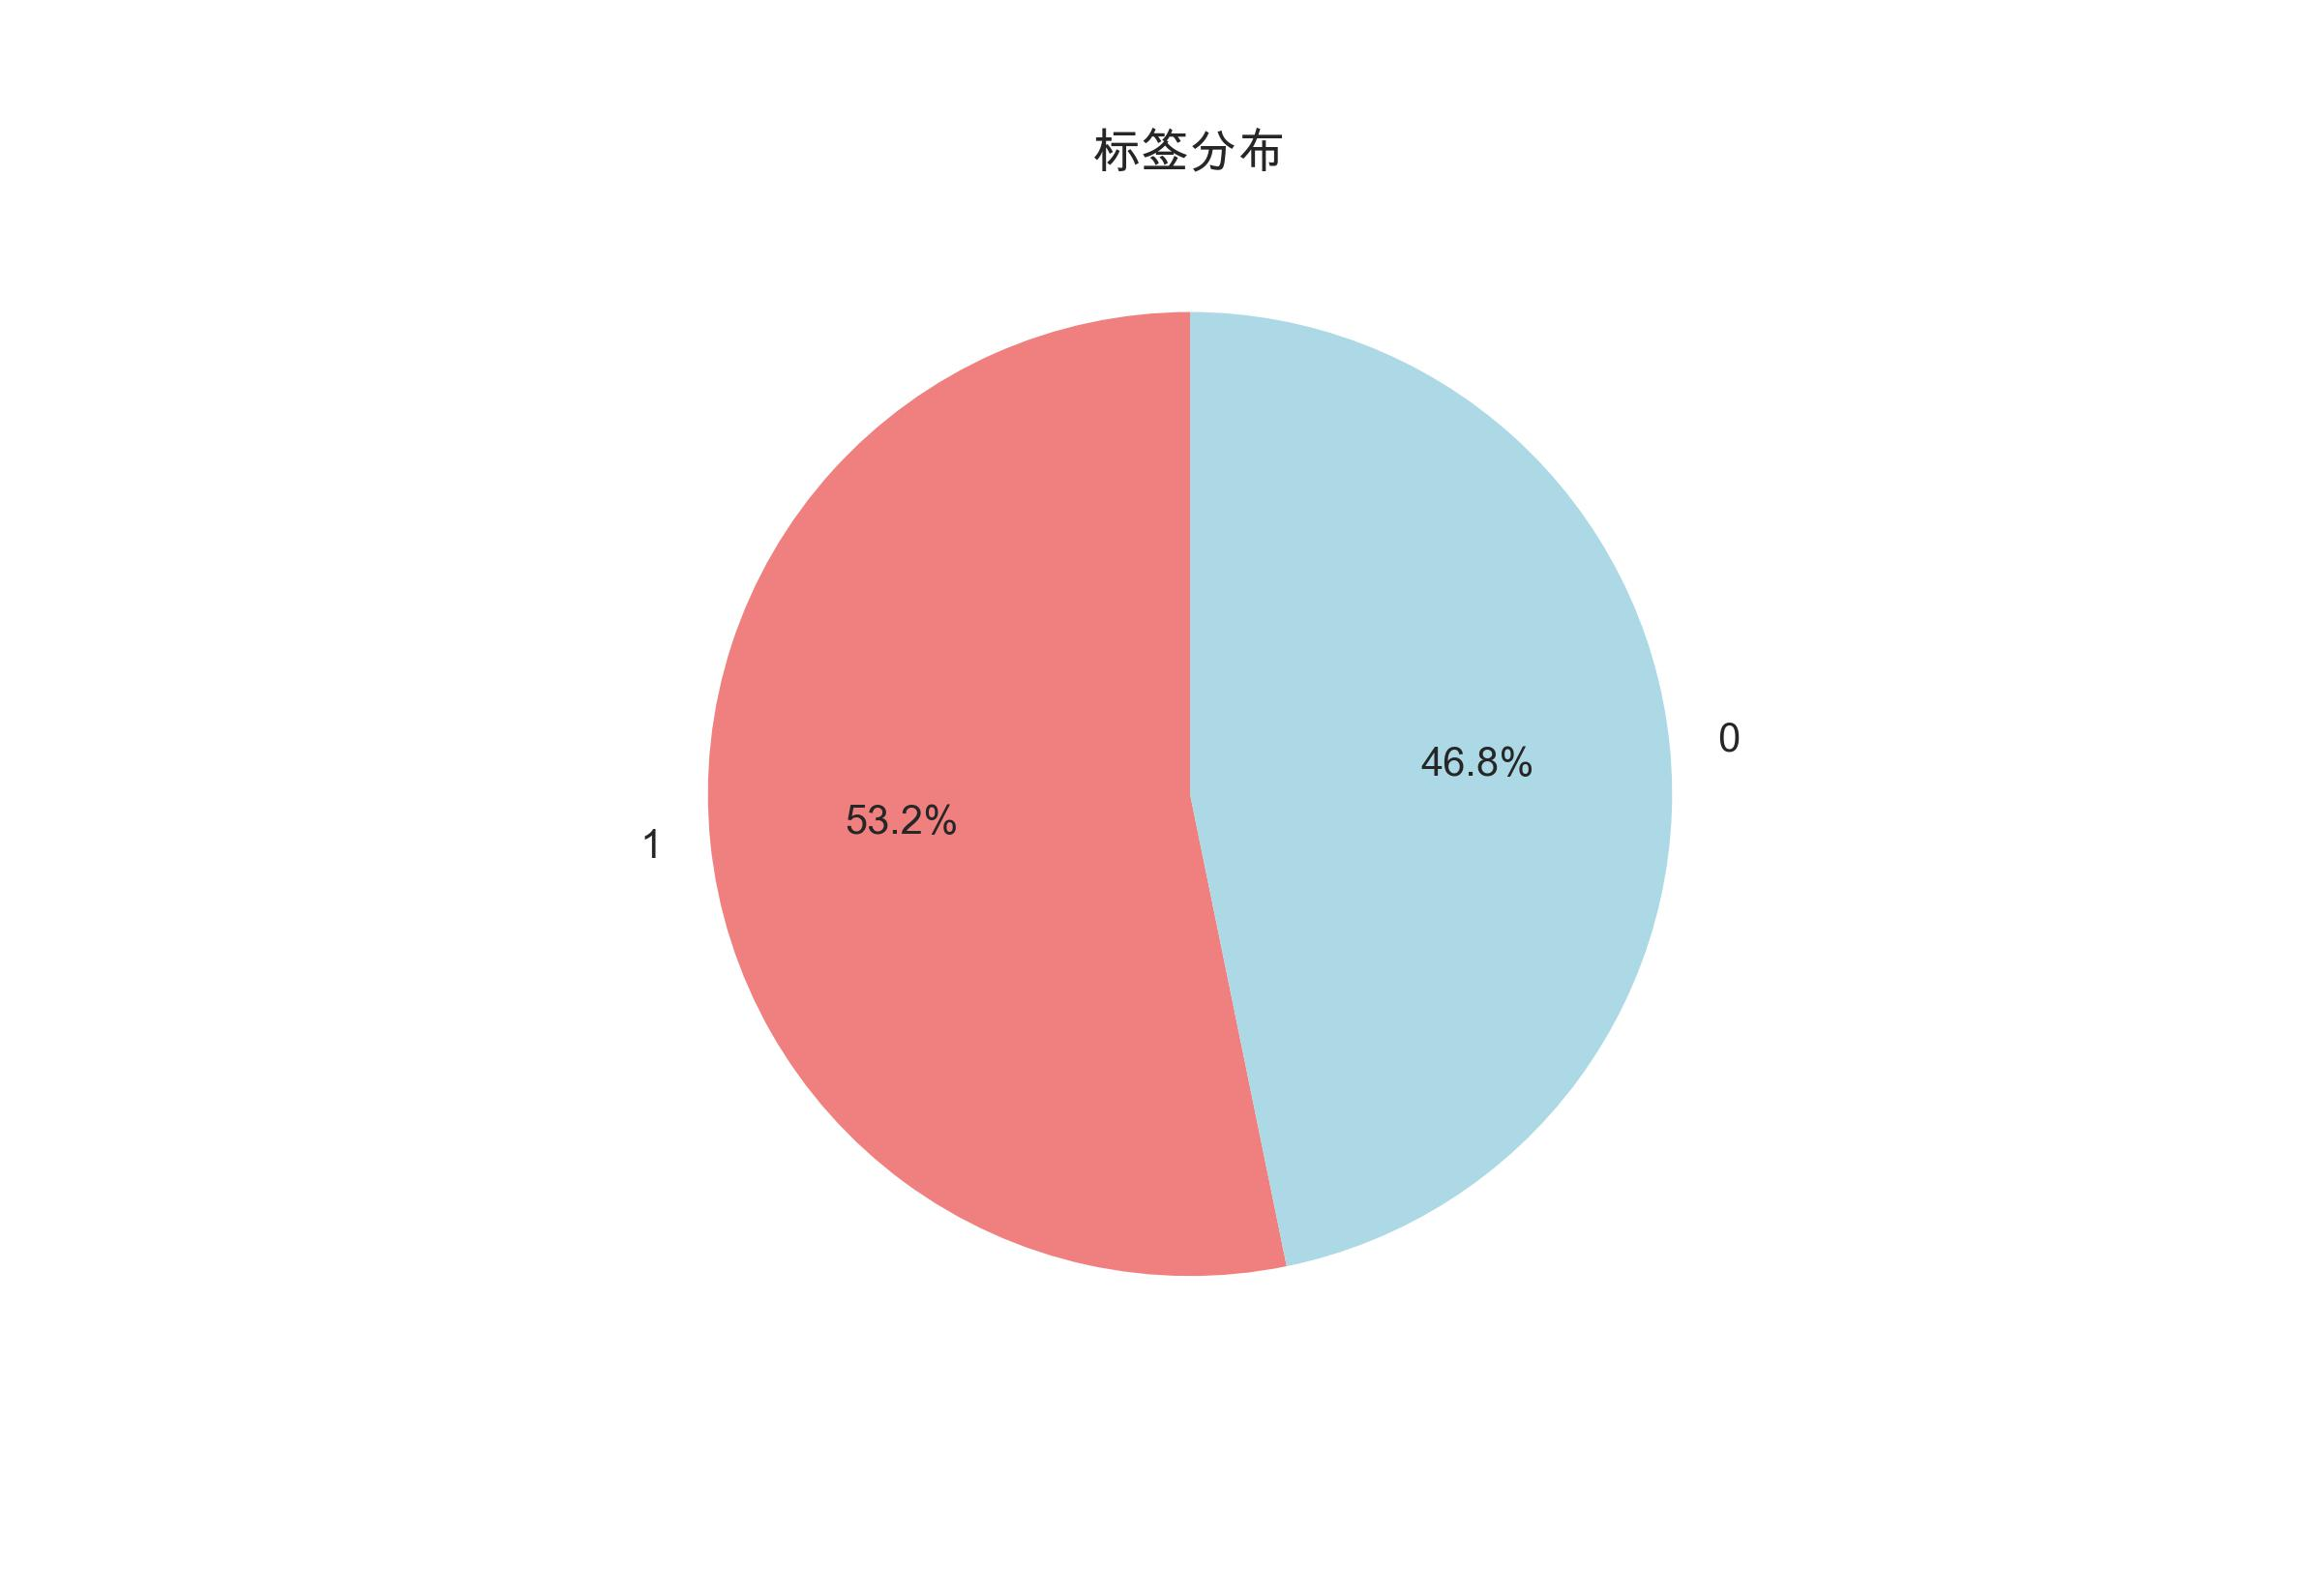
标签 1 占 53.2%、标签 0 占 46.8%,两类基本均衡,可以直接用准确率评估。顺便回答一个高频疑问:类别接近均衡,准确率才不会骗人;若遇到 7 比 3 的失衡行情,就要改用查准率、查全率或 F1 分数。
CNN 的卷积核在时间轴上滑动提取局部形态,像一台”技术形态识别器”,计算效率也高于 LSTM。输出层用 sigmoid 把预测压到 0 到 1,表示次日上涨的概率;训练目标是二元交叉熵:L = −平均[y·log(p) + (1−y)·log(1−p)],p 为模型给出的上涨概率。
提示词:加入 TA-Lib 技术指标特征
背景:只用收盘价特征太单薄,实盘交易员都会看指标。目标:计算 RSI、KDJ、动量、MACD 与 5 日成交量均线共 7 个技术特征,标签改为按次日收盘涨跌打标,重新训练分类模型。约束:请用 TA-Lib 计算指标,指标窗口产生的前置缺失要剔除,回看窗口加长到 30,卷积核加宽到 7,早停耐心降到 3。
指标补齐后特征矩阵是 30 日回看窗口乘 7 个技术指标,卷积核也从 3 加宽到 7,覆盖约一周半的指标形态,池化层去掉以保留更完整的时间结构。
Python、LSTM神经网络模型与沪深300、中证500股指预测|附AI 智能体 、代码和数据
内容概要:本文基于LSTM神经网络对沪深300与中证500指数进行预测建模,使用2008—2024年共3978个交易日的日频交易数据,按时间线划分训练集与测试集,以RMSE、MAE量化预测误差,并生成未来10个交易日的指数价格预测序列,可辅助制定相应的对冲策略。
探索观点测试结果与对比:玉米期货量化择时策略回测
本章核心结论:以预测标签驱动的择时策略在 2022 年样本外取得了远小于被动持有的回撤,风险调整后表现更优。
提示词:把预测标签落成可回测的择时策略
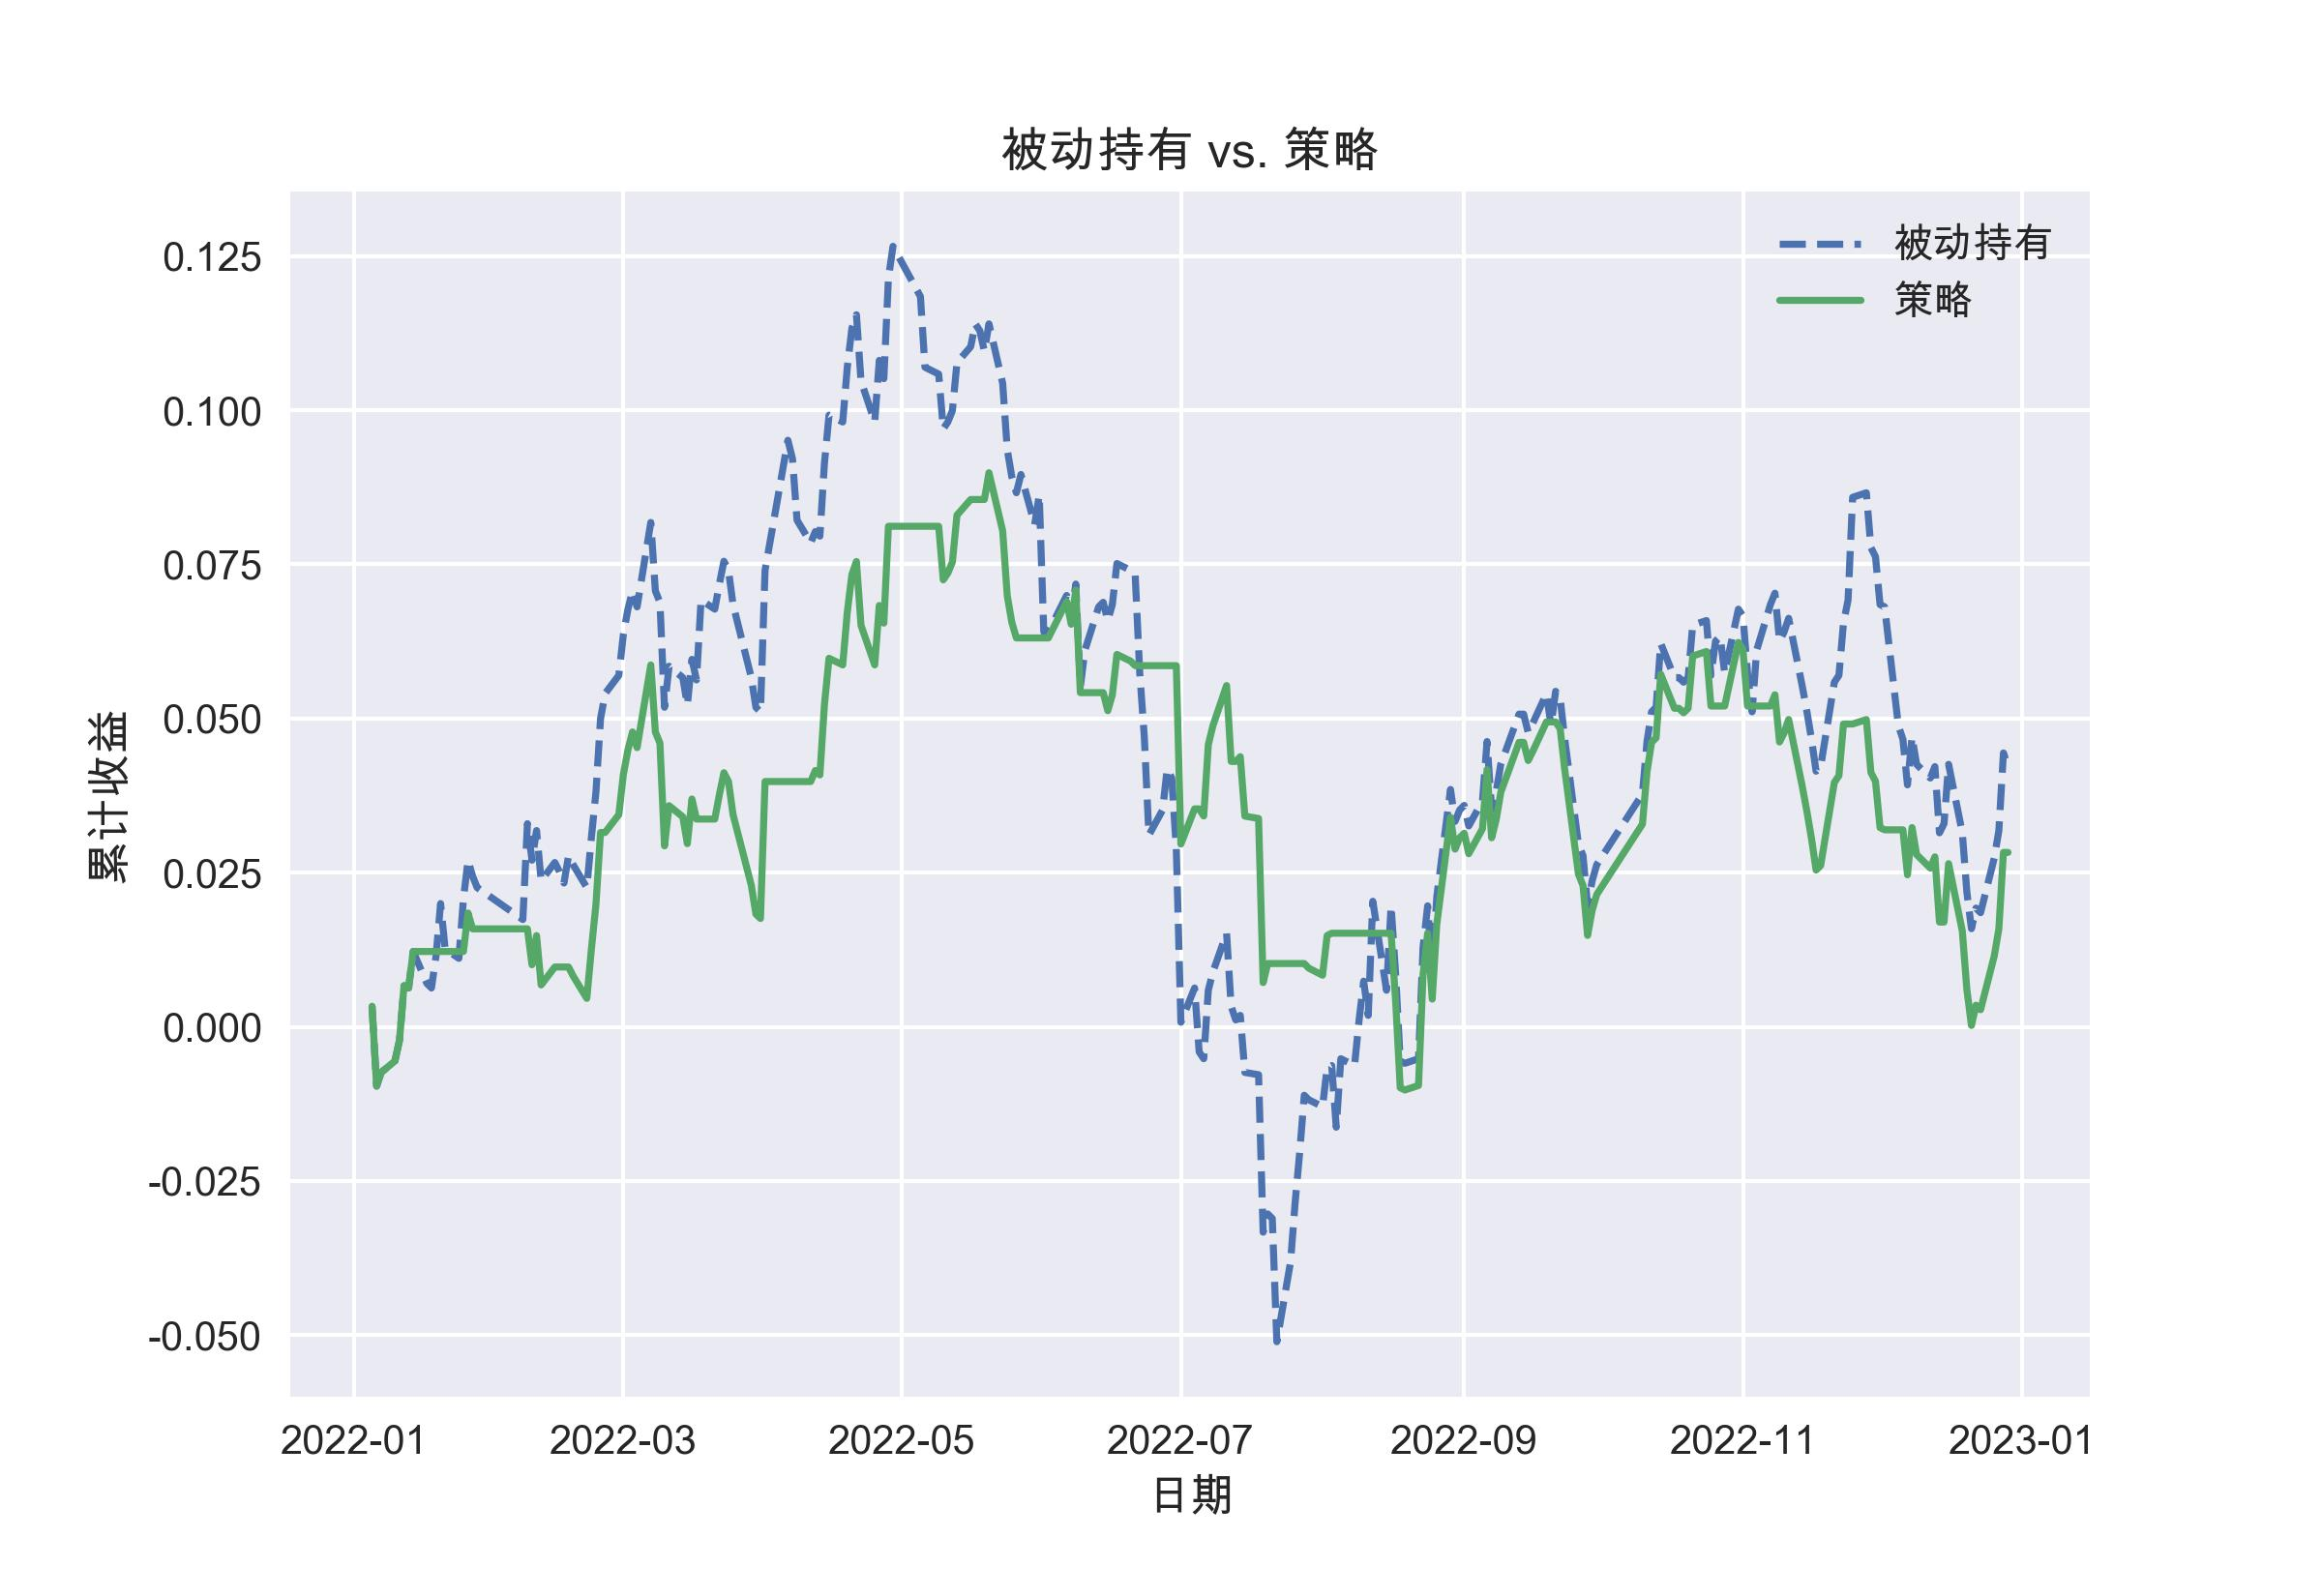
背景:分类模型已输出 2022 年每日的涨跌预测标签。目标:构造”看涨持仓、看空空仓”的择时策略,与被动持有对比全年累计收益。约束:仓位必须用前一日的预测标签对齐当日收益,杜绝未来函数;累计收益用逐日连乘计算。
玉米期货涨跌二分类:标签分布上涨53.2%与下跌46.8%
2022 年玉米期货先涨后崩再修复:被动持有 5 月最高冲到约 +12.6%,7 月初最深跌至约 −5.2%,年末收于约 +4.3%;策略曲线明显更平滑,最高约 +8.9%,7 月低点约 −1%,年末收于约 +2.8%。策略的绝对收益略低于被动持有,但最大回撤大幅收窄,以”每承受一单位回撤换取的收益”衡量,风险调整后表现更优。分类模型给出的不是精确价格,而是可执行的仓位信号——这才是它真正的价值。
建模路径对比:
| 建模阶段 | 模型 | 预测目标 | 实测表现与结论 |
|---|---|---|---|
| 直接回归 | LSTM(50) | 收盘价(未归一化) | 损失发散至 10^6 量级,预测与真实完全脱节 |
| 归一化回归 | LSTM(50) + MinMax | 收盘价 | 曲线吻合但滞后一天,退化为朴素预测 |
| 收益率回归 | LSTM(50) | 对数收益率 | 预测值退化为近似 0 的常数 |
| 涨跌分类 | Conv1D + sigmoid | 次日涨跌 | 输出可用仓位信号,2022 年回撤显著更小 |
做成一个可交互 Agent
1. 为什么要做成 Agent?
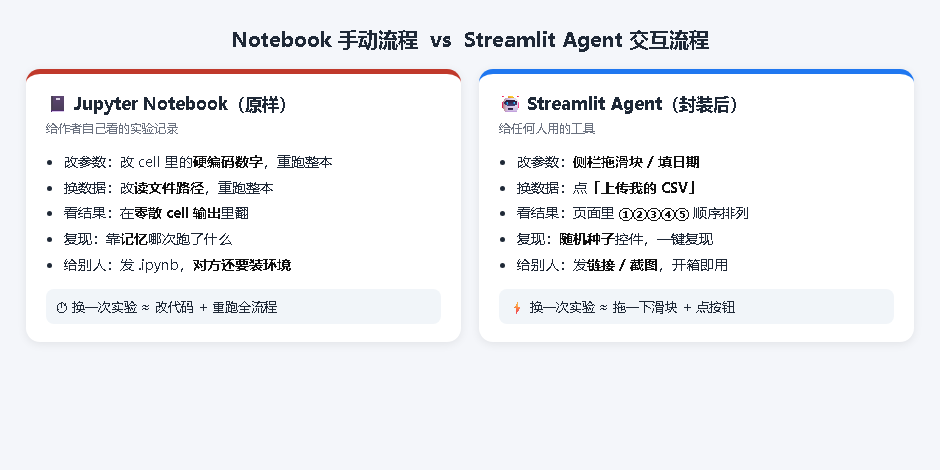
左侧”Jupyter Notebook 手动流程” vs 右侧”Streamlit Agent 交互流程”的对比示意,用两张卡片呈现差异:手动改代码/重跑 vs 上传文件/拖滑块/点按钮
玉米期货量化择时策略回测:2022年策略与被动持有累计收益对比
| 维度 | 原 Notebook | 封装后的 Agent |
|---|---|---|
| 改参数 | 改 cell 里的硬编码数字,重跑 | 侧栏拖滑块 / 填日期 |
| 换数据 | 改读文件路径,重跑 | 点「上传我的 CSV」 |
| 看结果 | 在零散 cell 输出里翻 | 一个页面里 ①②③④⑤ 顺序排列 |
| 复现 | 靠记忆哪次跑了什么 | 固定随机种子,一键复现 |
| 给同事看 | 发 .ipynb,对方还得装环境 | 发链接 / 截图,开箱即用 |
2. 拆解
原文的流水线其实是一条清晰的链路,先把每一步拆成”输入 → 处理 → 输出”的契约,后面才能封装成函数:
- 读取数据:
玉米十年行情数据.xlsx(2428 行,2013-01-04 ~ 2022-12-30,列:日期/开盘价/最高价/最低价/收盘价/成交量)→ 日期索引 DataFrame。 - 特征工程:用
talib算 RSI、随机指标 STOCH、动量 MOM、MACD、成交量均线。Windows 上 TA-Lib 没现成 wheel,我们用 pandas 等价实现(下文标注「此处根据原文逻辑补充」)。 - 构造监督样本:滑窗——用过去
n_steps天的数据,预测下一天。回归任务预测价格/对数收益;分类任务预测”涨(1)/跌(0)”。 - 建模训练:实验二/三用 LSTM 回归(预测收盘价/对数收益);实验四/五用 CNN 分类(预测涨跌,实验四看收盘价序列、实验五看 7 个技术指标)。
- 评估与回测:回归看 RMSE/MAE/MAPE;分类看准确率、混淆矩阵;实验五末尾做”预测涨则次日持仓”的策略回测,对比被动持有。
- 总记录 2428 个交易日;训练区间 2013 ~ 2021,测试区间 2022 全年 242 个交易日。
- 涨跌标签:
log_return >= 0记为 1(涨),占比约 53.2%;0(跌)约 46.8%(基本均衡,可直接用准确率评估)。 - 五个任务对应的原文实验:
lstm_close:LSTM 回归·收盘价(实验二,MinMax 归一化)lstm_logret:LSTM 回归·对数收益(实验三)cnn_close:CNN 分类·收盘价序列(实验四,lookback=20)cnn_tech:CNN 分类·技术指标(实验五,lookback=30 / 7 特征)
原文的事实数字(全流程唯一数字来源,教程/代码/样例数据必须一致):
重要提醒:深度学习结果受随机初始化影响,重跑不会逐位相同。原文公布的准确率只是”基准附近的一个值”,我们的 Agent 提供「随机种子」控件(默认 42),固定后结果可复现;不固定时通常在基准值附近小幅波动。这是正常现象,不是 bug。
3. 目标形态:Agent 长什么样
我们用 Streamlit 搭界面(Python 写前端,不用学 HTML/JS)。整体交互顺序:
- 页面顶部标题 + 副标题。
- 侧栏(左):数据源选择、任务下拉、时间步长/训练轮数/早停/单元数/随机种子滑块、训练与测试区间、主按钮「开始训练并生成报告」。
- 主区(右) 分五块顺序渲染:
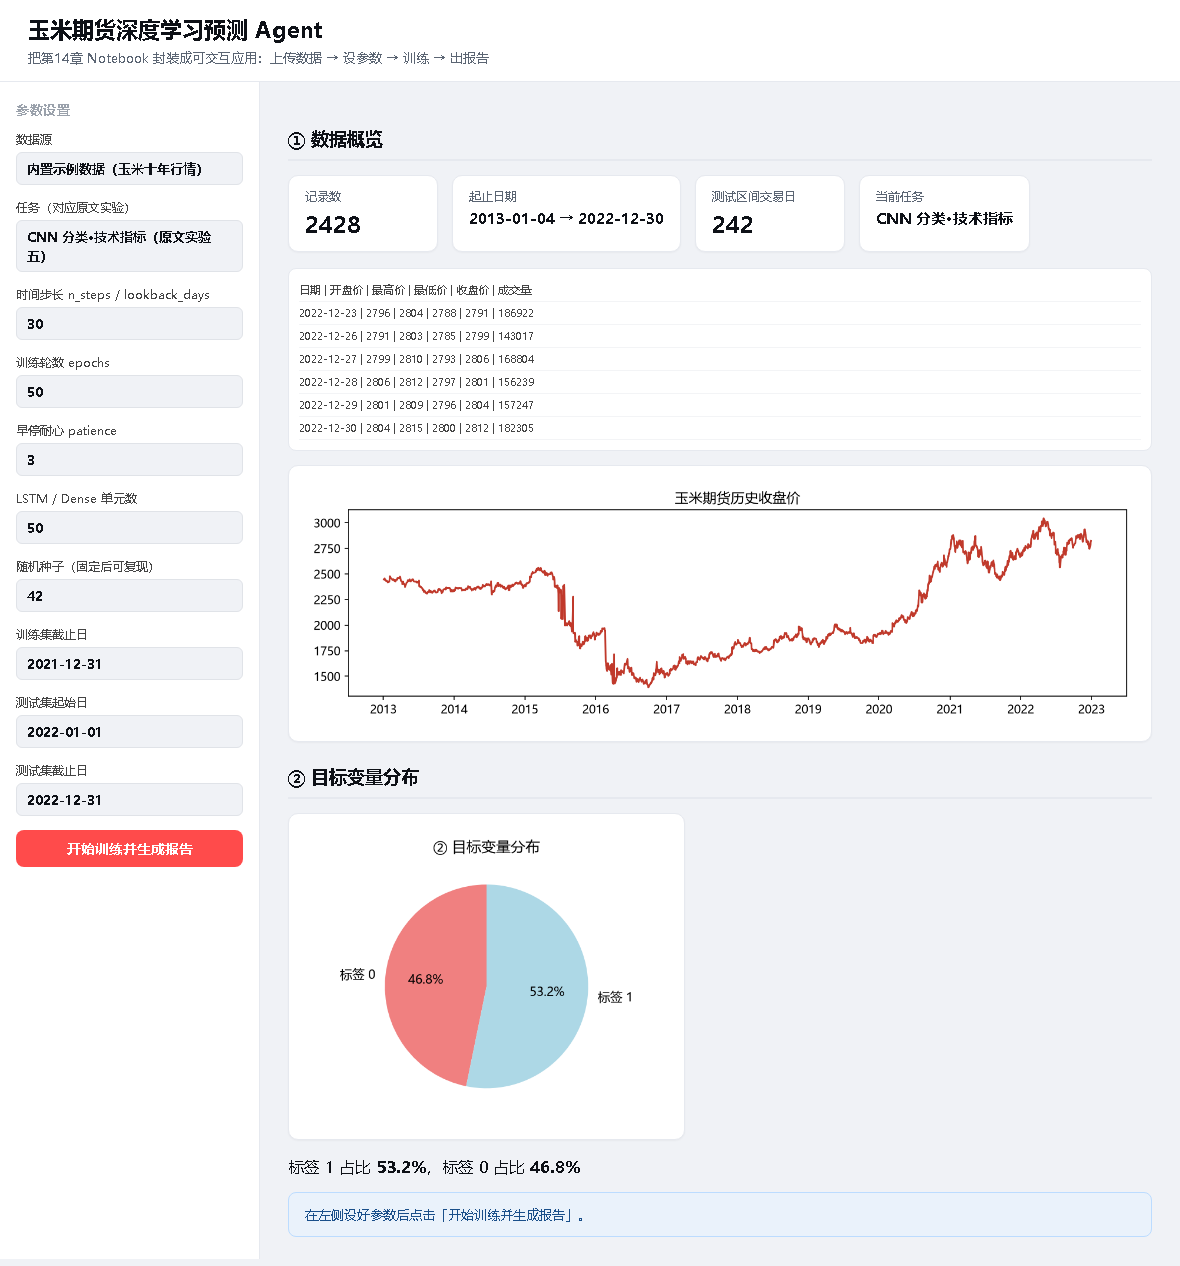
- ① 数据概览:记录数、起止日期、测试区间交易日数、当前任务 4 个指标卡 + 原始表尾 + 收盘价走势图。
- ② 目标变量分布:分类任务显示涨跌标签饼图;回归任务显示收盘价/对数收益曲线。
- ③ 训练过程:Train/Validation Loss 曲线 + 实际训练轮数。
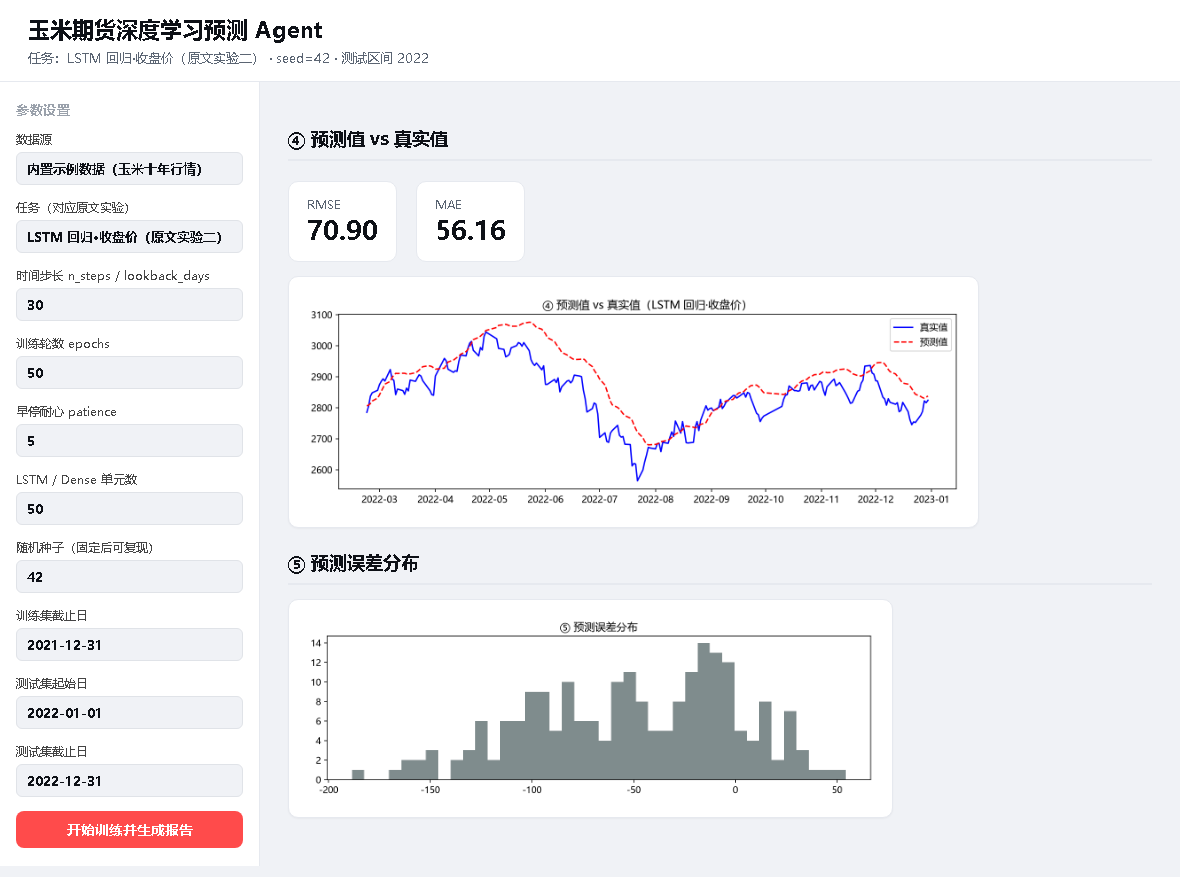
- ④ 预测值 vs 真实值:回归显示双线对比 + RMSE/MAE/MAPE;分类显示混淆矩阵 + 准确率。
- ⑤ 回测与绩效:分类显示「策略 vs 被动持有」累计收益曲线 + 绩效表;回归显示误差分布直方图。
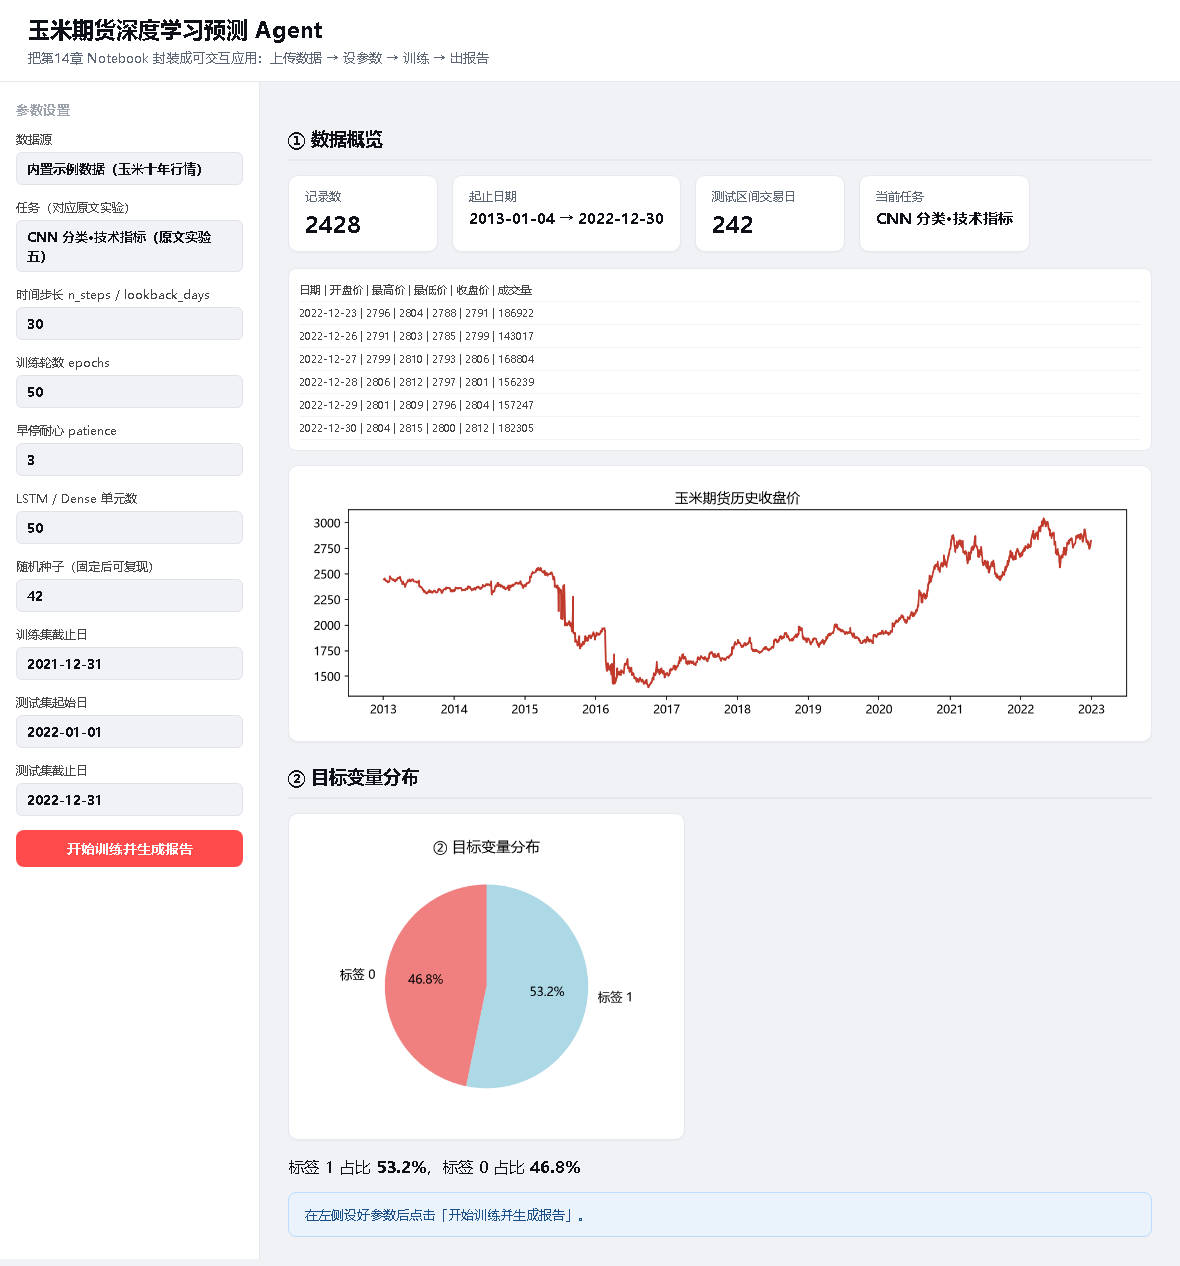
Streamlit 初始空界面——左侧栏参数齐全、右侧主区只显示 ① 数据概览 与 ② 目标变量分布,下方提示”设好参数后点击开始训练并生成报告”
界面一上来就先画 ①②,是故意的:让用户在训练前先”看一眼数据对不对”,避免训练半小时才发现数据读错了。这是 Agent 比 Notebook 体验好的细节之一。
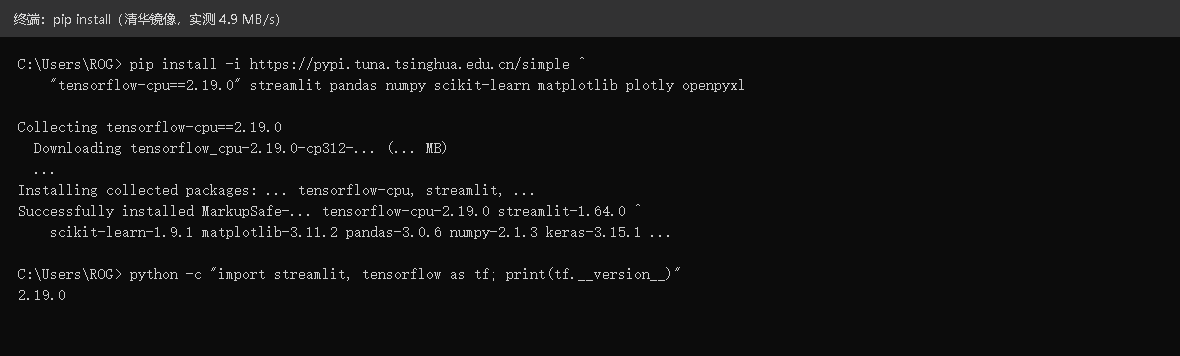
4. 环境与安装
需要的库:streamlit、pandas、numpy、scikit-learn、matplotlib、tensorflow-cpu(CPU 版够用,训练数据量小)、openpyxl(读 xlsx)。
第 0 步先检查磁盘:全家桶约 1 GB,venv 务必建在可用空间 > 5 GB 的盘(实测 C 盘只剩 540 MB 时,装到 37 分钟才报 No space left on device)。TensorFlow 目前没有 Python 3.13 的 wheel,请用 3.12。
侧栏参数区特写——数据源=内置示例数据、任务=CNN 分类·技术指标、lookback=30、epochs=50、patience=3、units=50、seed=42、训练截止 2021-12-31、测试 2022-01-01~2022-12-31
验证装好了:
python -c "import streamlit, tensorflow as tf; print(tf.__version__)"# 应输出 2.19.0
5. 数据准备:CSV 列规范
Agent 读取的 CSV 至少要有这些列(与原文 xlsx 一致):
日期,开盘价,最高价,最低价,收盘价,成交量2013-01-04,2430,2445,2428,2440,123456...
- 日期列会被
pd.to_datetime解析并设为索引。 - 原文配套的
玉米十年行情数据.xlsx我们直接转成 CSV(data/corn_futures.csv,UTF-8-SIG 编码),不是凭空造数——这样能反算出原文的 2428 行、2022 年 242 个交易日、标签 1 占比 53.2%。 - xlsx 里有
成交额等列也无妨,load_data只取需要的几列。
终端执行 pip install 安装成功的末尾界面,显示 Successfully installed streamlit-x.x、tensorflow-cpu-2.19.0 等
6. 骨架搭建:侧栏收参 → 主区分段渲染
Streamlit 的执行模型是”脚本每次交互重跑一遍”。我们用「侧栏定义控件 → 主区先画 ①② → if not go: st.stop() → 再画 ③④⑤」的两段式,保证没点按钮前不触发训练:
① 数据概览界面——4 个指标卡显示”记录数 2428 / 起止 2013-01-04 → 2022-12-30 / 测试区间交易日 242 / 当前任务 CNN 分类·技术指标”,下方是收盘价走势红线图
为什么用
st.stop()而不是if go:包住后面所有代码?因为 ③④⑤ 依赖训练结果对象,用st.stop()提前结束脚本更干净,也不会因为缩进套太多而出错。
7. 核心模块逐个实现
7. 1 数据读取 load_data
读 CSV/xlsx → 日期索引。支持上传文件(UploadedFile)或默认内置数据。
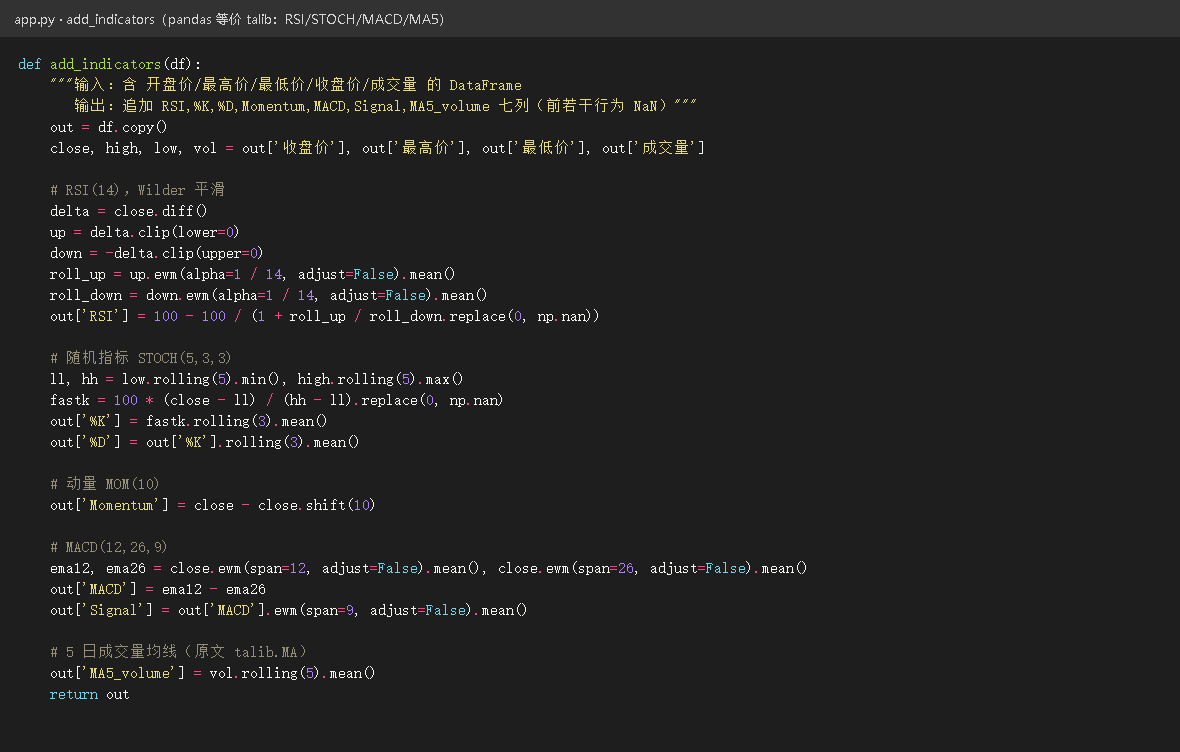
7. 2 技术指标 add_indicators(pandas 等价 talib)
原文用 talib,Windows 装不上,我们给出等价的 pandas 实现。
代码编辑器里,上面这段”侧栏 + st.stop() 两段式”的高亮代码
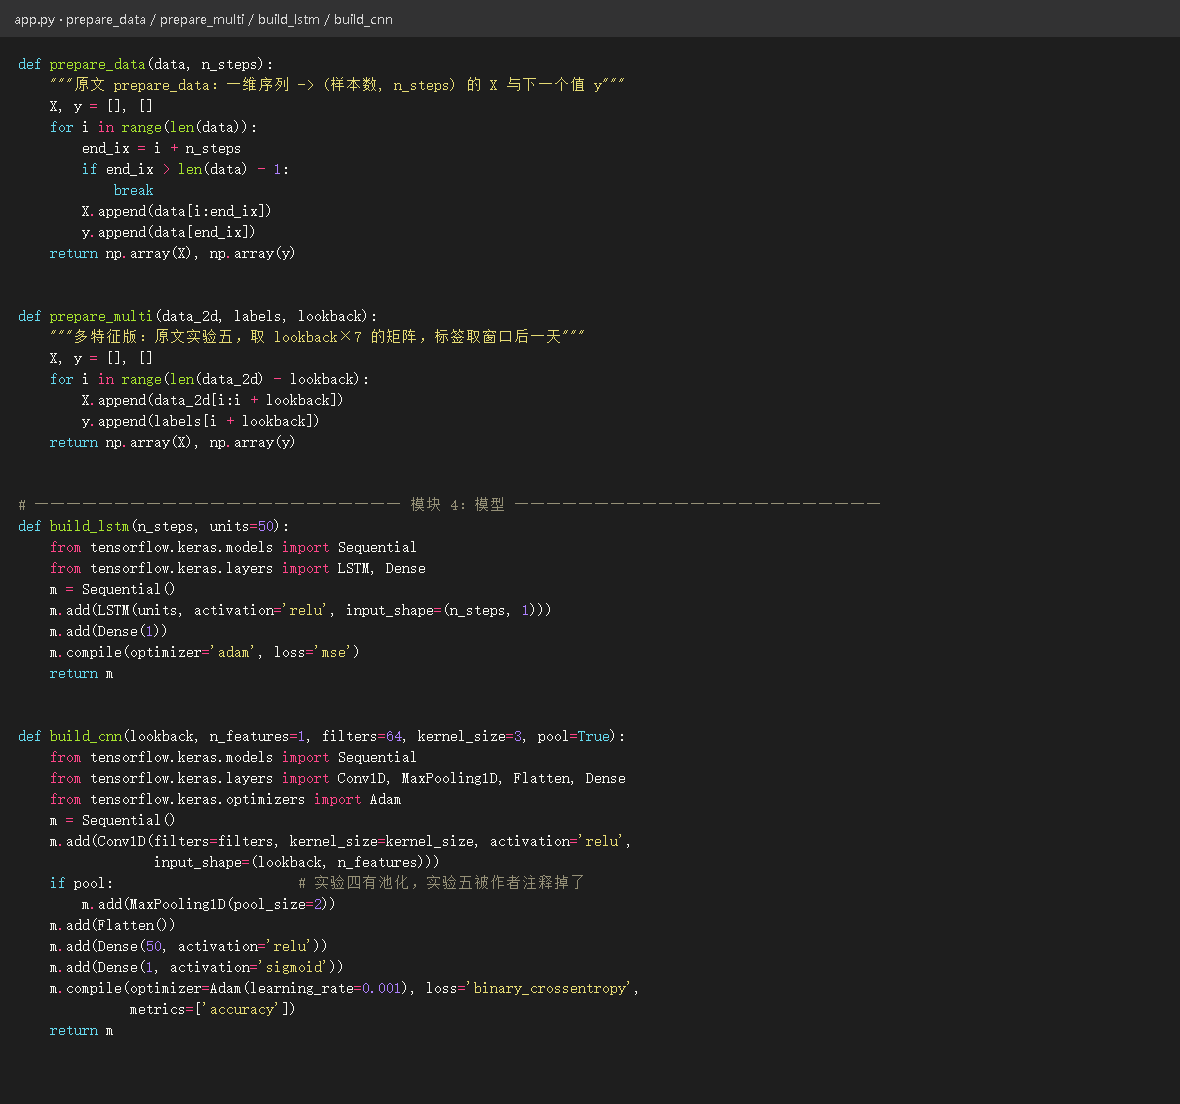
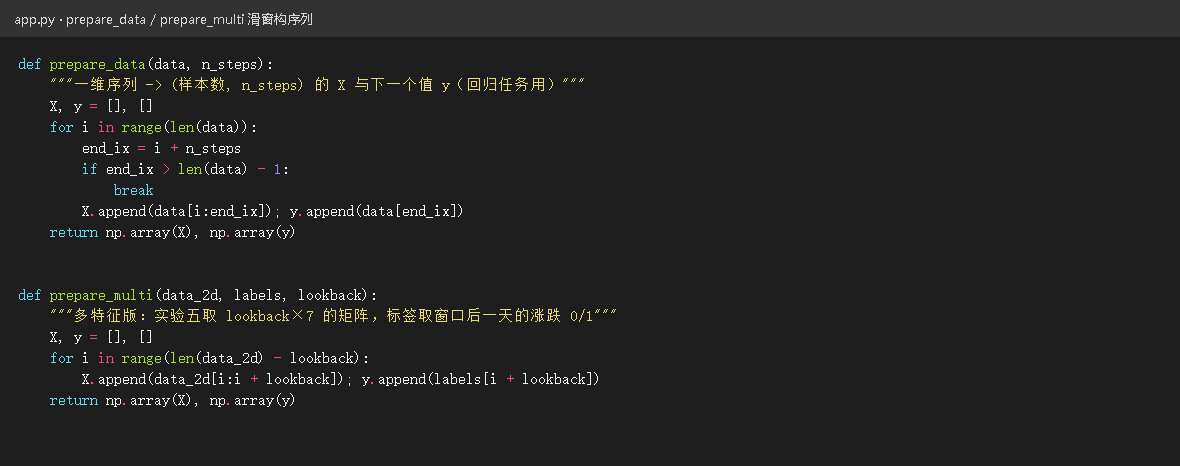
7. 3 滑窗 prepare_data / prepare_multi
把一维/二维序列切成 (样本, 窗口) 的监督学习格式。
add_indicators 函数高亮代码——RSI 用 ewm(alpha=1/14) 的 Wilder 平滑、STOCH 用 rolling(5) 的 min/max、MACD 用 ewm(12/26/9)、MA5_volume 用 rolling(5)
7. 4 模型 build_lstm / build_cnn
Keras Sequential。build_cnn 的 pool 参数区分实验四(有池化)和实验五(作者注释掉了池化)。
7. 5 评估 perf_table / run_backtest
分类任务做”预测涨→次日持仓”的策略回测,和被动持有比累计收益。
三个细节别省:① 训练/测试区间用字符串字典序切片(
df.loc['2022-01-01':'2022-12-31']),因为 pandas 读进来的日期索引在某些环境是字符串;② 区间不能重叠,否则用到未来函数,Agent 在后端硬校验并st.error报错;③ 准确率与原文口径一致(53.2% 标签比下的准确率)。
8. 参数怎么调(以及调错会怎样)
| 参数 | 含义 | 调太高/太低会怎样 |
|---|---|---|
时间步长 lookback | 用过去几天预测下一天 | 太小学不到趋势,太大样本少易过拟合 |
训练轮数 epochs | 最多迭代次数 | 配早停后一般跑不满;太小欠拟合 |
早停耐心 patience | 验证损失多少轮不降就停 | 太小可能提前停,太大白跑 |
随机种子 seed | 固定初始化 | 固定后可复现;不固定每次结果略波动 |
| 训练/测试区间 | 在哪切分样本外测试 | 重叠=用未来函数,Agent 直接报错停 |
任务 task_key | 选 LSTM 回归 / CNN 分类 | 分类看准确率,回归看 RMSE,指标不同 |
③ 训练过程界面——Train/Validation Loss 双线随 Epoch 下降,下方文字”实际训练轮数 5 轮(EarlyStopping patience=3)”
④ 预测对比界面(分类)——3.6×3.0 混淆矩阵热力图,标题”混淆矩阵”,上方大号指标卡”模型准确率 49.6%”
⑤ 回测界面——”被动持有 vs. 策略”累计收益双线图,下方绩效表两行(被动持有 / CNN 策略,含累计收益/年化/夏普/最大回撤)
注意准确率约 49.6% 这一数字:玉米日涨跌本身接近随机(标签 1 才 53.2%),所以这个任务本质很难,50% 左右是合理水平,原文也在这个量级。本例在固定随机种子 = 42 下跑出 49.6%,换种子通常在 48%~55% 之间波动。Agent 的价值是让你秒级切换模型/参数对比,而不是宣称能稳赚。
9. 可测试页面版本
你自己有别的期货 CSV,只要列名一致,点「上传我的 CSV」即可换数据跑。
整页报告(cnn_tech 任务)从上到下的长截图——标题、①数据、②饼图、③Loss、④混淆矩阵+准确率、⑤回测曲线+绩效表,五区块完整排列
prepare_data 与 prepare_multi 两个函数的高亮代码——前者一维回归、后者多特征分类,均用 for 循环滑窗
第二组实验 lstm_close 回归界面——④ 预测值(红虚线) vs 真实值(蓝实线) 双线对比 + RMSE/MAE 指标卡,⑤ 误差分布直方图
局限性与失败分析
基于原文事实,本文方法存在以下局限,全部如实列出:
- 数据泄露隐患:MinMaxScaler 在全样本上拟合,严格做法应只用训练集拟合,原文代码未做切分。
- 滞后陷阱未根治:归一化后的价格回归仍是朴素预测的变体,原文未提供相对朴素预测基准的误差对比。
- 收益回归退化:对数收益率模型输出退化为近似 0 的常数,说明该目标在该设定下不可回归,原文未继续做波动率建模。
- 消融信息缺失:技术指标版本的分类准确率、混淆矩阵等指标原文未给出具体数值,消融对比原文未提供。
- 样本外区间单一:回测仅覆盖 2022 年一个年度、单一品种,未计交易成本与滑点,泛化能力有待多品种、多年份验证。
- 标签设计简化:涨跌标签未设阈值过滤微幅波动,噪声标签可能影响分类器训练。
系统实现与落地
整套流水线按”数据准备 → 切样函数 → 回归模型 → 分类模型 → 回测”组织为五个模块。
配套工具与资源
依赖说明:Python 3.x,核心依赖为 pandas、numpy、matplotlib、tensorflow(Keras 接口)、 scikit-learn 、TA-Lib。示例运行命令:python src/lstm_price.py(以代码包实际接口为准)。图表输出为 300dpi 的 jpg 文件,与文中图 14-1 至图 14-10 一一对应。
结论与展望
本文完成了一次完整的玉米期货深度学习建模路径对比:技术上,”价格回归→收益率回归→方向分类”的演进说明金融时序建模必须先识破量纲发散与滞后复制两类陷阱,再把问题改造成模型真正能回答的形式;业务上,CNN 涨跌分类驱动的择时策略在 2022 年样本外把最大回撤从约 −5.2% 收窄到约 −1%,适合作为量化择时的辅助模块嵌入现有风控流程。后续可引入成交量、持仓量、基差等多源特征,尝试 LSTM、Transformer 等序列模型做分类,调优概率阈值,并计入交易成本做更真实的回测。玉米期货价格预测的价值不在算准价格,而在生成可执行、可控回撤的仓位信号。
常见问题 FAQ
- 为什么未归一化的价格序列会让 LSTM 训练发散? 收盘价处于 1500 到 3000 的原始量级,均方误差损失对量级极其敏感,网络内部激活值饱和后无法收敛,验证损失在第 10 轮后反弹至约 5.1e6(见文中损失曲线)。
- 归一化后 LSTM 预测收盘价为什么滞后一天? 对接近随机游走的金融序列,均方误差损失下的近似最优解就是”复制昨天的价格”,预测线因此成为真实线右移一天的影子;判断模型有效必须先跑赢朴素预测基准。
- 玉米期货的对数收益率可以直接回归预测吗? 不能。模型在均方误差损失下输出退化为贴零水平线,即无条件均值;收益率接近随机游走,条件均值极难预测,能预测的往往是波动率。
- 为什么改用 CNN 做涨跌分类? 卷积核在时间轴上滑动提取局部形态,类似”技术形态识别器”,计算效率高于 LSTM;输出层 sigmoid 给出上涨概率,按阈值即可生成仓位信号。
- 入模的技术指标有哪些? TA-Lib 计算的 RSI、KDJ(%K、%D)、动量 MOM、MACD 及信号线、5 日成交量均线,共 7 个特征,构成 30 日回看窗口的特征矩阵。
- 时间序列数据为什么不能随机打乱后划分训练集测试集? 随机打乱会让未来信息泄露进训练集,评估失真;本文按时间线切分,最后 242 条(2022 全年)留作样本外。
- MinMax 归一化有什么容易踩的坑? 本文缩放器在全样本上拟合,存在轻微数据泄露;严格做法是只用训练集拟合,再套用到测试集。
- 回测如何避免未来函数? 仓位用前一日的预测标签对齐当日收益(position.shift(1)),即收盘时点决策、次日才产生收益,杜绝”用当天预测做当天决策”。
- 策略回测的实际效果如何? 2022 年样本外:策略年末累计收益约 +2.8%、7 月最大回撤约 −1%;被动持有年末约 +4.3%、最大回撤约 −5.2%。策略绝对收益略低,但风险调整后更优。
- 涨跌标签的类别分布是否均衡? 上涨标签占 53.2%、下跌占 46.8%,基本均衡,可直接用准确率评估;若失衡应改用查准率、查全率或 F1 分数。
- 本文数据从哪里来? 由拓端团队整理核对的玉米期货十年日频行情(2013—2022,含开高低收与成交量),全部内容真实有效。
- 能否把这套方法迁移到其他品种? 流水线可直接迁移,但需注意单品种单年度验证的局限,应做多品种、多年份滚动验证并计入交易成本后再评估实盘价值。
参考文献与延伸阅读
原文未附参考文献列表。延伸阅读可参见文中”相关文章”模块:《Python、LSTM神经网络模型与沪深300、中证500股指预测》。
附录:方法细节补充
- 滑动窗口切样函数
make_samples以时间步长 30 构造监督学习样本,是全部模型的公共组件。 - 早停策略监控验证集损失,LSTM 回归版耐心值为 5,技术指标分类版降为 3。
- 技术指标版本卷积核从 3 加宽到 7 并去掉池化层,以保留更完整的时间结构。
作者声明
作者系深度学习与量化研究领域分析师,拥有多年金融数据挖掘与策略回测经验。本文完整代码、数据与配套AI Agent、skill请阅读原文链接获取。
 2026中国AI Agent企业应用市场预测报告:智能体、AI转型与基础设施|附150报告、数据合集下载
 ChatGPT大模型荐股与夏普比率投资组合优化系统实现|附agent、数据、教程文档
 YOLOv8n-Pose+LSTM边缘智能跌倒检测系统设计与实现
 2026金融AI行业报告:AI投入规模、智能体可信互联成型、监管框架落地|附100+份报告与数据合集下载