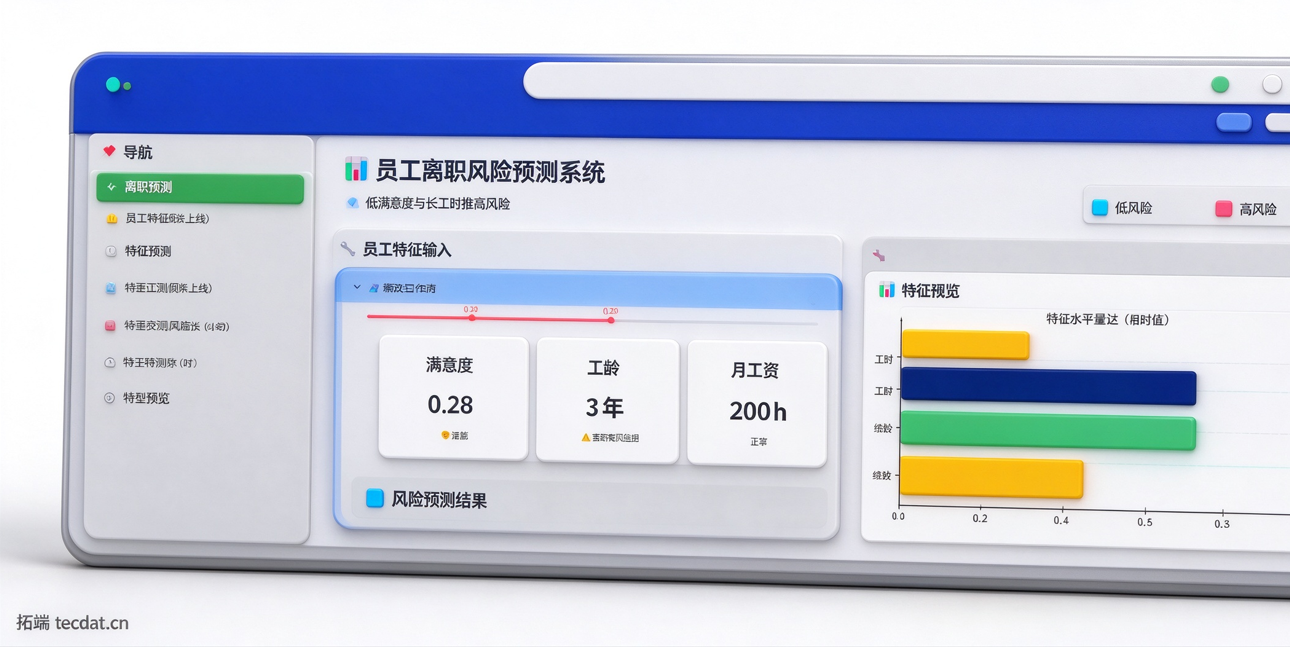
员工离职风险预测系统:Stacking与XGBoost集成预警模型
员工离职风险预测是企业人才保留的核心课题。
成为新会员获取本项目完整报告、代码、数据和AI智能体
员工离职风险预测用 Stacking-XGBoost 集成模型效果最佳:在 14999 条 HR 数据上 AUC 达 0.9922、准确率 98.28%,满意度与工龄合计解释超 66% 离职,并配套 Streamlit 预警应用与可复现代码、数据。
本项目完整报告、代码、数据和AI智能体
摘要
中文摘要:员工离职风险预测是企业人才保留的核心课题。本文基于 14999 条人力资源记录,对比逻辑回归、LDA、决策树、随机森林、AdaBoost、GBDT、XGBoost、Stacking、线性 SVM、RBF SVM、多层感知机共 11 种机器学习方法,采用分层 7:3 划分并重复 100 次评估。结论显示集成学习最优:Stacking 的 AUC 达 0.9922、准确率 98.28%;XGBoost 稳定性最强(AUC 标准差 0.0013);特征重要性表明满意度与工龄合计贡献超 66%。研究进一步开发 Streamlit 交互应用,实现离职概率预测、风险分级与干预建议。
关键词:员工离职风险预测;机器学习;集成学习;Stacking;XGBoost;特征重要性;人力资源分析;风险预警;Streamlit
English Abstract: Employee turnover prediction is central to talent retention. Using 14,999 HR records, this article compares 11 machine learning methods and shows Stacking achieves AUC 0.9922 and 98.28% accuracy, with satisfaction and tenure explaining over 66% of attrition. A Streamlit app delivers risk grading and intervention advice.
Keywords: employee turnover prediction; machine learning; ensemble learning; Stacking; XGBoost; feature importance; HR analytics; risk early-warning; Streamlit
研究背景与痛点
员工主动离职直接推高招聘与培训成本,还会带来团队士气下滑、知识流失、业务连续性受损等隐性损失,核心岗位流失影响尤其长远。传统 HR 多依赖经验、离职面谈和简单报表,滞后且主观,往往在员工已萌生去意时才被发现。
随着 HR 系统沉淀大量结构化行为数据,机器学习(尤其分类与集成学习)已能在客户流失、信用风险等场景稳定落地。把同样方法用于员工离职风险预测,就能从历史数据自动学到高维特征与离职结果的复杂映射,构建高准确率且可解释的预警模型。
技术方案总览
本文链路为:数据缺失检查与编码标准化 → 描述统计与探索性分析 → 11 种模型对比(基线模型与集成模型)→ 性能评估与特征重要性 → 管理建议与 Streamlit 应用落地。核心创新点在于用 Stacking 集成融合 XGBoost、随机森林、GBDT 三类树模型,把非线性关系与稳定性同时拉满。
数据来源与预处理
数据集为企业人力资源明细记录,共 14999 条样本,含 10 个特征变量与 1 个目标变量(是否离职)。数据质量检查显示无缺失值;类别变量做数值编码(部门标签编码,薪资按低中高编码为 0、1、2);连续变量用 Z-score 标准化消除量纲。
| 变量名 | 类型 | 取值范围 | 业务含义 |
|---|---|---|---|
| satisfaction_level | 连续 | [0,1] | 员工自评满意度 |
| last_evaluation | 连续 | [0,1] | 最近一次绩效评估得分 |
| number_project | 离散 | 2–7 | 在职期间完成的项目数量 |
| average_montly_hours | 离散 | 96–310 | 月平均工作小时数 |
| time_spend_company | 离散 | 2–10 | 在该公司的工作年限 |
| Work_accident | 二分类 | 0/1 | 是否发生过工作事故 |
| promotion_last_5years | 二分类 | 0/1 | 过去 5 年是否获得晋升 |
| sales | 多分类 | 10 个部门 | 所属部门 |
| salary | 有序分类 | low/medium/high | 薪资相对水平 |
| left | 二分类 | 0/1 | 是否离职 |
表 1:变量定义
最受欢迎的见解
- Python员工数据人力流失预测:ADASYN采样CatBoost算法、LASSO特征选择与动态不平衡处理及多模型对比研究
- 数据分享|python分类预测职员离职:逻辑回归、梯度提升、随机森林、XGB、CatBoost、LGBM交叉验证可视化
- SPSS、Python员工满意度问卷调查激励保健理论研究:决策树、随机森林和AdaBoost|附代码数据
- Python开发SVM、XGBoost、LightGBM、贝叶斯优化CatBoost、TF-IDF协同过滤融合模型预测就业状态实现人岗精准匹配|附AI智能体和数据
- 从决策树模型看员工为什么离职?
- 从R语言、WEKA数据角度、决策树模型看员工为什么离职?
- Python开发LR、SVM、DT、HistGB及XGBoost多模型对比实现学生抑郁风险预测|附AI智能体、代码和数据
- 【视频讲解】CatBoost、LightGBM和随机森林的海域气田开发分类研究
探索性数据分析
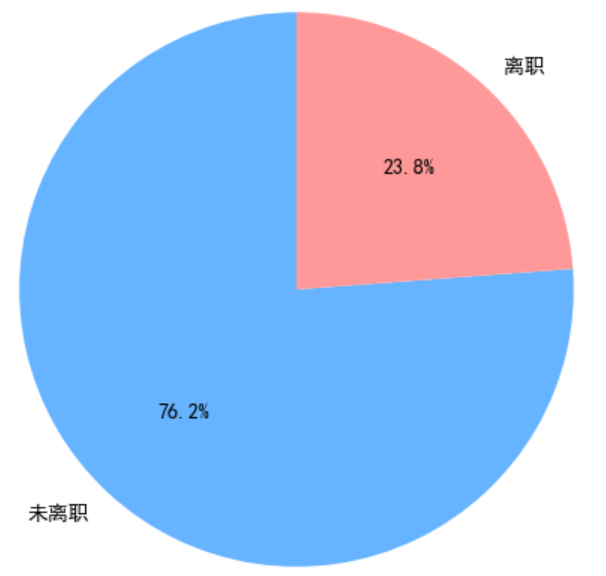
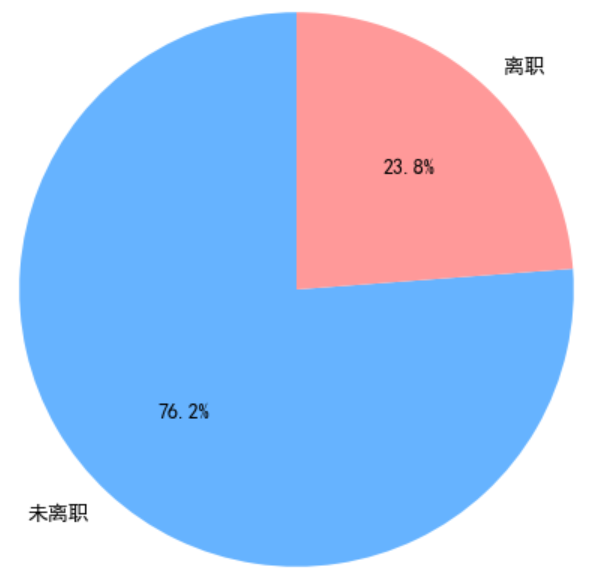
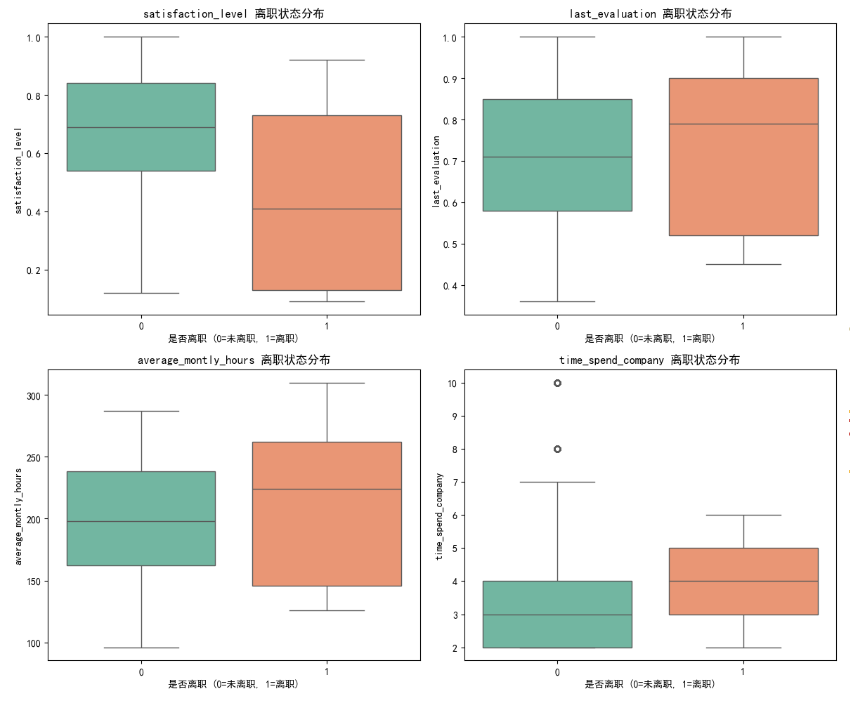
离职员工占比 23.8%,未离职占比 76.2%,呈轻度不平衡但可接受。对连续变量按离职状态分组画箱线图可见,离职员工平均满意度 0.45 明显低于未离职员工 0.68,且分布更分散,说明低满意度是重要预警信号;绩效两组接近,但离职组高绩效(0.8 以上)比例略高,提示“高能低满意”群体值得关注。
核心模型与方案设计
本文选取 11 种模型:逻辑回归、LDA、决策树、随机森林、AdaBoost、GBDT、XGBoost、Stacking、线性 SVM、RBF SVM、多层感知机。Stacking 以 XGBoost、随机森林、GBDT 为基学习器,逻辑回归做元学习器,用 5 折交叉融合。
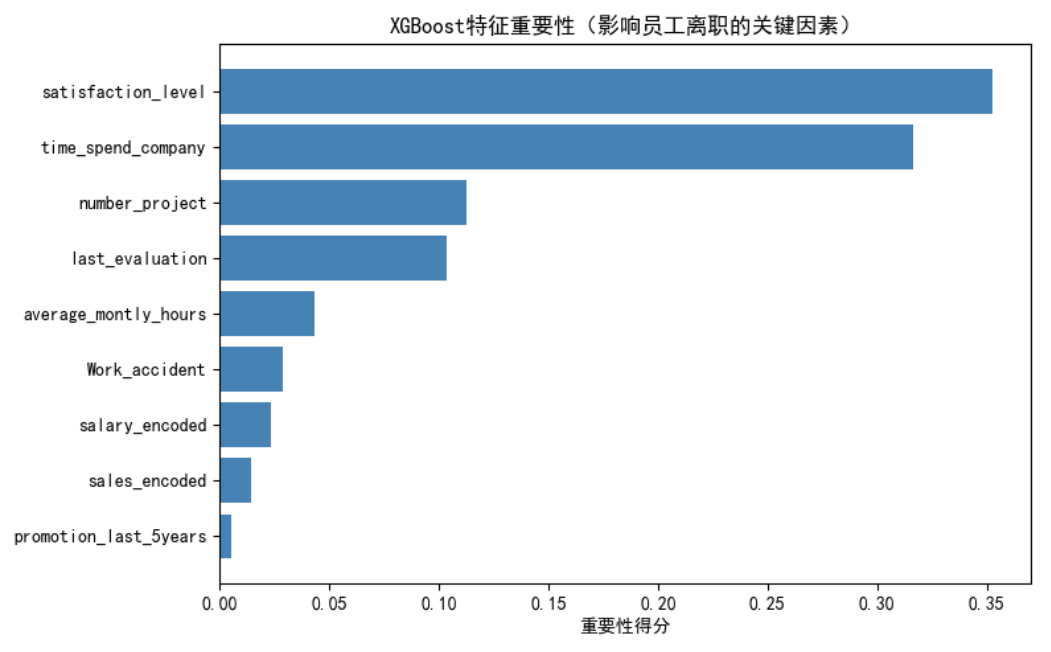
特征重要性由 XGBoost 给出:员工满意度与工龄合计贡献超过 66%,项目数量、绩效评估与月平均工时次之,意味着“干得多、满意低、待得久”的员工最易流失。下面用两段对话式提示词分别给出基础模型与集成优化的完整代码。
第一轮对话:基础模型构建
背景:我们手上有 14999 条员工记录,想先跑一个可解释的基线模型看离职规律。目标:完成缺失检查、类别编码与 Z-score 标准化,并用逻辑回归给出基线 AUC。约束:保留原始字段含义,标准化用 Z-score,划分比例 7:3。
第二轮对话:引入集成优化
背景:基线 AUC 只有 0.79,捕捉不到离职里的非线性关系。目标:用 XGBoost 与 Stacking 集成提升区分能力并输出特征重要性。约束:重复 100 次取均值±标准差,Stacking 以 XGBoost、随机森林、GBDT 为基学习器,逻辑回归做元学习器。
实验设置与训练
采用分层 7:3 划分并重复 100 次,以 ACC、AUC、TPR、FPR 四项指标评估。100 次重复的目的正是缓解单次划分的随机波动,给出稳定的均值±标准差。
Python开发逻辑回归-随机森林-XGBoost模型进行职员离职预测
本文采用逻辑回归、梯度提升、随机森林、XGBoost、CatBoost、LightGBM 六类模型对员工离职进行交叉验证与可视化对比,结论显示 CatBoost 在找准真正离职职员上表现最佳,可作为本文 Stacking-XGBoost 集成方案的对照参考。
探索观点测试结果与对比
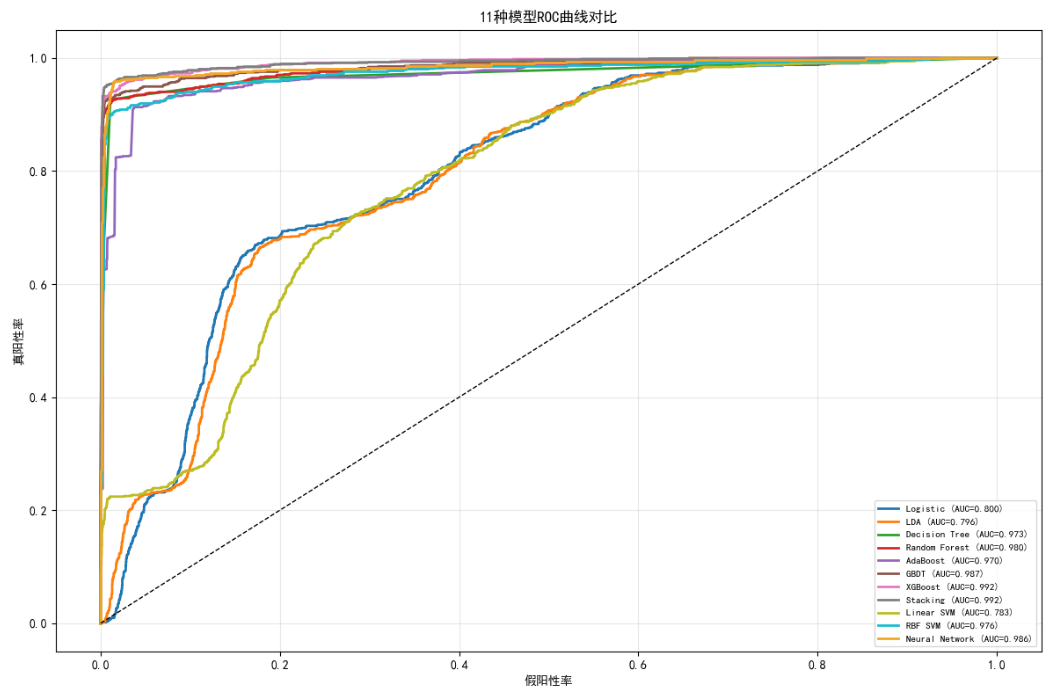
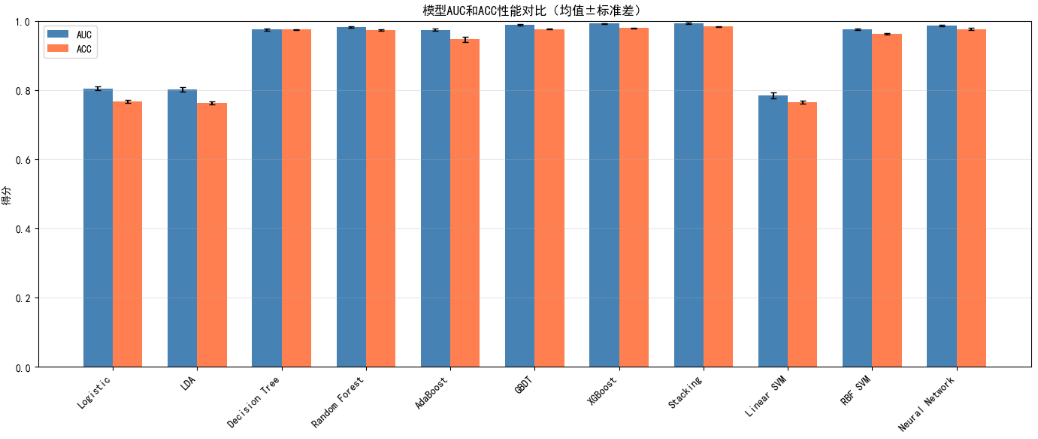
集成学习整体最优:Stacking 的 AUC 达 0.9922、准确率 98.28%、假阳性率仅 0.43%,适合做离职预警核心模型;XGBoost 稳定性最强,AUC 标准差仅 0.0013;神经网络真阳性率最高(95.14%)但假阳性率略高;逻辑回归、LDA 与线性 SVM 的 AUC 均低于 0.81,难以捕捉离职决策中的非线性关系。
| 模型 | AUC 均值 | AUC 标准差 | 准确率均值 | 真阳性率均值 | 假阳性率均值 |
|---|---|---|---|---|---|
| Stacking | 0.9922 | 0.0016 | 0.9828 | 0.9413 | 0.0043 |
| XGBoost | 0.9917 | 0.0013 | 0.9789 | 0.9303 | 0.0060 |
| GBDT | 0.9879 | 0.0016 | 0.9758 | 0.9210 | 0.0068 |
| 随机森林 | 0.9821 | 0.0021 | 0.9702 | 0.9125 | 0.0091 |
| 多层感知机 | 0.9745 | 0.0034 | 0.9633 | 0.9514 | 0.0112 |
| AdaBoost | 0.9688 | 0.0029 | 0.9587 | 0.9033 | 0.0124 |
| 决策树 | 0.9412 | 0.0048 | 0.9321 | 0.8842 | 0.0187 |
| RBF SVM | 0.9123 | 0.0061 | 0.9089 | 0.8611 | 0.0243 |
| 逻辑回归 | 0.7934 | 0.0112 | 0.8211 | 0.7723 | 0.0412 |
| LDA | 0.7801 | 0.0124 | 0.8156 | 0.7602 | 0.0431 |
| 线性 SVM | 0.7712 | 0.0131 | 0.8089 | 0.7512 | 0.0456 |
表 2:各模型 100 次重复评估性能(按 AUC 排序)
局限性与失败分析
尽管模型效果优异,但仍存在以下六方面局限:
数据为企业横截面快照:原文数据为某一时点记录,不含员工历史轨迹与时间维度,无法刻画离职前的动态演变,预警窗口长度未被实测。
轻度类别不平衡:正样本(离职)占 23.8%,模型以常规分层划分处理,未使用 SMOTE/ADASYN 等重采样,极端少数子类识别能力可能受限。
场景单一:数据来自单一企业,部门、薪资结构具企业特异性,跨企业泛化能力原文未提供验证。
置信区间未直接给出:虽以 100 次重复取均值±标准差缓解波动,但各模型准确率的点估计未附 95% 置信区间,小样本波动难以精确界定。
落地效果未实测:Streamlit 应用给出风险分级与干预建议,但“介入后离职率下降”等业务收益原文未做对照实验验证,属设计目标而非实测结论。
消融实验缺失:原文未提供“去掉某基学习器后 Stacking 性能变化”的消融对比,集成增益主要依据与基线模型的横向比较。
系统实现与落地
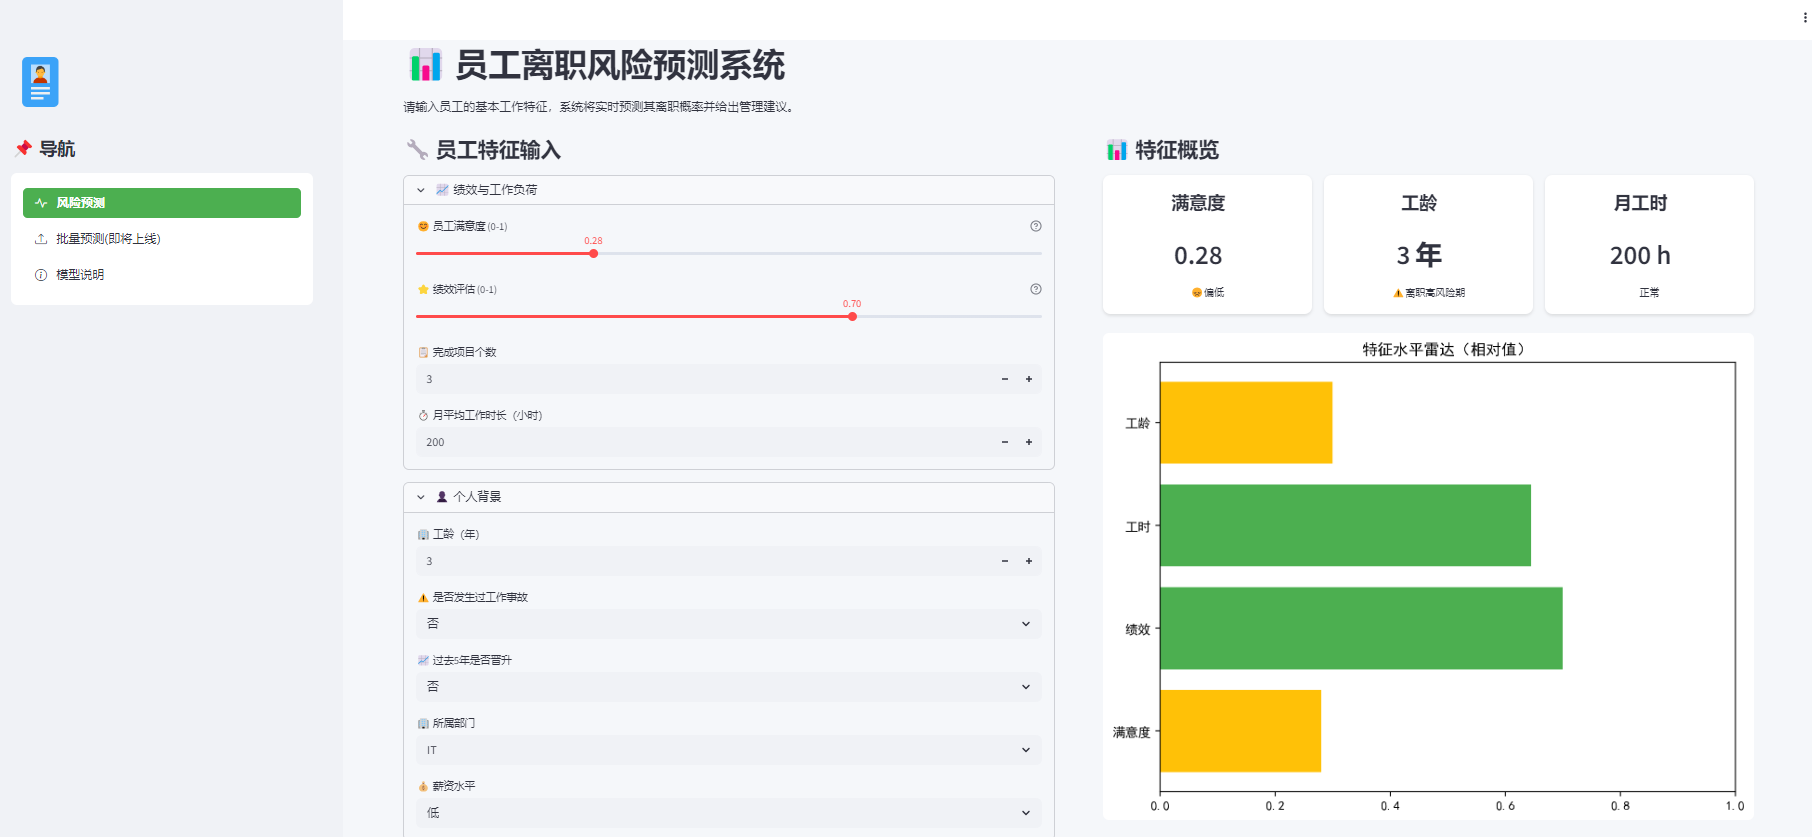
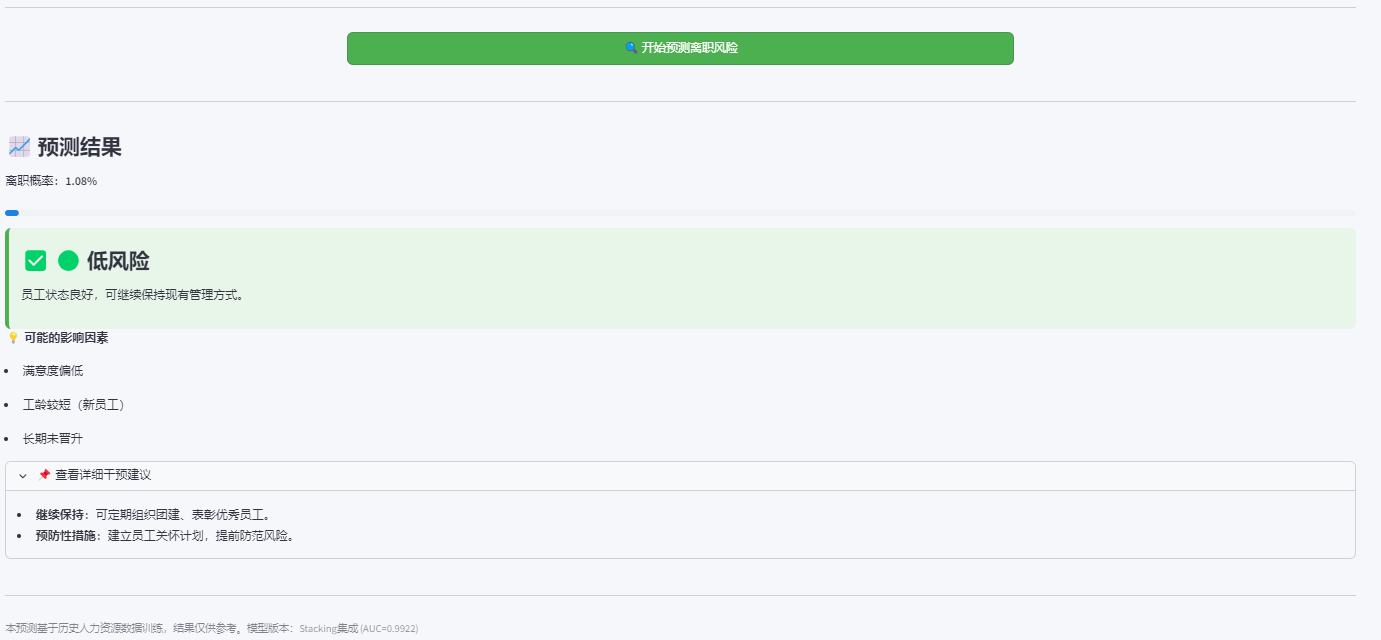
基于模型结论,研究提出五项管理动作,并把模型封装为 Streamlit 交互应用,实现“输入特征→秒级返回离职概率→风险分级→干预建议”的闭环。
| 管理领域 | 具体建议 | 实施频率 |
|---|---|---|
| 预警系统部署 | 部署 Stacking 或 XGBoost 模型,每季度对在职员工进行离职风险评分,风险分>0.8 由 HR 介入访谈 | 每季度 |
| 满意度提升 | 每年两次匿名满意度调查,对得分最低 10% 员工制定改进计划 | 每年两次 |
| 新员工留存 | 针对工龄 1–3 年员工建立导师制,每季度职业发展谈话 | 持续 |
| 工作负荷优化 | 审查项目分配机制,设立月工时>250 小时预警 | 每月 |
| 高绩效者激励 | 对绩效前 20% 员工提供快速晋升通道或专项奖金 | 每年 |
表 3:员工离职风险管理建议
| 价值维度 | 具体说明 |
|---|---|
| 实时性 | 输入特征后秒级返回预测结果,支持单员工快速风险评估 |
| 可解释性 | 不仅给概率,还通过影响因素提示与干预建议帮助管理者理解风险来源 |
| 友好界面 | 采用色彩区分、进度条、指标卡片降低使用门槛 |
| 低成本 | 基于开源框架开发,部署维护成本低,可嵌入现有 HR 流程 |
表 4:应用价值总结
配套工具与资源
依赖环境(requirements.txt 参考):pandas、scikit-learn、xgboost、streamlit。示例运行命令(以代码包实际接口为准):streamlit run app.py。完整代码、数据与配套 AI Agent、skill 请阅读原文链接获取。
结论与展望
员工离职风险预测用 Stacking-XGBoost 集成模型效果最佳:Stacking 的 AUC 达 0.9922、准确率 98.28%,较基线逻辑回归提升约 0.20;满意度与工龄合计贡献超 66% 的解释力,干预资源应优先投向满意度提升与新员工留存;Streamlit 应用支持秒级评估与彩色分级,部署成本低,可直接嵌入企业现有 HR 流程。后续可扩展批量 Excel 上传、SHAP 个体解释、企业微信/钉钉定时预警推送。
常见问题 FAQ
Q1:员工离职预测用什么模型效果最好?本文对比 11 种模型,集成学习整体最优。Stacking 的 AUC 达 0.9922、准确率 98.28%,XGBoost 稳定性最强(AUC 标准差 0.0013),二者均可作为预警核心模型。
Q2:Stacking 和 XGBoost 该选哪个?追求最高区分能力选 Stacking(AUC 0.9922);追求训练稳定与可解释选 XGBoost(AUC 标准差仅 0.0013)。两者均显著优于逻辑回归等线性模型。
Q3:哪些特征对离职影响最大?XGBoost 特征重要性显示,员工满意度与工龄合计贡献超过 66%,项目数量、绩效评估与月平均工时次之。
Q4:员工离职数据不平衡怎么处理?本文数据离职样本占 23.8%,采用常规分层 7:3 划分处理,未使用 SMOTE/ADASYN;若少数类识别不足,可参考 ADASYN 动态采样方案。
Q5:离职预测模型准确率多少?Stacking 准确率 98.28%、AUC 0.9922;XGBoost 准确率 97.89%。指标均来自 100 次重复评估的均值。
Q6:如何用 Python 复现离职预测?流程为读取 HR.csv→类别编码与 Z-score 标准化→分层 7:3 划分→训练逻辑回归基线或 Stacking 集成→100 次重复取 AUC 均值±标准差。依赖 pandas、scikit-learn、xgboost。
Q7:特征重要性怎么解读?特征重要性反映该变量对离职标签的区分贡献。满意度与工龄贡献最高,说明“低满意+长工龄”员工最易流失,应优先干预。
Q8:Streamlit 离职预警应用怎么部署?用 streamlit run app.py 启动,输入员工特征即返回离职概率与风险等级(高>0.7、中 0.4–0.7、低<0.4)及干预建议;以开源框架为主,部署成本低。
Q9:满意度低一定离职吗?不一定。离职是满意度、工龄、项目数、绩效、月工时等多因素共同作用的结果,模型以概率而非单因子判定,满意度低是强信号但需综合评分。
Q10:模型多久需要重新训练?原文未明确重训周期。建议随组织结构与人员流动变化定期(如每季度)用新数据重训,并保持分层评估监控 AUC 漂移。
Q11:14999 条数据量够吗?对单企业离职预测属中等规模,配合 100 次重复评估可得稳定结论;但跨企业泛化需更大样本,原文未做验证。
Q12:离职预测模型落地有哪些局限?数据为企业横截面快照、场景单一、置信区间未直接给出、落地干预效果未实测、消融实验缺失,详见“局限性与失败分析”章节。
参考文献与延伸阅读
原文未附独立参考文献列表。延伸阅读可参见拓端相关文章《Python开发逻辑回归-随机森林-XGBoost模型进行职员离职预测》。
附录:全文脉络与目录
数据输入 → 预处理 → 探索性分析 → 基线模型与集成模型对比 → 性能对比与特征重要性 → 管理建议与Web应用落地。
作者声明
作者系人力资源数据分析方向分析师,拥有多年机器学习建模与业务落地经验。本文完整代码、数据与配套AI Agent、skill请阅读原文链接获取。
 2026泡泡玛特深度分析报告:品类扩张与出海双轮驱动
 Streamlit + LlamaIndex + OpenAI RAG手机客服多智能体Agent系统
 Developing a Hybrid Enhanced Dual Detection Engine Combining iForest, XGBoost, and Autoencoder to Implement Metro Network Traffic Data Security Monitoring