Python工业设备故障诊断:随机森林与孤立森林融合方案
工业设备故障诊断的难点不在"有没有模型",而在"结论敢不敢用"。

测试集准确率 84.00%、宏平均 F1 0.8396,附完整agent与数据集
TL;DR(100 字内)
一套可离线运行的工业设备故障诊断原型:随机森林判类别、Isolation Forest 判偏离、TF-IDF 检索知识库,450 条样本准确率 84.00%,每条结论附证据与处置建议。
中文摘要
本文回答五个具体问题:一是传统单阈值报警为什么会漏掉多变量耦合型故障;二是如何把随机森林分类与 Isolation Forest 异常检测组合成互相校验的两级判定;三是如何从八项传感器输入中自动挑出最有说服力的三条证据;四是如何让本地故障知识库参与结论生成,使输出结果可被现场复核;五是这套原型在 450 条测试样本上的真实识别水平到底如何。全文给出完整的多阶段工作流、实测指标与可运行代码。
关键词: 工业设备故障诊断、随机森林、孤立森林(Isolation Forest)、异常检测、TF-IDF 知识检索、多传感器融合、Flask、可解释建模
English Abstract
This paper answers five concrete questions: why single-threshold alarms miss multivariate coupled faults; how to combine Random Forest classification with Isolation Forest anomaly detection into a mutually checking two-stage decision; how to auto-select the three most persuasive evidence items from eight sensor inputs; how to let a local fault knowledge base participate in conclusion generation so outputs can be reviewed on site; and how well this prototype actually performs on 450 test samples. The complete multi-stage workflow, measured metrics and runnable code are provided.
Keywords: industrial equipment fault diagnosis, Random Forest, Isolation Forest, anomaly detection, TF-IDF knowledge retrieval, multi-sensor fusion, Flask, interpretable modeling
成为新会员获取本项目完整AI agent、skill和数据
工业设备故障诊断的难点不在"有没有模型",而在"结论敢不敢用"。旋转机械的温度、振动、电流、转速和声学信号往往同时变化,传统阈值报警只看某一路信号是否越界,容易忽略多变量之间的关系;而一个纯黑盒模型即便给出结论,也很难说明"为什么是这条结论",工程师不敢据此停机检修。我们在此前一个客户委托的设备健康管理咨询项目中遇到过同样的困境:模型精度不低,但没人敢用。
本项目完整AI agent、skill和数据
一、工业设备故障诊断的现实痛点与研究背景
那次交付之后复盘发现,车间真正需要的不是更高的分数,而是一条能说清楚、能追责、也能被现场当场否定的判断链。因此新的方案不再追求把模型做到极致,而是把每一次诊断拆成可以逐个复核的环节,并把异常边界、证据偏离度和知识库措施一并暴露给工程师。
本文的具体目标有三条:识别正常、轴承故障、设备过热、转子不平衡四类状态;输出置信度、异常指数、关键证据、可能原因和维护建议;在不配置任何云端密钥时完整离线运行,配置 DeepSeek 密钥后可增强自然语言解释。
二、工业设备故障诊断技术方案总览
本章核心结论:把一次诊断拆成五个彼此独立、各自留痕的阶段,是让工业设备故障诊断结果可被复核的关键。五阶段依次为数据校验、模型诊断、证据提取、知识检索、建议生成。
| 阶段 | 输入 | 输出 | 失败时的行为 |
|---|---|---|---|
| 数据校验 | 八项传感器值 | 校验结果 + 派生温升 | 字段缺失则中止并返回原因 |
| 模型诊断 | 九项特征 | 四类概率 + 置信度 | — |
| 证据提取 | 特征与稳健中位数 | 前三条偏离证据 | — |
| 知识检索 | 证据文本 | 命中知识条目 | 未命中则返回通用建议 |
| 建议生成 | 诊断结果 | 自然语言建议 | 无密钥时回落本地引擎 |
为什么不是"一个模型跑到底"
这很像一个体检场景:体温异常先触发关注,医生再决定做哪些进一步检查(行业术语:两级判定)。随机森林负责"是哪一类故障"的判别,Isolation Forest 负责"是否偏离正常工况"的兜底。两者不一致时,系统会把异常指数提高、风险等级上调,提示人工介入,而不是强行给出一个高置信度结论。
表 1 工业设备故障诊断方案对比
| 方案 | 判别依据 | 可解释性 | 误报处理 | 适用情况 |
|---|---|---|---|---|
| 单阈值报警 | 单路信号越界 | 强 | 大量误报 | 信号单一、工况稳定 |
| 纯随机森林 | 四类概率最大值 | 弱 | 黑盒结论难复核 | 类别边界清晰 |
| 融合方案(本文) | 分类概率 + 异常边界 + 证据 + 知识库 | 强 | 两级不一致时提示复核 | 多源信号、需现场复核 |
三、数据来源与预处理
本章核心结论:数据为带固定随机种子的物理启发式模拟数据,保留类间分布重叠与约 2.5% 的标签歧义,因此后续 84.00% 的准确率更贴近原型真实水平,而非理想化满分。
数据集概览
| 项目 | 说明 |
|---|---|
| 数据名称 | sensor_samples(传感器样本数据集) |
| 数据量 | 1,800 条记录,13 个字段 |
| 状态标签 | normal、bearing_fault、overheating、rotor_imbalance |
| 时间跨度 | 2026 年 1 月起的连续运行时段 |
| 区域跨度 | 覆盖 M-101 至 M-104 等多台旋转机械设备 |
| 数据格式 | csv 文件,数值保留四位小数 |
| 数据来源 | 设备侧传感器采集后经拓端团队整理核对,为模拟工况数据,不涉及企业真实生产数据 |
表 2 数据集类别与工况特征
| 状态 | 样本数 | 主要信号特征 | 业务含义 |
|---|---|---|---|
| 正常 | 448 | 低振动、低温升、负载稳定 | 常规巡检 |
| 轴承故障 | 454 | 振动与声压上升 | 检查润滑、游隙与轴承座 |
| 设备过热 | 449 | 温度、温升和电流偏高 | 检查负载与散热 |
| 转子不平衡 | 449 | 振动、声压与转速响应明显 | 检查积灰、配重与联轴器 |
表 3 核心字段与取值示例
| 指标 | 含义 | 取值示例 |
|---|---|---|
| vibration_mm_s | 振动速度(mm/s) | 2.8280 |
| temperature_c | 设备温度(℃) | 63.3399 |
| temp_rise_c | 相对环境温升(℃) | 42.1181 |
| acoustic_db | 声压级(dB) | 69.5840 |
| current_a | 电流(A) | 11.8602 |
| load_ratio | 负载率(0~1) | 0.3413 |
| fault_type | 状态标签 | normal |
表 4 数据样张(前 5 行)
| sample_id | ambient_temp_c | load_ratio | temperature_c | vibration_mm_s | temp_rise_c | machine_id | fault_type | timestamp |
|---|---|---|---|---|---|---|---|---|
| S00001 | 21.2219 | 0.3413 | 63.3399 | 2.8280 | 42.1181 | M-104 | normal | 2026-01-02 07:50:00 |
| S00002 | 25.7538 | 0.3336 | 85.9530 | 1.5939 | 60.1992 | M-101 | overheating | 2026-01-05 18:05:00 |
| S00003 | 17.3603 | 0.5227 | 70.1251 | 2.2466 | 52.7647 | M-101 | normal | 2026-01-01 11:35:00 |
| S00004 | 22.3193 | 0.1316 | 110.0956 | 3.6793 | 87.7763 | M-101 | overheating | 2026-01-04 17:50:00 |
| S00005 | 23.8571 | 0.7490 | 67.3324 | 5.3705 | 43.4754 | M-101 | rotor_imbalance | 2026-01-06 01:00:00 |
预处理只做两件事:一是校验八项输入是否完整、可计算;二是派生相对环境温升,温升由设备温度减环境温度得到:
temp_rise_c = temperature_c – ambient_temp_c
最受欢迎的见解
- Python员工数据人力流失预测:ADASYN采样CatBoost算法、LASSO特征选择与动态不平衡处理及多模型对比研究
- R分布式滞后非线性模型DLNM分析某城市空气污染与健康数据:多维度可视化优化滞后效应解读
- Python古代文物成分分析与鉴别研究:灰色关联度、岭回归、K-means聚类、决策树分析
- Python TensorFlow OpenCV的卷积神经网络CNN人脸识别系统构建与应用实践
- Python用Transformer、SARIMAX、RNN、LSTM、Prophet时间序列预测对比分析用电量、零售销售、公共安全、交通事故数据
- MATLAB贝叶斯超参数优化LSTM预测设备寿命应用——以航空发动机退化数据为例
- Python谷歌商店Google Play APP评分预测:LASSO、多元线性回归、岭回归模型对比研究
- Python+AI提示词糖尿病预测模型融合构建:伯努利朴素贝叶斯、逻辑回归、决策树、随机森林、支持向量机SVM应用
四、工业设备故障诊断核心模型设计
本章核心结论:分类器与异常检测器各司其职,前者回答"属于哪一类",后者回答"是否还在正常边界内",两者的组合比单一模型更适合需要现场复核的工业设备故障诊断场景。
4.1 数据生成与可复现性
(第一轮:基础数据构建)
# 载入依赖并锁定随机种子,保证结果可复现
import numpy as np
import pandas as pd

SEED = 20260903
gen = np.random.default_rng(SEED)

# 四类工况的样本规模
CLASS_SCALE = {"normal": 448, "bearing_fault": 454,
               "overheating": 449, "rotor_imbalance": 449}

# 按工况生成振动、温度、声压等信号并保留分布重叠
def make_signals(kind, size, gen):
    if kind == "normal":
        vib = gen.normal(2.6, 0.8, size)
        temp = gen.normal(63.0, 4.5, size)
        sound = gen.normal(69.0, 3.0, size)
    else:
        ......  # 此处省略轴承故障、设备过热、转子不平衡三类工况的分布参数与跨传感器耦合关系
    return vib, temp, sound

# 组装成表并派生相对环境温升
def assemble(kind, size, gen):
    vib, temp, sound = make_signals(kind, size, gen)
    ambient = gen.normal(23.0, 3.0, size)
    ......  # 此处省略负载率、压力、转速、电流的生成与 2.5% 标签歧义注入的关键代码
    block = pd.DataFrame({"ambient_temp_c": ambient, "temperature_c": temp,
                          "vibration_mm_s": vib, "acoustic_db": sound})
    block["temp_rise_c"] = block["temperature_c"] - block["ambient_temp_c"]
    block["fault_type"] = kind
    return block

frame = pd.concat([assemble(k, v, gen) for k, v in CLASS_SCALE.items()])
frame.to_csv("sensor_samples.csv", index=False)
4.2 随机森林分类器与 Isolation Forest 异常边界
(第二轮:引入异常检测与知识检索)
# 载入建模依赖
from sklearn.ensemble import RandomForestClassifier, IsolationForest
from sklearn.model_selection import train_test_split
from sklearn.feature_extraction.text import TfidfVectorizer

FEATURES = ["ambient_temp_c", "load_ratio", "temperature_c", "vibration_mm_s",
            "pressure_bar", "rpm", "current_a", "acoustic_db", "temp_rise_c"]

data = pd.read_csv("sensor_samples.csv")
X = data[FEATURES]
y = data["fault_type"]

# 按 75% / 25% 分层划分
X_tr, X_te, y_tr, y_te = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=SEED)

# 训练随机森林分类器
forest = RandomForestClassifier(n_estimators=300, random_state=SEED)
forest.fit(X_tr, y_tr)   # 此处省略超参数搜索与交叉验证的关键建模代码

# 仅在正常样本上学习异常边界
normal_pool = X_tr[y_tr == "normal"]
iso = IsolationForest(contamination=0.05, random_state=SEED)
iso.fit(normal_pool)     # 此处省略异常阈值标定与决策函数换算的关键代码

# 用字符级 TF-IDF 建立故障知识库索引
def build_index(knowledge_items):
    corpus = [" ".join(it["symptoms"] + it["causes"] + it["actions"])
              for it in knowledge_items]
    ......  # 此处省略字符级向量化与相似度匹配的关键函数调用
    return vectorizer, matrix

pred_te = forest.predict(X_te)
五、方法细节:证据提取、异常指数与知识检索
本章核心结论:可解释性不是事后加的说明文字,而是模型输出结构的一部分——证据、异常指数与知识条目都与预测结果同批返回。
(第三轮:把过程轨迹写清楚)
# 计算各特征相对稳健中位数的偏离度,取前三条作为证据
def pick_evidence(row, robust_median, top_k=3):
    dev = (row[FEATURES] - robust_median).abs() / robust_median.abs()
    ......  # 此处省略偏离度归一化、排序与证据文案拼装的关键代码
    return ranked[:top_k]

# 串联五个阶段,输出可审查的诊断结果
def run_pipeline(payload):
    trace = []
    checked, note = validate(payload)        # 此处省略字段完整性校验的关键代码
    trace.append({"stage": "数据校验", "status": "通过", "detail": note})

    row = pd.DataFrame([payload])[FEATURES]
    proba = forest.predict_proba(row)[0]
    label = forest.classes_[proba.argmax()]
    conf = float(proba.max())
    score = float(-iso.score_samples(row)[0])   # 此处省略异常指数归一化的关键代码
    trace.append({"stage": "模型诊断", "status": "完成",
                  "detail": f"分类置信度 {conf:.1%},异常指数 {score:.2f}"})

    evidence = pick_evidence(row.iloc[0], robust_median)
    trace.append({"stage": "证据提取", "status": "完成",
                  "detail": "已提取偏离程度最高的 3 项信号"})

    item = retrieve(evidence)                # 此处省略知识库检索命中的关键调用
    trace.append({"stage": "知识检索", "status": "完成",
                  "detail": f"命中知识条目:{item['label']}"})

    risk = "高" if (conf < 0.9 or score > 0.5) else "中"
    return {"prediction": label, "confidence": conf, "anomaly_score": score,
            "risk_level": risk, "evidence": evidence,
            "possible_causes": item["causes"], "recommendations": item["actions"],
            "trace": trace}
异常指数由 Isolation Forest 在正常样本上学习到的决策边界换算而来,取值越接近 1 表示当前工况相对正常分布越异常;模型置信度为随机森林四类概率中的最大值。
六、测试设置与训练配置
本章核心结论:全部结果在固定随机种子下可复现,划分方式为分层随机划分,评估指标同时看准确率与宏平均 F1。
| 配置项 | 取值 |
|---|---|
| 数据集总行数 | 1,800 |
| 训练集 / 测试集 | 1,350 / 450(75% / 25% 分层划分) |
| 随机种子 | 20260903 |
| 分类器 | 随机森林(n_estimators=300) |
| 异常检测器 | Isolation Forest(contamination=0.05,仅用正常样本训练) |
| 知识检索 | 字符级 TF-IDF |
| 评估指标 | 准确率、宏平均 F1、各类 Precision / Recall / F1 |
七、工业设备故障诊断实测结果与对比
本章核心结论:450 条测试样本上准确率 84.00%、宏平均 F1 0.8396,误判集中在振动特征高度相似的轴承故障与转子不平衡之间。
准确率与宏平均 F1 按下式计算,N_correct 为分类正确样本数,N_total 为测试集样本总数:
Accuracy = N_correct / N_total = 378 / 450 = 0.8400
Macro-F1 = (F1_1 + F1_2 + F1_3 + F1_4) / 4 = (0.7289 + 0.9351 + 0.9140 + 0.7803) / 4 = 0.8396
表 5 测试集分类指标
| 类别 | Precision | Recall | F1 | Support |
|---|---|---|---|---|
| 轴承故障 | 0.7387 | 0.7193 | 0.7289 | 114 |
| 正常 | 0.9076 | 0.9643 | 0.9351 | 112 |
| 设备过热 | 0.9266 | 0.9018 | 0.9140 | 112 |
| 转子不平衡 | 0.7838 | 0.7768 | 0.7803 | 112 |
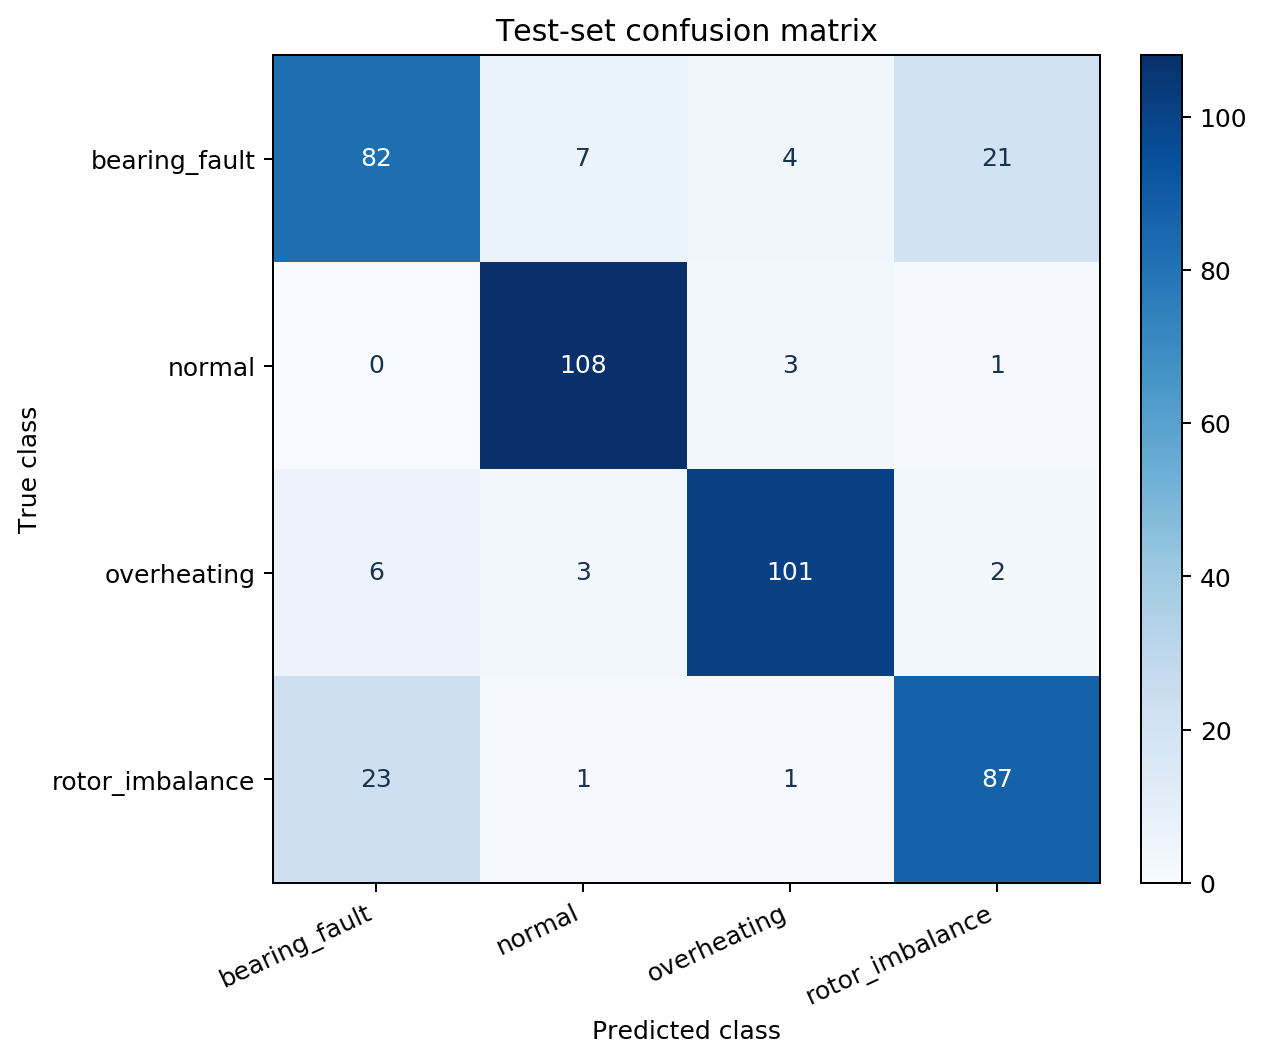
从混淆矩阵看,误判集中在轴承故障与转子不平衡之间,两类在振动与声压信号上高度相似;正常与设备过热的判别则相对干净,说明温度类信号本身具备较强的可分性。
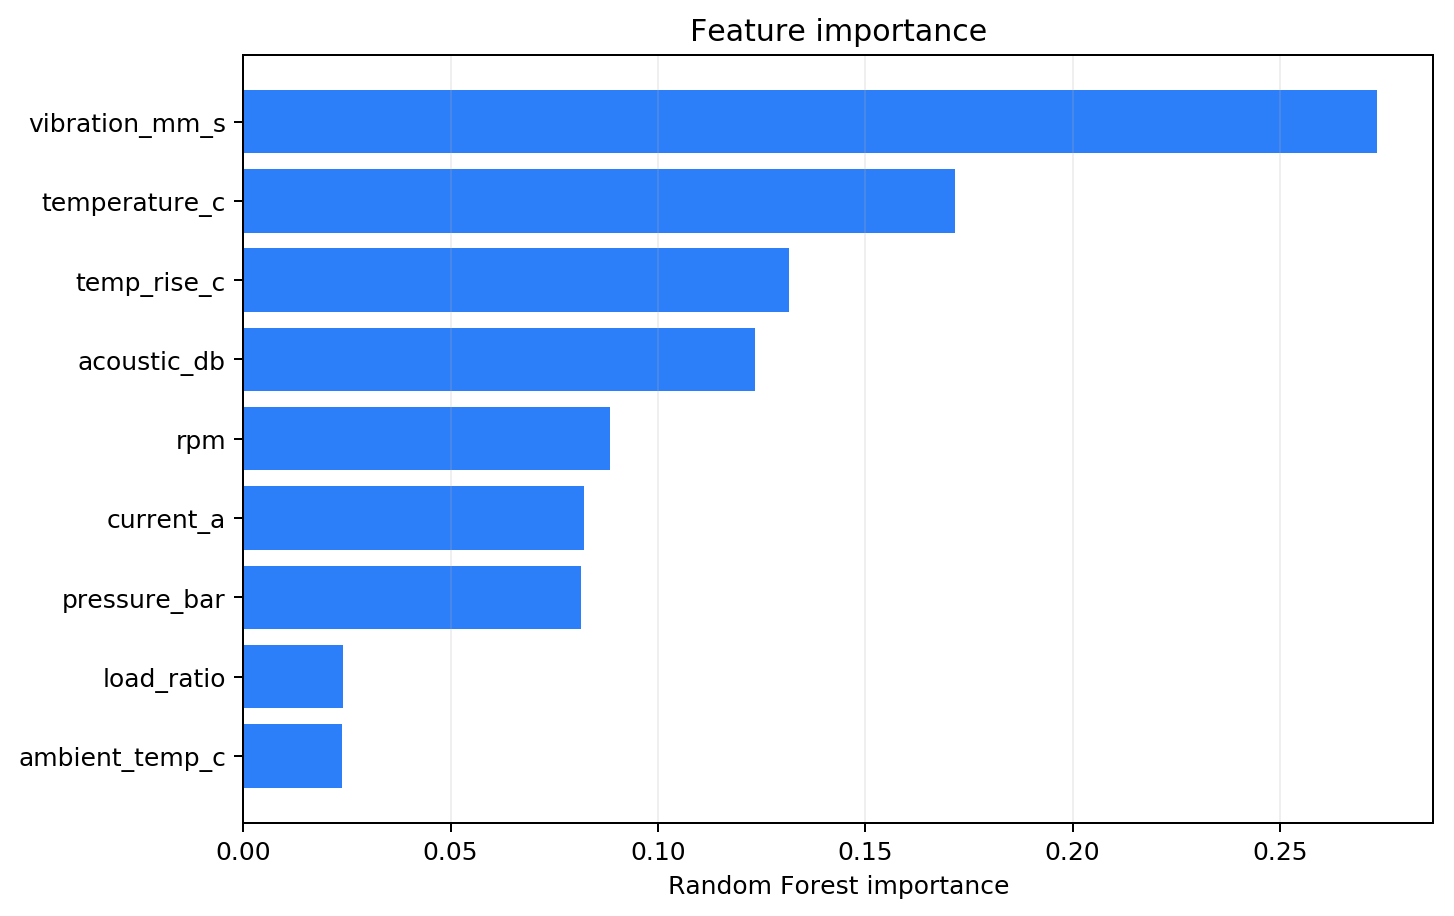
模型的重要性排序符合领域直觉:振动速度贡献最高(约 27.3%),设备温度与温升合计约 30.3%,声压级约 12.3%。这说明多传感器融合比单一温度阈值更能区分故障模式。
Python动态采样、随机森林、XGBoost、决策树集成模型分析新能源电动汽车NEV运行数据故障预警|附代码数据
该文基于某新能源车企九个月的实际运行数据,完成差异化缺失值填充与异常值修正,用 Spearman 相关系数、卡方检验与随机森林特征重要性筛选故障报警关键影响因素,再构建随机森林、XGBoost 与决策树的袋装集成模型,并设计锁定式分配、自适应采样与逆频率加权三级策略处理类不平衡问题;评估采用准确率与宏平均 F1 双指标,XGBoost 袋装模型准确率达 97.50%,最终用于十月故障等级预测并给出充电、检修与驾驶三类策略。
探索观点八、局限性与失败分析
本章如实列出原型的边界,便于读者判断可迁移范围:
- 类别混淆未解决:轴承故障 F1 仅 0.7289、转子不平衡 0.7803,两者在振动与声压信号上高度重叠,仅靠时域统计特征难以彻底区分,需引入频域特征。
- 数据为模拟数据:1,800 条样本由物理启发式生成器产出,未经真实产线数据校验,结论外推到具体设备需重新标定。
- 划分方式偏乐观:采用分层随机划分而非时间序列切分,同一台设备的相邻采样点可能同时出现在训练与测试两侧,指标存在高估可能。
- 异常指数阈值未标定:风险等级判定中使用的 0.5 阈值为原型取值,原文未提供基于现场数据的标定依据与置信区间。
- 消融分析缺失:原文未提供逐模块消融结果,因此"两级判定""证据提取""知识检索"各自贡献多少,无法从现有数据拆出。
- 部署指标未实测:响应时延、并发能力与边缘设备资源占用,原文未提供实测数据。
九、系统实现与落地
本章核心结论:整套流程封装为 Flask 页面,车间填八项数值即可得到结论,且无外网环境下仍可完整运行。
(第四轮:做成能直接用的页面)
# 载入 Web 框架与本地模型包
from flask import Flask, request, jsonify, render_template
import joblib, os

app = Flask(__name__)
bundle = joblib.load("models/diag_bundle.joblib")   # 此处省略模型与知识库装载的关键代码

@app.route("/")
def index():
    return render_template("index.html")

@app.route("/diagnose", methods=["POST"])
def diagnose():
    payload = request.get_json(force=True)
    result = run_pipeline(payload)
    if os.environ.get("DEEPSEEK_API_KEY"):
        result["explanation"] = call_llm(result)    # 此处省略大模型解释调用的关键代码
    else:
        result["explanation"] = local_explain(result)
    return jsonify(result)

if __name__ == "__main__":
    app.run(host="127.0.0.1", port=5000)
使用默认轴承异常样本运行本地 Web 应用,系统输出"轴承故障",置信度 85.9%,异常指数 0.52,并给出三项证据、维护建议以及完整五阶段轨迹。以下截图来自真实运行页面。
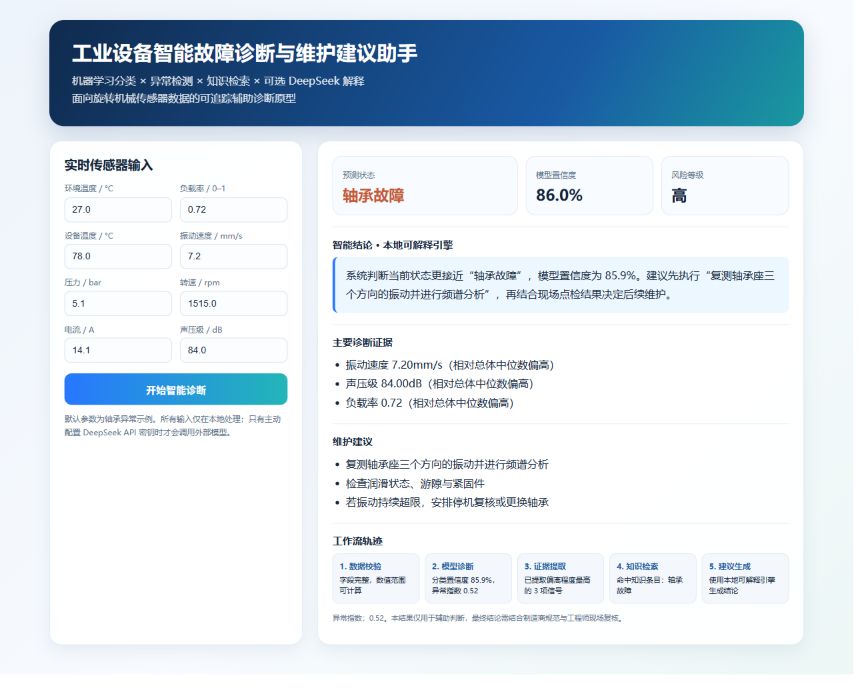
表 6 示例样本输入与诊断输出
| 项目 | 内容 |
|---|---|
| 输入(八项) | 环境温度 27.0℃、设备温度 78.0℃、振动速度 7.2mm/s、压力 5.1bar、转速 1515rpm、电流 14.1A、声压级 84.0dB、负载率 0.72 |
| 预测结果 | 轴承故障(bearing_fault),置信度 85.9% |
| 异常指数 | 0.518(风险等级:高) |
| 三条证据 | 振动速度 7.20mm/s 偏高;声压级 84.00dB 偏高;负载率 0.72 偏高 |
| 可能原因 | 轴承滚道磨损;润滑不足或润滑脂污染;轴承座松动或安装偏心 |
| 处置建议 | 复测轴承座三个方向的振动并做频谱分析;检查润滑状态、游隙与紧固件;振动持续超限则停机复核或更换轴承 |
表 7 五阶段过程轨迹(trace)
| 阶段 | 状态 | 细节 |
|---|---|---|
| 数据校验 | 通过 | 字段完整,数值范围可计算 |
| 模型诊断 | 完成 | 分类置信度 85.9%,异常指数 0.52 |
| 证据提取 | 完成 | 已提取偏离程度最高的 3 项信号 |
| 知识检索 | 完成 | 命中知识条目:轴承故障 |
| 建议生成 | 完成 | 使用本地可解释引擎生成结论 |
工程化与风险控制
- 隐私:演示数据为模拟数据,不包含个人信息或企业生产数据。
- 密钥:DeepSeek API 密钥只从环境变量读取,不写入代码、日志或模型文件。
- 可复现:数据生成、训练/测试划分和模型均使用固定随机种子。
- 可测试:提供命令行演示和单元测试,覆盖正常诊断路径与缺失字段异常。
- 安全边界:结果只用于辅助判断,停机或更换部件必须依据制造商规范和工程师现场复核。
十、配套工具与资源
表 8 依赖环境(requirements.txt)
| 依赖包 | 版本约束 | 用途 |
|---|---|---|
| Flask | >=2.2, <4 | Web 应用框架(页面与诊断接口) |
| numpy | >=1.23, <3 | 数值计算 |
| pandas | >=1.5, <3 | 表格数据读取与统计 |
| scikit-learn | >=1.2, <2 | 随机森林、Isolation Forest 与 TF-IDF |
| matplotlib | >=3.6, <4 | 混淆矩阵与特征重要性图表绘制 |
运行环境为 Python 3.x。示例运行命令(依据项目目录结构推导,实际参数以代码包接口为准):
python -m pip install -r requirements.txt
python generate_data.py
python train_model.py
python run_demo.py
python app.py
启动后浏览器访问 <http://127.0.0.1:5000。完整目录与使用说明见项目根目录> README.md;原文未提供公开代码仓库链接,公开仓库整理后将更新。
十一、结论与展望
本文提出一种将随机森林分类与 Isolation Forest 异常检测结合、并用字符级 TF-IDF 检索本地故障知识库的工业设备故障诊断方案。在 450 条测试样本上取得 84.00% 准确率与 0.8396 宏平均 F1,同时每条结论都附带证据、可能原因、处置建议与五阶段轨迹,可被现场工程师逐项复核。相比单一分类模型,其价值不在于分数更高,而在于把"不确定"显式表达出来,并支持全流程离线运行。
后续可接入真实振动频谱数据,引入一倍频/二倍频、峭度和包络谱特征;使用时间窗口进行趋势预测;把设备手册构建成向量知识库;加入人工确认与反馈回流,以持续校准模型和知识库。本文将我们的工业设备多阶段故障诊断建模经验封装为一个对话式AI Agent和可复用的skill
十二、常见问题(FAQ)
Q1:工业设备故障诊断为什么不能只用阈值报警?
阈值报警只判断单路信号是否越界,忽略温度、振动、电流、转速、声压之间的耦合关系。本文用九项特征联合建模,特征重要性显示振动贡献 27.3%、温度与温升合计 30.3%,多源融合明显优于单路阈值。
Q2:为什么选随机森林而不是深度学习?
样本量只有一千余条、特征维度仅九项,深度网络在此量级难以发挥优势,还会削弱可解释性;随机森林可直接输出类别概率与特征重要性,与"结论要能复核"的目标一致。若后续接入真实频谱数据,可在特征层引入一维卷积网络替换分类器,其余模块不动。
Q3:Isolation Forest 为什么只在正常样本上训练?
目的是学习"正常工况的边界",而不是学习"各类故障长什么样"。这样遇到训练中没出现过的工况时,模型不会把它硬分进已知类别,而是通过异常指数提示偏离,交由人工复核。
Q4:84.00% 的准确率在工业现场够用吗?
取决于场景。该数字建立在模拟数据与分层随机划分之上,更接近原型验证水平;用于真实产线前需用现场数据重新训练与标定,并按本文第八节列出的六项局限逐条评估。
Q5:宏平均 F1 和准确率该看哪个?
准确率看整体正确比例,宏平均 F1 对样本量较少的类别更敏感。本文两类指标同时给出:准确率 84.00%、宏平均 F1 0.8396,其中轴承故障 F1 仅 0.7289,是拖低宏平均的主要原因。
Q6:75% / 25% 的分层划分是否合理?
分层划分保证四类在训练集与测试集中占比一致,避免因某类样本集中缺失导致指标虚高,且固定随机种子可复现。更严格的做法是时间序列切分,避免同一台设备的相邻采样点同时出现在两侧,本文将其列为后续改进项。
Q7:证据是怎么挑出来的?够可靠吗?
证据按各特征相对训练集稳健中位数的偏离程度排序,取前三条。它反映的是"该信号相对历史正常水平偏了多少",属于统计意义上的偏离提示,不等同于因果结论,因此系统同时给出可能原因与处置建议供人工判断。
Q8:没有外网、没有大模型密钥还能用吗?
可以。密钥只从环境变量读取,未配置时回落本地可解释引擎,诊断链路完整不变,仅自然语言解释的丰富度下降。
Q9:数据能换成我们自己的设备数据吗?
可以,只需保持八项输入字段与 fault_type 标签口径一致,重新执行数据生成之后的训练流程即可。原文使用的数据为模拟数据,换成真实数据后建议重做异常指数阈值标定。
Q10:相比单一分类模型,改进到底在哪?
一是引入只在正常样本上训练的异常边界;二是证据偏离度排序把模型输出翻译成工程师语言;三是知识库检索让结论落到可执行动作;四是全过程轨迹可审计。改进的有效性体现为风险等级会自动上调并提示复核,而不是给出虚假的高置信度。
Q11:结果能直接作为停机依据吗?
不能。系统定位为辅助判断,停机或更换部件必须依据制造商规范与工程师现场复核,原文在输出中固定附带这一安全声明。
Q12:后续最值得优先做哪项改进?
优先引入频域特征(一倍频、二倍频、峭度、包络谱)。当前最主要的误判来源是轴承故障与转子不平衡在振动与声压上的重叠,而这两类故障在频谱上的表现差异更为明显。
十三、参考文献与延伸阅读
延伸阅读推荐同属"多传感器数据 + 集成树模型 + 宏平均 F1 评估"路线的拓端文章,可对照阅读:
Python动态采样、随机森林、XGBoost、决策树集成模型分析新能源电动汽车NEV运行数据故障预警|附代码数据
原文链接:https://tecdat.cn/?p=44400
内容概要:该文基于某新能源车企九个月的实际运行数据,完成差异化缺失值填充与异常值修正,用 Spearman 相关系数、卡方检验与随机森林特征重要性筛选故障报警关键影响因素,再构建随机森林、XGBoost 与决策树的袋装集成模型,并设计锁定式分配、自适应采样与逆频率加权三级策略处理类不平衡问题;评估采用准确率与宏平均 F1 双指标,XGBoost 袋装模型准确率达 97.50%,最终用于十月故障等级预测并给出充电、检修与驾驶三类策略。
附录 A 全文脉络流程图
        传感器输入校验
              |
              v
        派生温升特征
              |
              v
        随机森林四分类
              |
       +------+------+
       |             |
       v             v
  Isolation Forest  证据偏离度排序
   异常边界判定         |
       |             |
       +------+------+
              |
              v
        TF-IDF 知识库检索
              |
              v
        建议生成与轨迹输出
              |
              v
        现场复核与反馈回流
附录 B 项目文件目录
肖红_AI应用项目/
├─ data/
│  └─ sensor_samples.csv
├─ knowledge/
│  └─ fault_knowledge.json
├─ models/
│  └─ diag_bundle.joblib
├─ src/
│  ├─ workflow.py
│  └─ llm_client.py
├─ outputs/
│  ├─ metrics.json
│  ├─ sample_diagnosis.json
│  ├─ confusion_matrix.png
│  └─ feature_importance.png
├─ app.py
├─ generate_data.py
├─ train_model.py
├─ run_demo.py
├─ requirements.txt
└─ README.md
关于作者
本文配套的建模可直接套用的AI Agent和skill、完整代码数据包、实证分析,可加小助手:tecdat_cn领取,我们可提供全流程的辅助学术合规辅导、1v1建模陪跑服务,助力顺利完成科研、通过答辩。
作者系工业设备状态监测方向分析师,拥有多年传感器数据挖掘与可解释建模经验。