ChatGPT大模型荐股与夏普比率投资组合优化系统实现
本文把大模型荐股名单转成可执行持仓:用提及频次筛选标的,用均值方差框架求解夏普比率最优权重,与沪深300基准做样本外对照,附 agent ,Python 代码、数据与分析流程。
成为新会员获取本项目完整教程、代码、数据和AI智能体
大模型荐股与夏普比率投资组合优化的实现
基于两份大模型荐股数据构建A股组合,均值方差求解夏普最优权重,附代码与数据
内容提要
本文把大模型荐股名单转成可执行持仓:用提及频次筛选标的,用均值方差框架求解夏普比率最优权重,与沪深300基准做样本外对照,附 agent ,Python 代码、数据与分析流程。
中文摘要
痛点:大模型给出的股票名单是非结构化的自然语言输出,单次回答噪声大、偏好强度不可度量,团队往往只能把它当作灵感来源,缺少一条把它变成持仓、再变成可评估业绩的闭环链路。
方法:本文用多轮问询沉淀推荐频次,把离散选择信号聚合成可排序、可截断的偏好因子;按阈值筛选后构建组合,先用人工设定的差异化主观权重作基线,再以 2017 至 2021 年数据估计均值与协方差,用序列二次规划(SLSQP)在权重和为 1、非负、单票上限 0.2 的约束下求解夏普比率最优权重作为改进方案。
结果:ChatGPT 侧 107 条推荐记录覆盖 39 只个股,筛出 8 只成分股,宁德时代被提及 9 次为最高;文心一言侧 73 条记录覆盖 44 只个股,筛出 11 只成分股,最高频的恒瑞医药仅 4 次。两组方案在 2022 年全年区间与沪深300指数做三方对照,主观权重与优化权重的曲线形态出现可见分离,优化方案把标的间相关性结构纳入了权重决策。
价值:给出一套可复用的评估方法论,任何来源的选股意见都能进入”频次筛选—权重求解—基准对照”这条流水线接受检验,并可分离出选股能力与配置能力各自的贡献。
关键词:大模型荐股、投资组合优化、夏普比率、均值方差框架、沪深300基准、A股量化、Python、SLSQP
研究背景与痛点
大模型进入投研流程之后,最常被问到的一个现实问题是:它给出的股票名单到底能不能直接用?不少团队把模型输出当成灵感来源,却始终缺一条把它变成持仓、再变成可评估业绩的闭环链路。我们此前受客户委托完成过一个智能投研方向的咨询项目,其中的核心诉求正是”让模型的选股意见可落地、可比较、可解释”,这与本文要解决的问题高度一致。
具体到方法上,本文的思路并不复杂,但每一步都对应一个真实决策环节。第一步是把模型的多次回答沉淀成频次信号,用”被提及多少次”来刻画模型对一只股票的偏好强度,这一步本质上是在把非结构化的自然语言输出转成可量化的因子。第二步是给筛选出的标的配上权重,先用一组人工设定的差异化权重作为基线,再用均值方差框架求解夏普比率最优权重作为改进方案,两者形成对照。第三步是把它们放到同一个回测区间里,与沪深300指数放在一起比较,看超额收益究竟来自选股还是来自权重方案。
需要提醒的是,本文的价值不在于证明某个模型”更会选股”,而在于给出一套可复用的评估方法论:任何来源的选股意见,都可以被塞进”频次筛选—权重求解—基准对照”这条流水线里接受检验。
本文将我们的大模型荐股组合优化建模经验封装为一个 AI Agent
本项目完整教程、代码、数据和AI智能体
技术方案总览
本节给出全文的技术脉络。整条链路从非结构化的模型输出出发,经过频次聚合变成可计算信号,再分出主观权重与优化权重两条支路,最后汇入与基准的对照评估。
三条支路的分工是:主观权重代表”直接照搬模型意见”,夏普比率最优权重代表”在模型标的池内做配置优化”,沪深300指数代表”什么都不做只买大盘”。三者并列才能回答超额收益的来源问题。
数据来源与预处理
本节交代本文所用数据的口径与 预处理 方式。荐股数据来自对两个大模型的多轮问询,行情数据用于回测与参数估计。
数据名称:ChatGPT 荐股数据(ChatGPT Stock Recommendation Data)、文心一言荐股数据( ERNIE Stock Recommendation Data)、A 股历史行情数据(A-Share Historical Quotes)、沪深300指数行情数据(CSI 300 Index Quotes)
- 数据量:ChatGPT 荐股记录 107 条,覆盖 39 只个股;文心一言荐股记录 73 条,覆盖 44 只个股;筛选后构建 ChatGPT 组合 8 只成分股、文心一言组合 11 只成分股
- 字段:股票代码、股票名称(荐股数据);日期、开盘、收盘、最高、最低、成交量(行情数据);date、close(指数数据)
- 数据来源:大模型多轮问询输出内容由拓端团队进行人工整理和核对,行情数据取自某公开金融数据接口,全部内容真实有效
- 时间跨度:行情回测区间为 2022 年 1 月 1 日至 2022 年 12 月 31 日;权重优化的参数估计区间为 2017 年 1 月 1 日至 2021 年 12 月 31 日
- 区域跨度:中国 A 股市场,覆盖上海证券交易所主板、深圳证券交易所主板与创业板
- 数据格式:csv 文本格式(荐股与组合持仓)、Excel 表格与内存中的 DataFrame(行情数据)
- 数据简介:荐股数据通过向两个大模型反复提出相同结构的选股问询获得,每一条记录代表一次独立问询中模型给出的个股建议,同一只股票被多次提及即反映该模型对它的偏好强度,因此可以用提及次数作为刻画”模型信心”的衡量指标。行情数据统一采用后复权口径,消除分红送转造成的价格跳空,保证收益率序列的连续性。指数数据用于构造市场基准,评价组合是否真正跑赢大盘。
- 本数据可支撑的主题实证研究:一是比较两个大模型在选股偏好上的行业集中度差异;二是以提及频次构造主观权重并检验其相对市场基准的超额表现;三是用均值方差框架求解夏普比率最优权重,与大模型主观权重形成对照;四是检验样本外区间内优化权重的稳定性与换手成本。
- 数据指标:股票代码、股票名称、推荐次数、组合权重、日度简单收益率、累计收益率、年化收益率、年化波动率、协方差矩阵、夏普比率
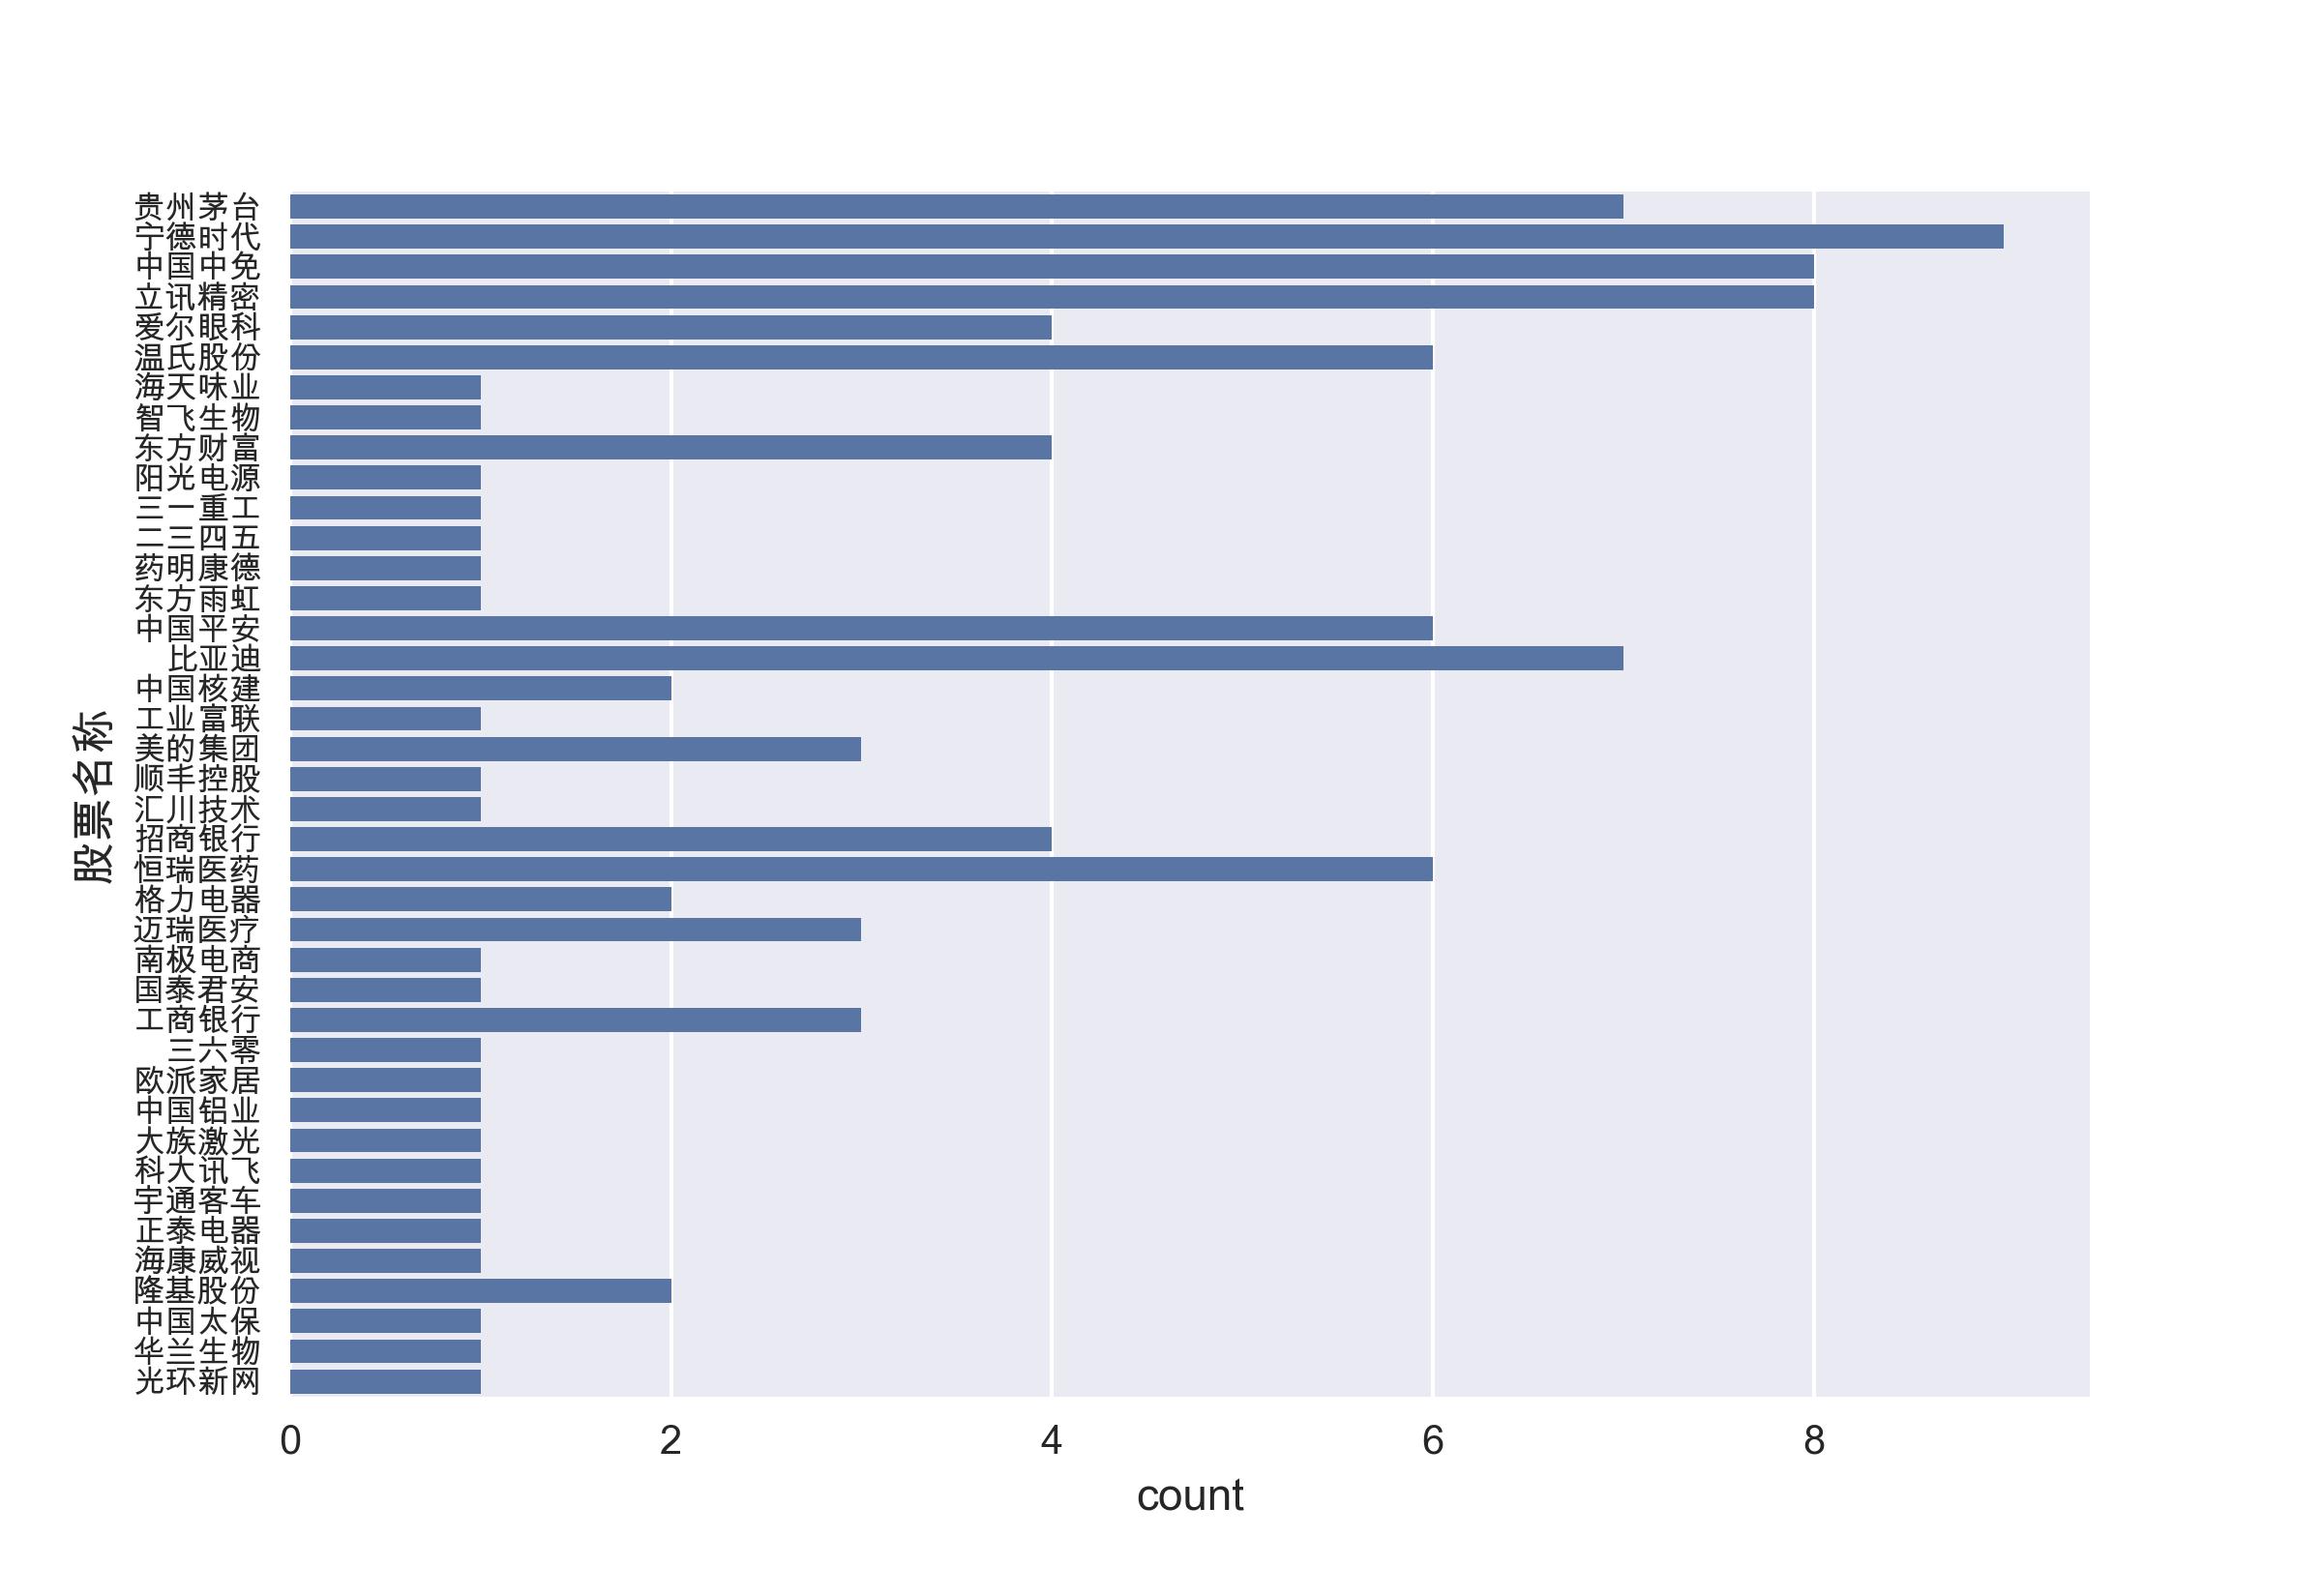
- 数据展示:下图给出 ChatGPT 荐股数据中各只个股被提及次数的分布,横轴为个股名称,可以直观看出推荐偏好高度集中在少数龙头标的上。
1预处理要点
预处理的重头戏不在清洗,而在口径统一,有三处必须留意。
- 证券代码统一按 字符串 读入。A 股代码存在以 0 开头的情况(如 000651、002475),若按数值读入会丢失前导零,后续与行情接口对接时取不到数据。
- 行情统一取后复权口径。分红送转会造成价格跳空,直接算收益率会出现虚假的大幅跳变,后复权能保证收益率序列连续。
- 大模型输出的股票名称需要人工核对。同一代码在不同批次的回答中可能对应不同名称,这是模型输出本身的噪声,不核对会误导行业归因。
核心方法与方案设计
本节解决第一个关键问题:如何把大模型的自然语言输出变成可排序、可截断的量化信号。
1从自然语言输出到频次因子
大模型每次回答给出的股票名单是离散的、非结构化的,直接拿来用有两个麻烦:一是单次回答噪声大,二是不好判断它对某只股票到底有多看好。解决办法很朴素——多问几次,数一数每只股票被提及了多少次。
注释
这就像饭点到了找餐厅,问一个朋友可能得到随机答案,问十个朋友都提到同一家店,那这家店大概率是真的好。频次在这里扮演的角色,就是把”一次性的意见”沉淀成”稳定的偏好”。
行业术语上,这一步叫做离散选择信号的频次聚合,它把模型输出映射成了一个可以排序、可以截断的连续型偏好得分。
2频次统计与分布可视化
第一轮对话:基础数据采集与偏好统计
背景
我们已经收集了两个大模型各自若干轮的选股回答,存成了两部 csv 文件,每条记录是一只被推荐个股的代码与名称。
目标
我想先把 ChatGPT 的回答读进来,看看它推荐的股票集中在哪些标的上,有没有明显的头部效应。
约束
请用 pandas 读取,证券代码统一按字符串处理避免前导零丢失;用 seaborn 画计数图,图片 300 dpi 保存,中文名称要能正常显示。
荐股数据读取与频次分布可视化
# 导入数据处理与绘图工具
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
# 读取大模型推荐的个股清单,统一按字符串读入以保留代码前导零
reco_gpt = pd.read_csv('ChatGPT荐股.csv', dtype='str', engine='python')
# 检查读入结果
print(reco_gpt.head())
# 设置画布分辨率与中文字体
上图中横轴方向密集堆叠的股票,就是模型反复提到的标的。从实测结果看,ChatGPT 的 107 条推荐记录覆盖 39 只个股,头部集中度相当明显:宁德时代被提及 9 次,中国中免、立讯精密、比亚迪各 8 次,贵州茅台 7 次,温氏股份、中国平安、恒瑞医药各 6 次。也就是说,不到两成的标的吸走了接近一半的推荐次数。
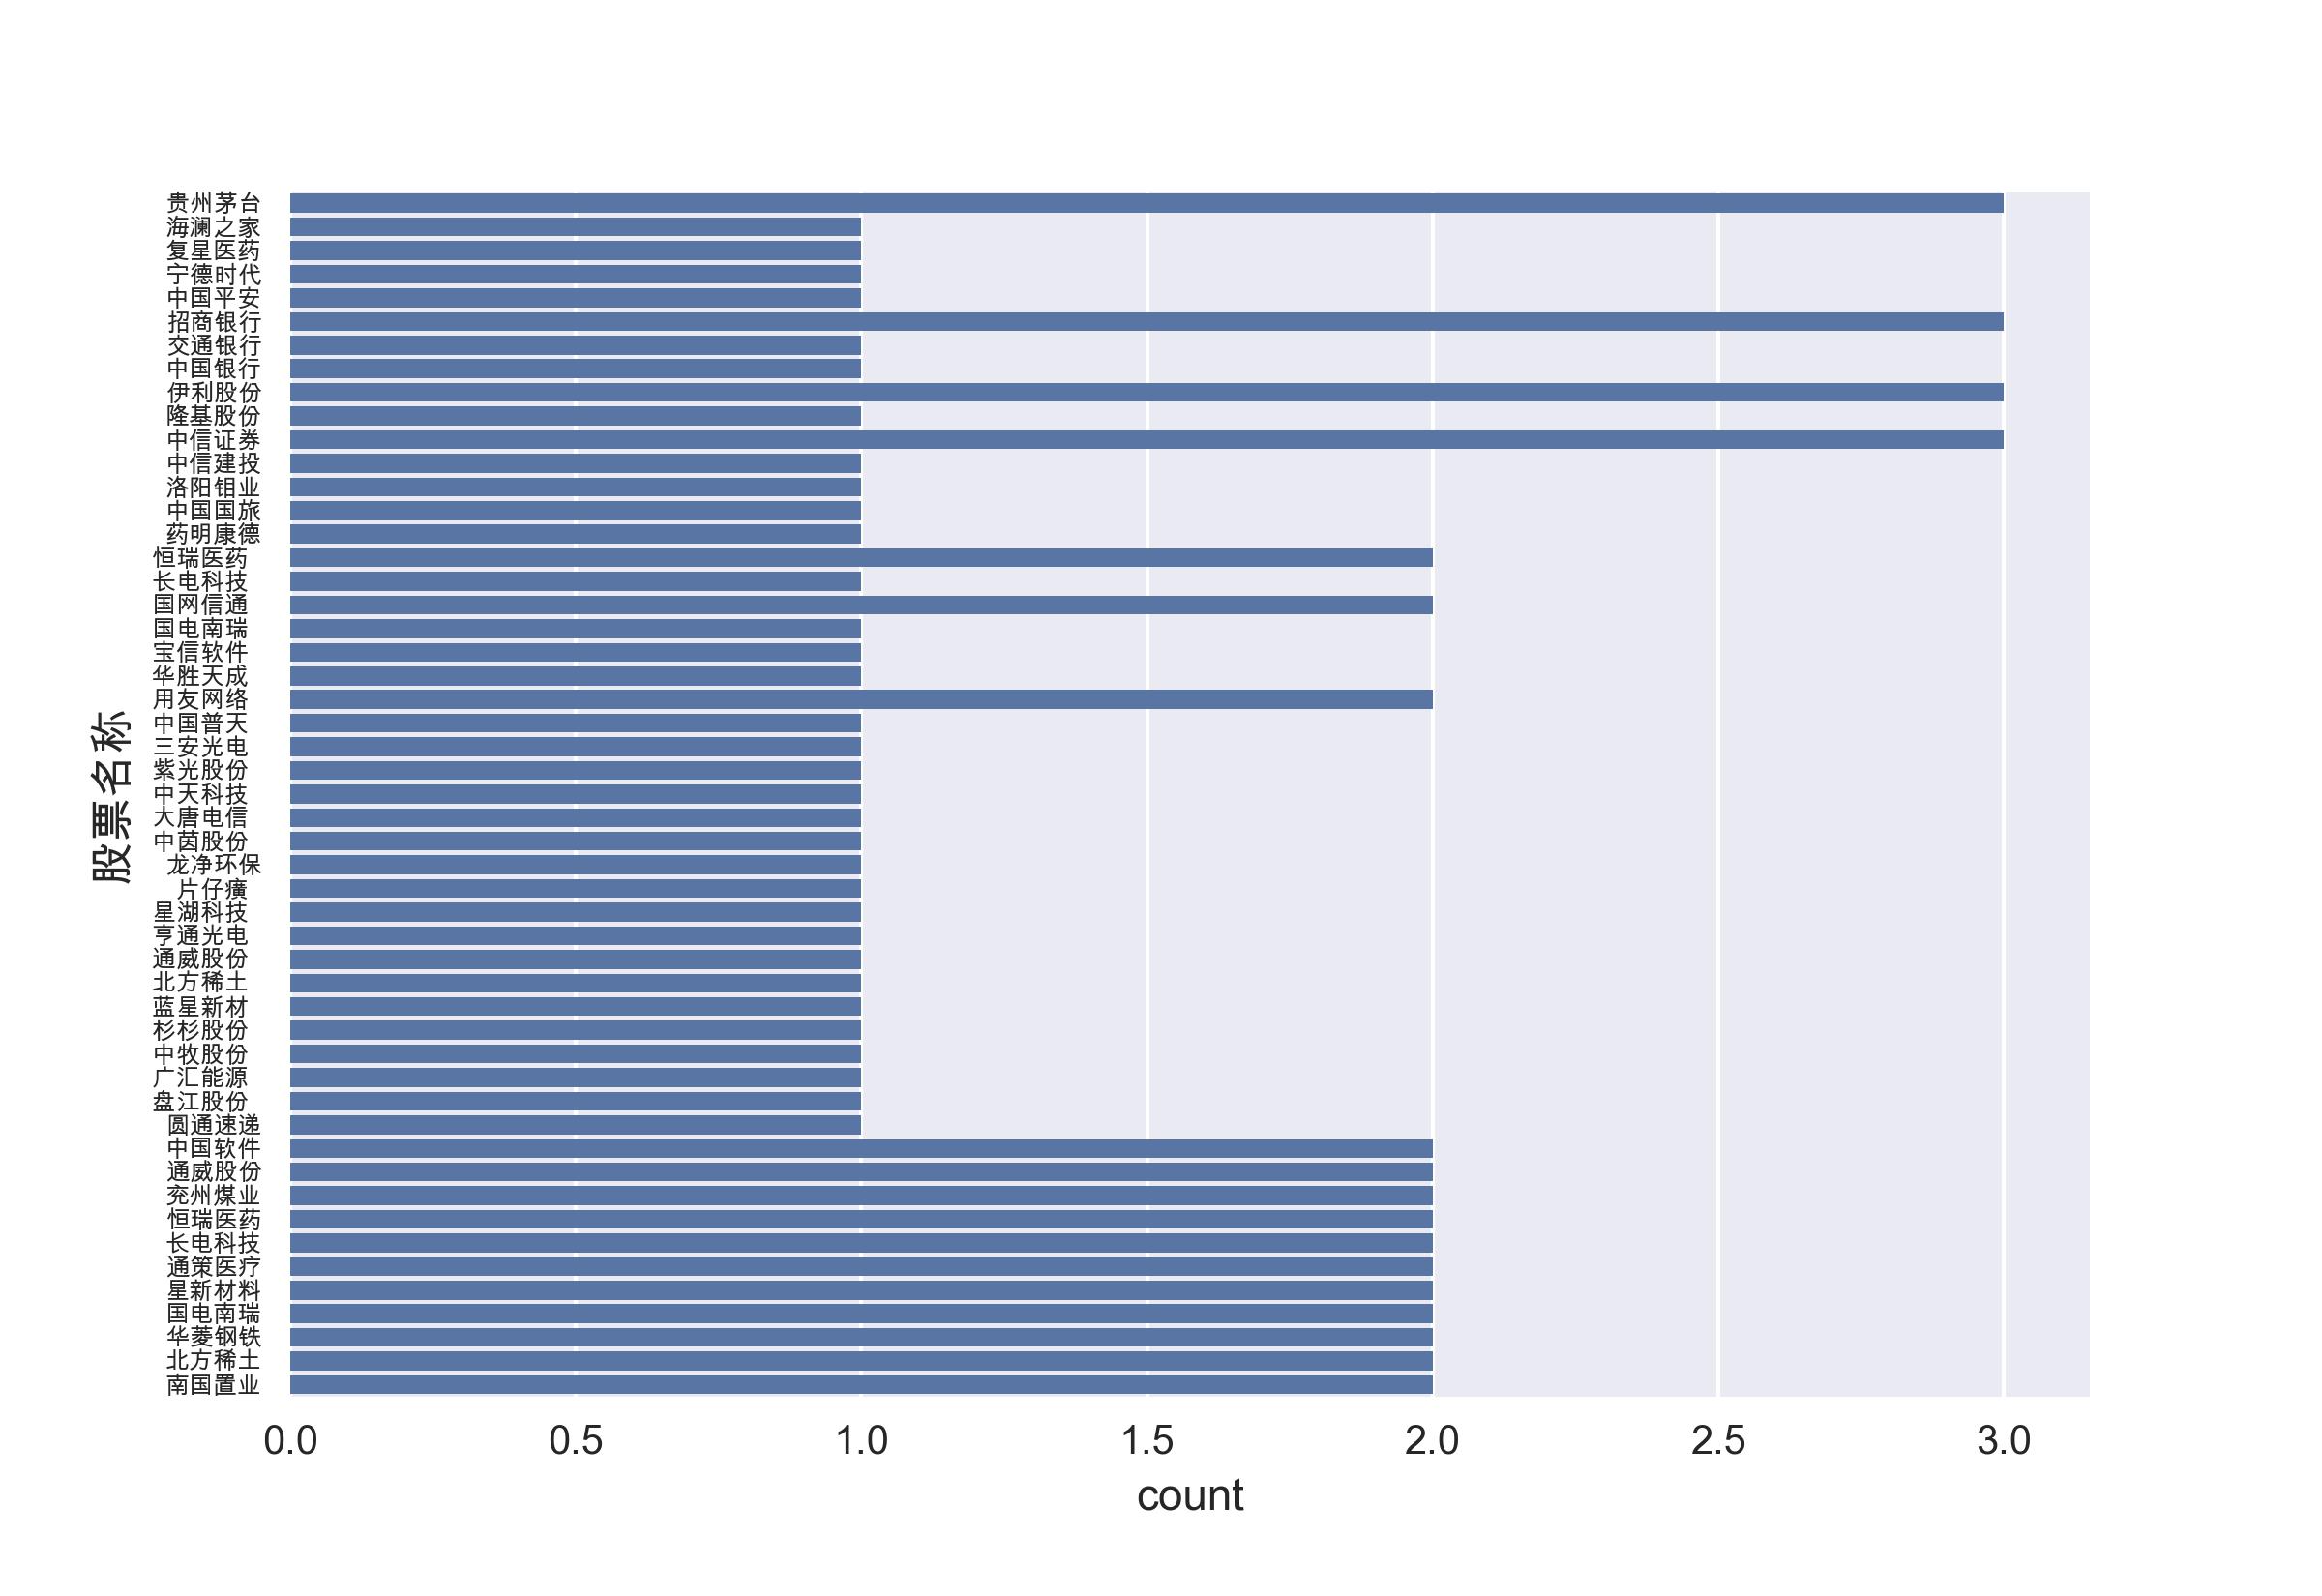
文心一言的表现则是另一番景象。它的 73 条记录覆盖了 44 只个股,分布要分散得多,最高频的恒瑞医药也只有 4 次,其余多为 3 次。
3按频次筛选构建组合
拿到频次之后就要做取舍:次数太低的标的很可能是模型的随机发挥,纳入组合只会放大噪声。这里用一个简单的阈值规则,ChatGPT 侧保留提及 5 次以上的标的,文心一言侧因为整体频次偏低,保留 3 次以上。
运行后 ChatGPT 侧得到 8 只成分股,文心一言侧得到 11 只成分股。两个组合在行业分布上差异明显:ChatGPT 的组合偏向新能源、消费与医药龙头,文心一言的组合则出现了更多制造业与周期类标的,且部分名称存在前后不一致的情况(同一代码在不同批次里对应了不同名称),这也是大模型输出需要做人工核对的原因之一。
最受欢迎的见解
- Python员工数据人力流失预测:ADASYN采样CatBoost算法、LASSO特征选择与动态不平衡处理及多模型对比研究
- R分布式滞后非线性模型DLNM分析某城市空气污染与健康数据:多维度可视化优化滞后效应解读
- Python古代文物成分分析与鉴别研究:灰色关联度、岭回归、K-means聚类、决策树分析
- Python TensorFlow OpenCV的卷积神经网络CNN人脸识别系统构建与应用实践
- Python用Transformer、SARIMAX、RNN、LSTM、Prophet时间序列预测对比分析用电量、零售销售、公共安全、交通事故数据
- MATLAB贝叶斯超参数优化LSTM预测设备寿命应用——以航空发动机退化数据为例
- Python谷歌商店Google Play APP评分预测:LASSO、多元线性回归、岭回归模型对比研究
- Python+AI提示词糖尿病预测模型融合构建:伯努利朴素贝叶斯、逻辑回归、决策树、随机森林、支持向量机SVM应用
主观权重方案与回测设置
本节给出基线方案:用人工设定的差异化权重构建组合,并在 2022 年区间与沪深300指数做对照,回答第二个关键问题。
1权重设定与收益计算
有了标的名单,还需要决定每只买多少。一个自然的想法是按推荐次数分配权重——被提到越多次,仓位越重。不过完全按频次归一化会让权重过度集中,实践中更常见的做法是参考频次排序给出一组差异化的主观权重,同时控制单票上限。
组合的收益率按加权求和得到:
Rp = w1 * r1 + w2 * r2 + ... + wn * rn
其中 wi 为第 i 只股票的权重,ri 为对应股票的日度简单收益率。累计收益则按 (1 + Rp) 逐日累乘得到。
2与沪深300基准的对照
引入基准对照与业绩评估
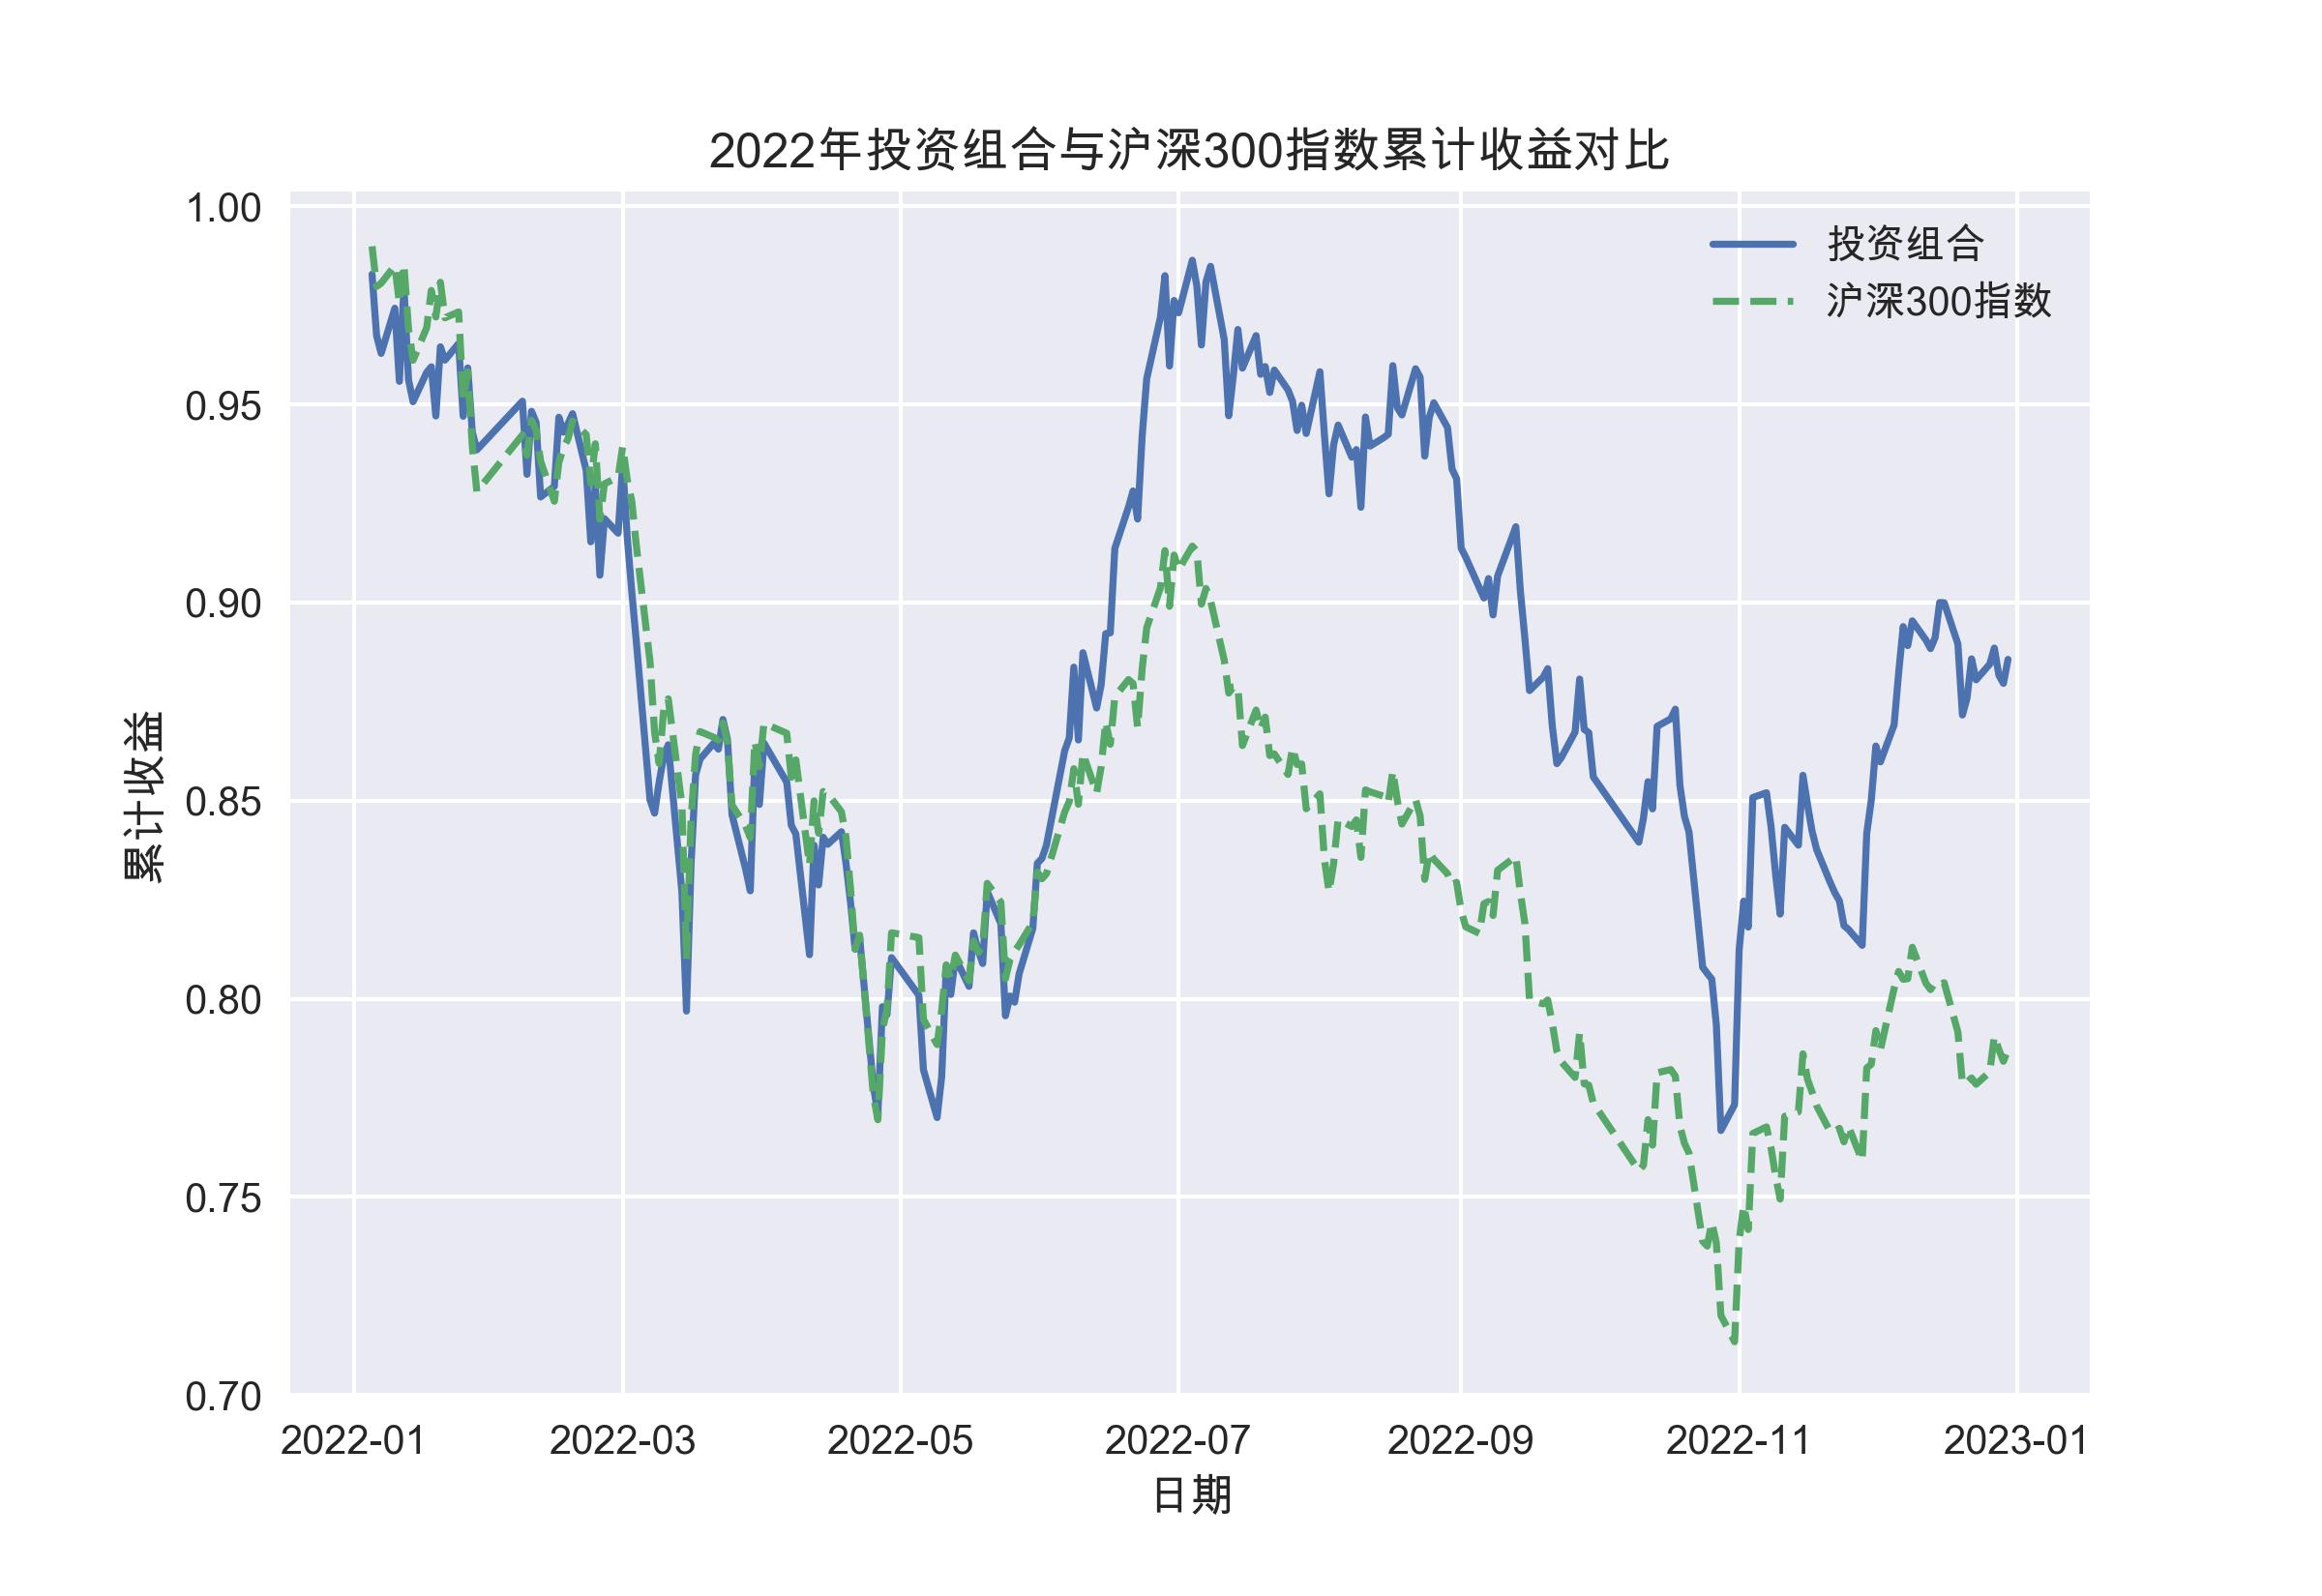
读取上图时要注意一点:两条曲线的相对位置会随时间变化,某些阶段组合跑赢基准,另一些阶段又落后。这种起伏本身说明,大模型选出的标的与大盘的走势并不完全同步,其超额收益高度依赖于所处的市场环境。2022 年 A 股整体处于震荡调整状态,成长风格回调明显,而模型偏好又恰好集中在成长龙头上,这对组合表现构成了直接的压力。
这也引出了一个必须回答的问题:如果表现不及预期,问题出在”选股”还是出在”权重”?
夏普比率最优权重的求解
本节给出改进方案,回答第三个关键问题:权重方案本身能带来多少改善。
1均值方差框架
要分清是选股问题还是权重问题,就要把权重这一环单独拿来做优化。经典做法是马科维茨的均值方差框架:在给定标的池的前提下,寻找一组权重,让组合在承担单位风险时获得的回报最高。
夏普比率的表达式很简洁:
Sharpe = (Rp - Rf) / sigma_p
其中 Rp 是组合预期收益,Rf 是无风险利率,sigma_p 是组合收益的标准差。组合的标准差则由协方差矩阵决定:
sigma_p^2 = w^T * Sigma * w
这里 Sigma 是各标的收益率之间的协方差矩阵,w 是权重向量。
注释
可以把协方差矩阵理解成一张”关系网”,它记录的不是每只股票自己有多能涨,而是它们之间会不会同涨同跌。两只高度相关的股票放在一起,分散风险的效果就大打折扣;反之,把相关性低的股票配在一起,即使单只波动不小,组合整体也能平稳很多。这就是为什么权重优化不能只看单只股票的收益,必须看这张关系网。
2带约束的最优化求解
引入领域知识约束求解最优权重,提示词如下:
背景
我想检验一下,是不是权重方案拖累了组合表现,所以要用优化方法重新求一组权重。
目标
请用 2017 到 2021 年的行情估计各标的的均值收益与协方差矩阵,然后求解使夏普比率最大的权重组合。
约束
目标函数取负夏普比率以配合 minimize 求最小;约束条件为权重之和等于 1 且各权重非负;单只标的上限设为 0.2 以避免过度集中;优化方法用 SLSQP。
代码四:均值与协方差估计及 SLSQP 最优权重求解
这里有三处设定值得说明,也是实际建模中最容易被追问的地方。
第一,为什么用 2017 至 2021 年估计参数、却拿 2022 年做回测?因为均值方差优化对输入参数极其敏感,如果估计区间和回测区间重叠,等于用未来的信息倒推现在的权重,得到的结论是不可信的。把两段区间严格切开,才能保证结论来自样本外检验。
第二,为什么给单只标的设 0.2 的上限?不加约束时,优化器很容易把绝大部分仓位压在一两只历史表现最好的股票上,这种解在样本内看着漂亮,样本外往往很脆弱。加上限是一种正则化手段,牺牲一点理论最优性换取稳定性。
第三,无风险利率按 0 处理会高估夏普比率,严谨的做法应当代入对应期限的国债收益率,这里为简化演示而省略。
3关键参数一览
| 参数项 | 取值 | 作用 |
|---|---|---|
| 参数估计区间 | 2017-01-01 至 2021-12-31 | 估计均值向量与协方差矩阵 |
| 回测区间 | 2022-01-01 至 2022-12-31 | 样本外检验,与估计区间严格分离 |
| 无风险利率 | 0 | 简化处理,会高估夏普比率 |
| 单票权重上限 | 0.2 | 正则化,防止权重过度集中 |
| 权重约束 | 和为 1,且非负 | 不允许做空与杠杆 |
| 优化方法 | SLSQP | 处理带等式与不等式约束的非线性优化 |
| 行情口径 | 后复权 | 消除分红送转造成的价格跳空 |
| 筛选阈值 | ChatGPT 侧 >5 次;文心一言侧 >3 次 | 过滤低置信度标的 |
测试结果与三方对比
本节把主观权重、优化权重、市场基准三条曲线并列,观察权重方案带来的差异。
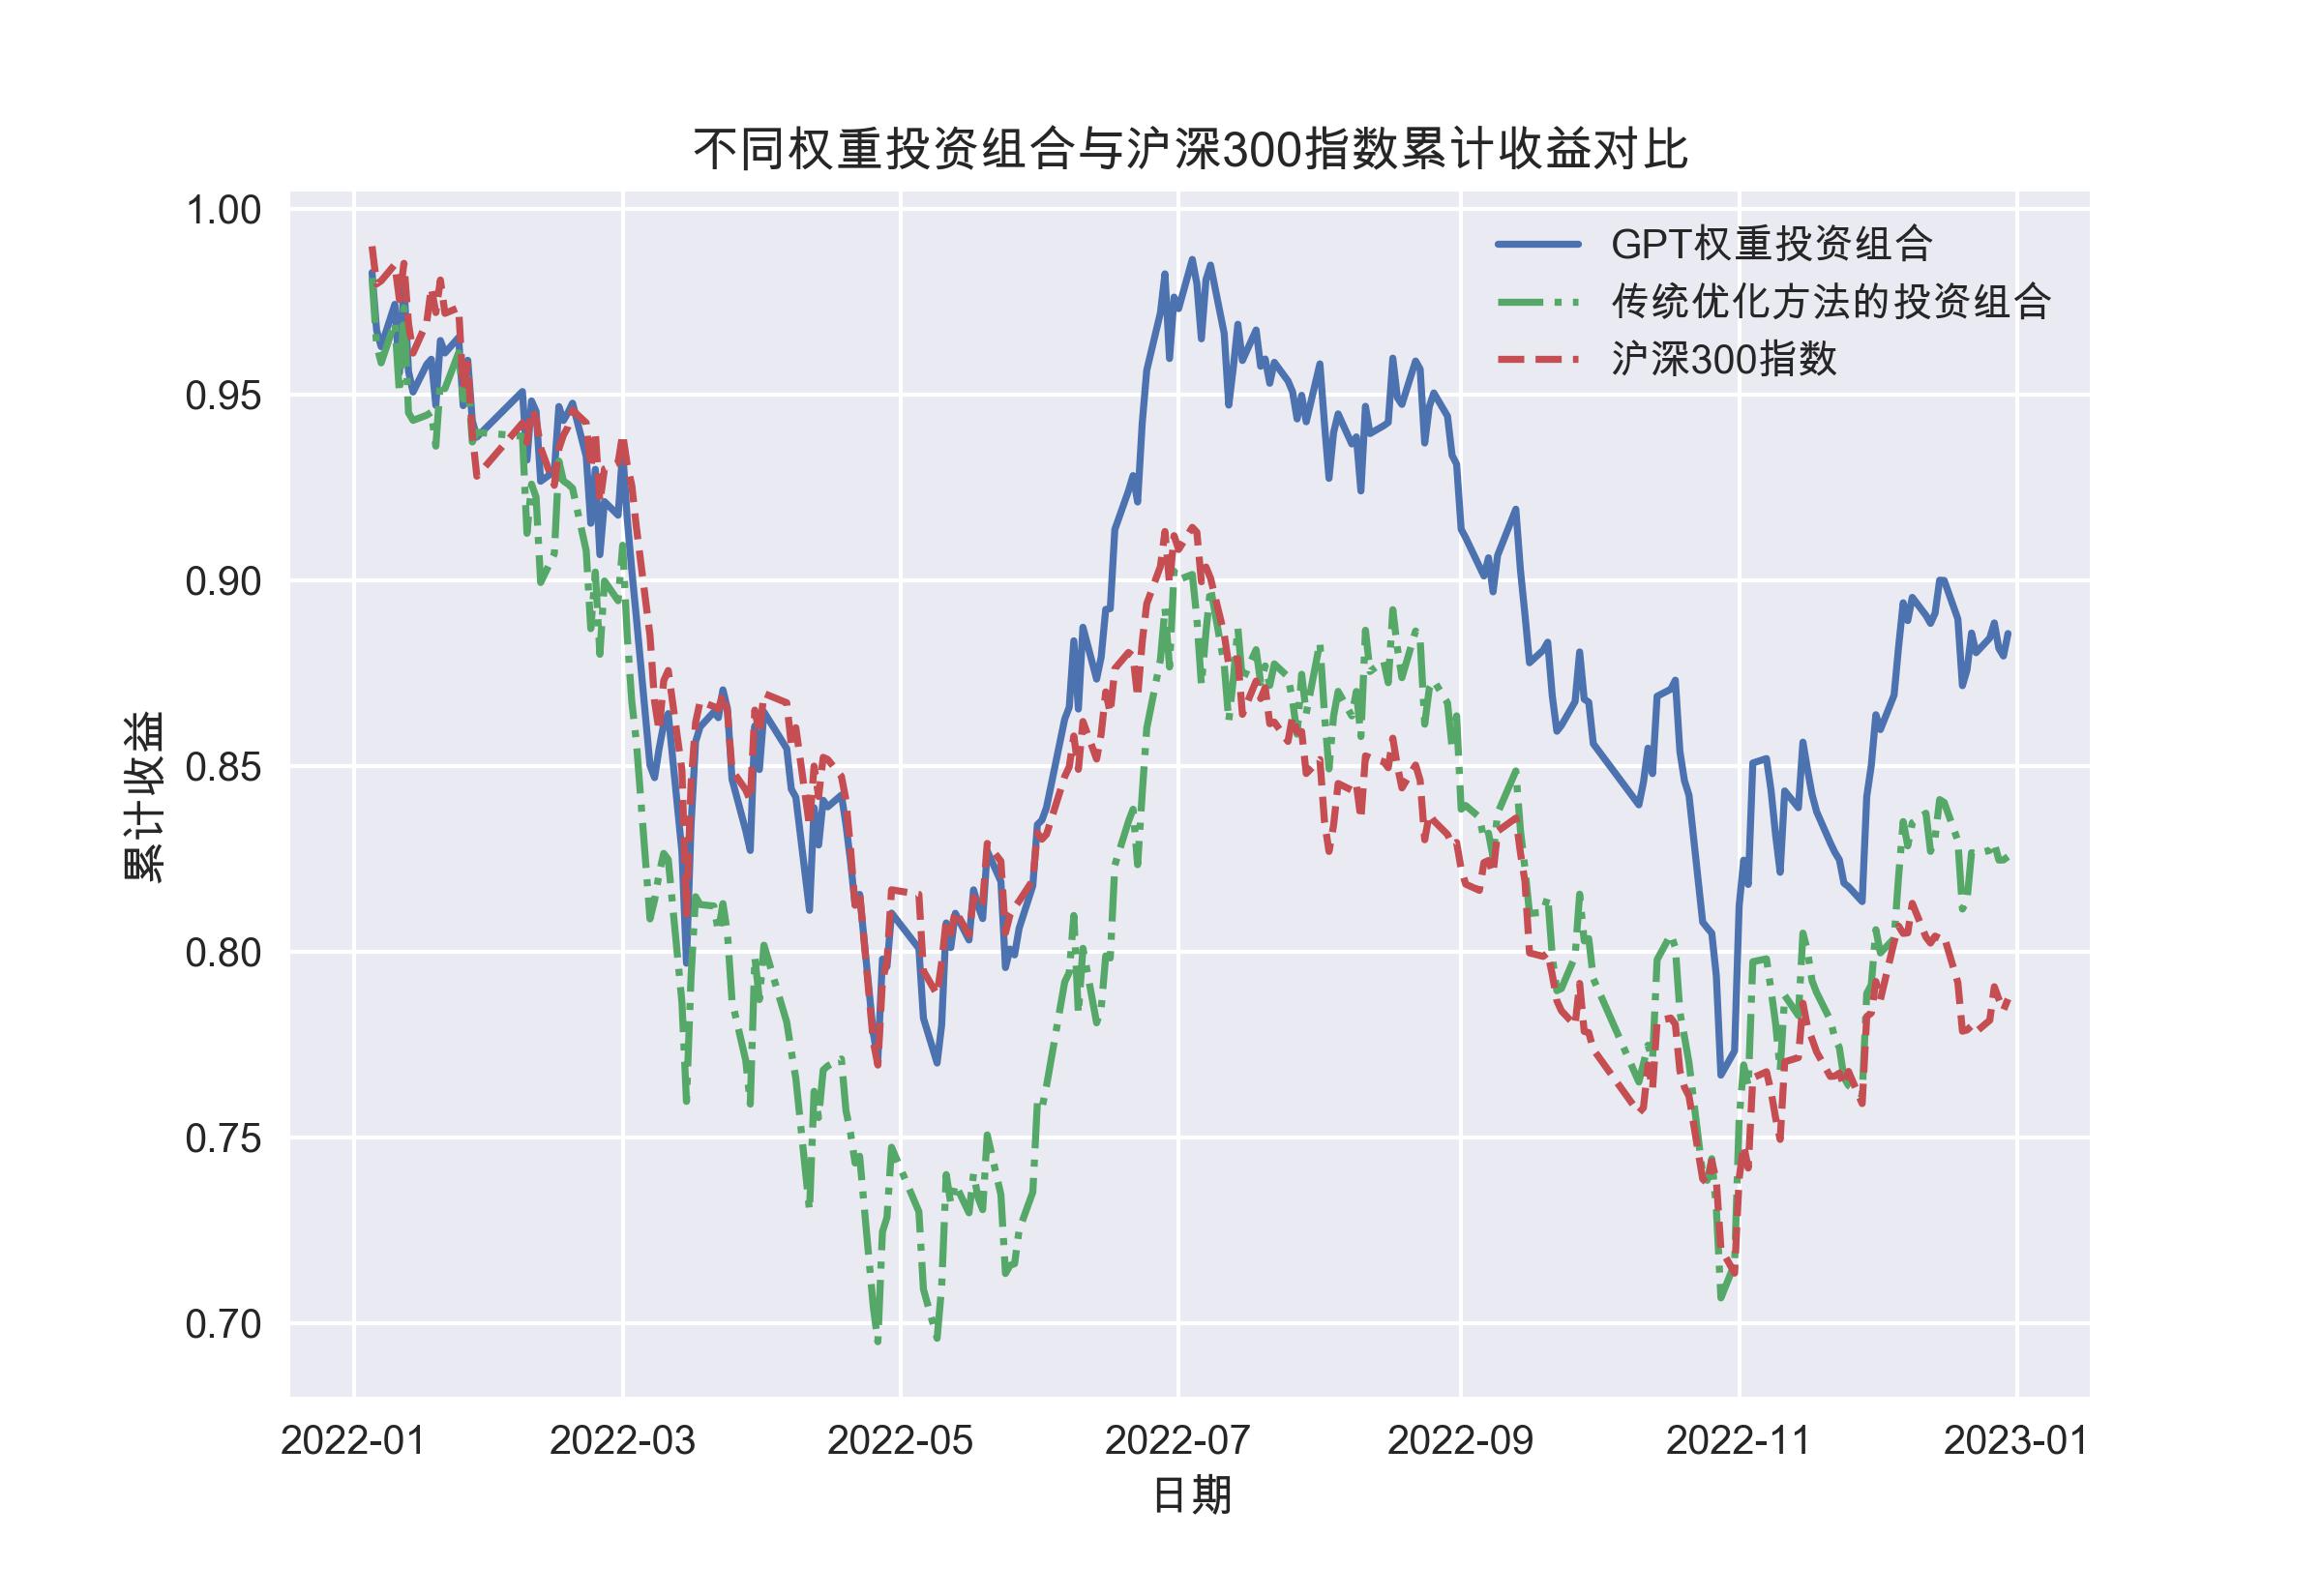
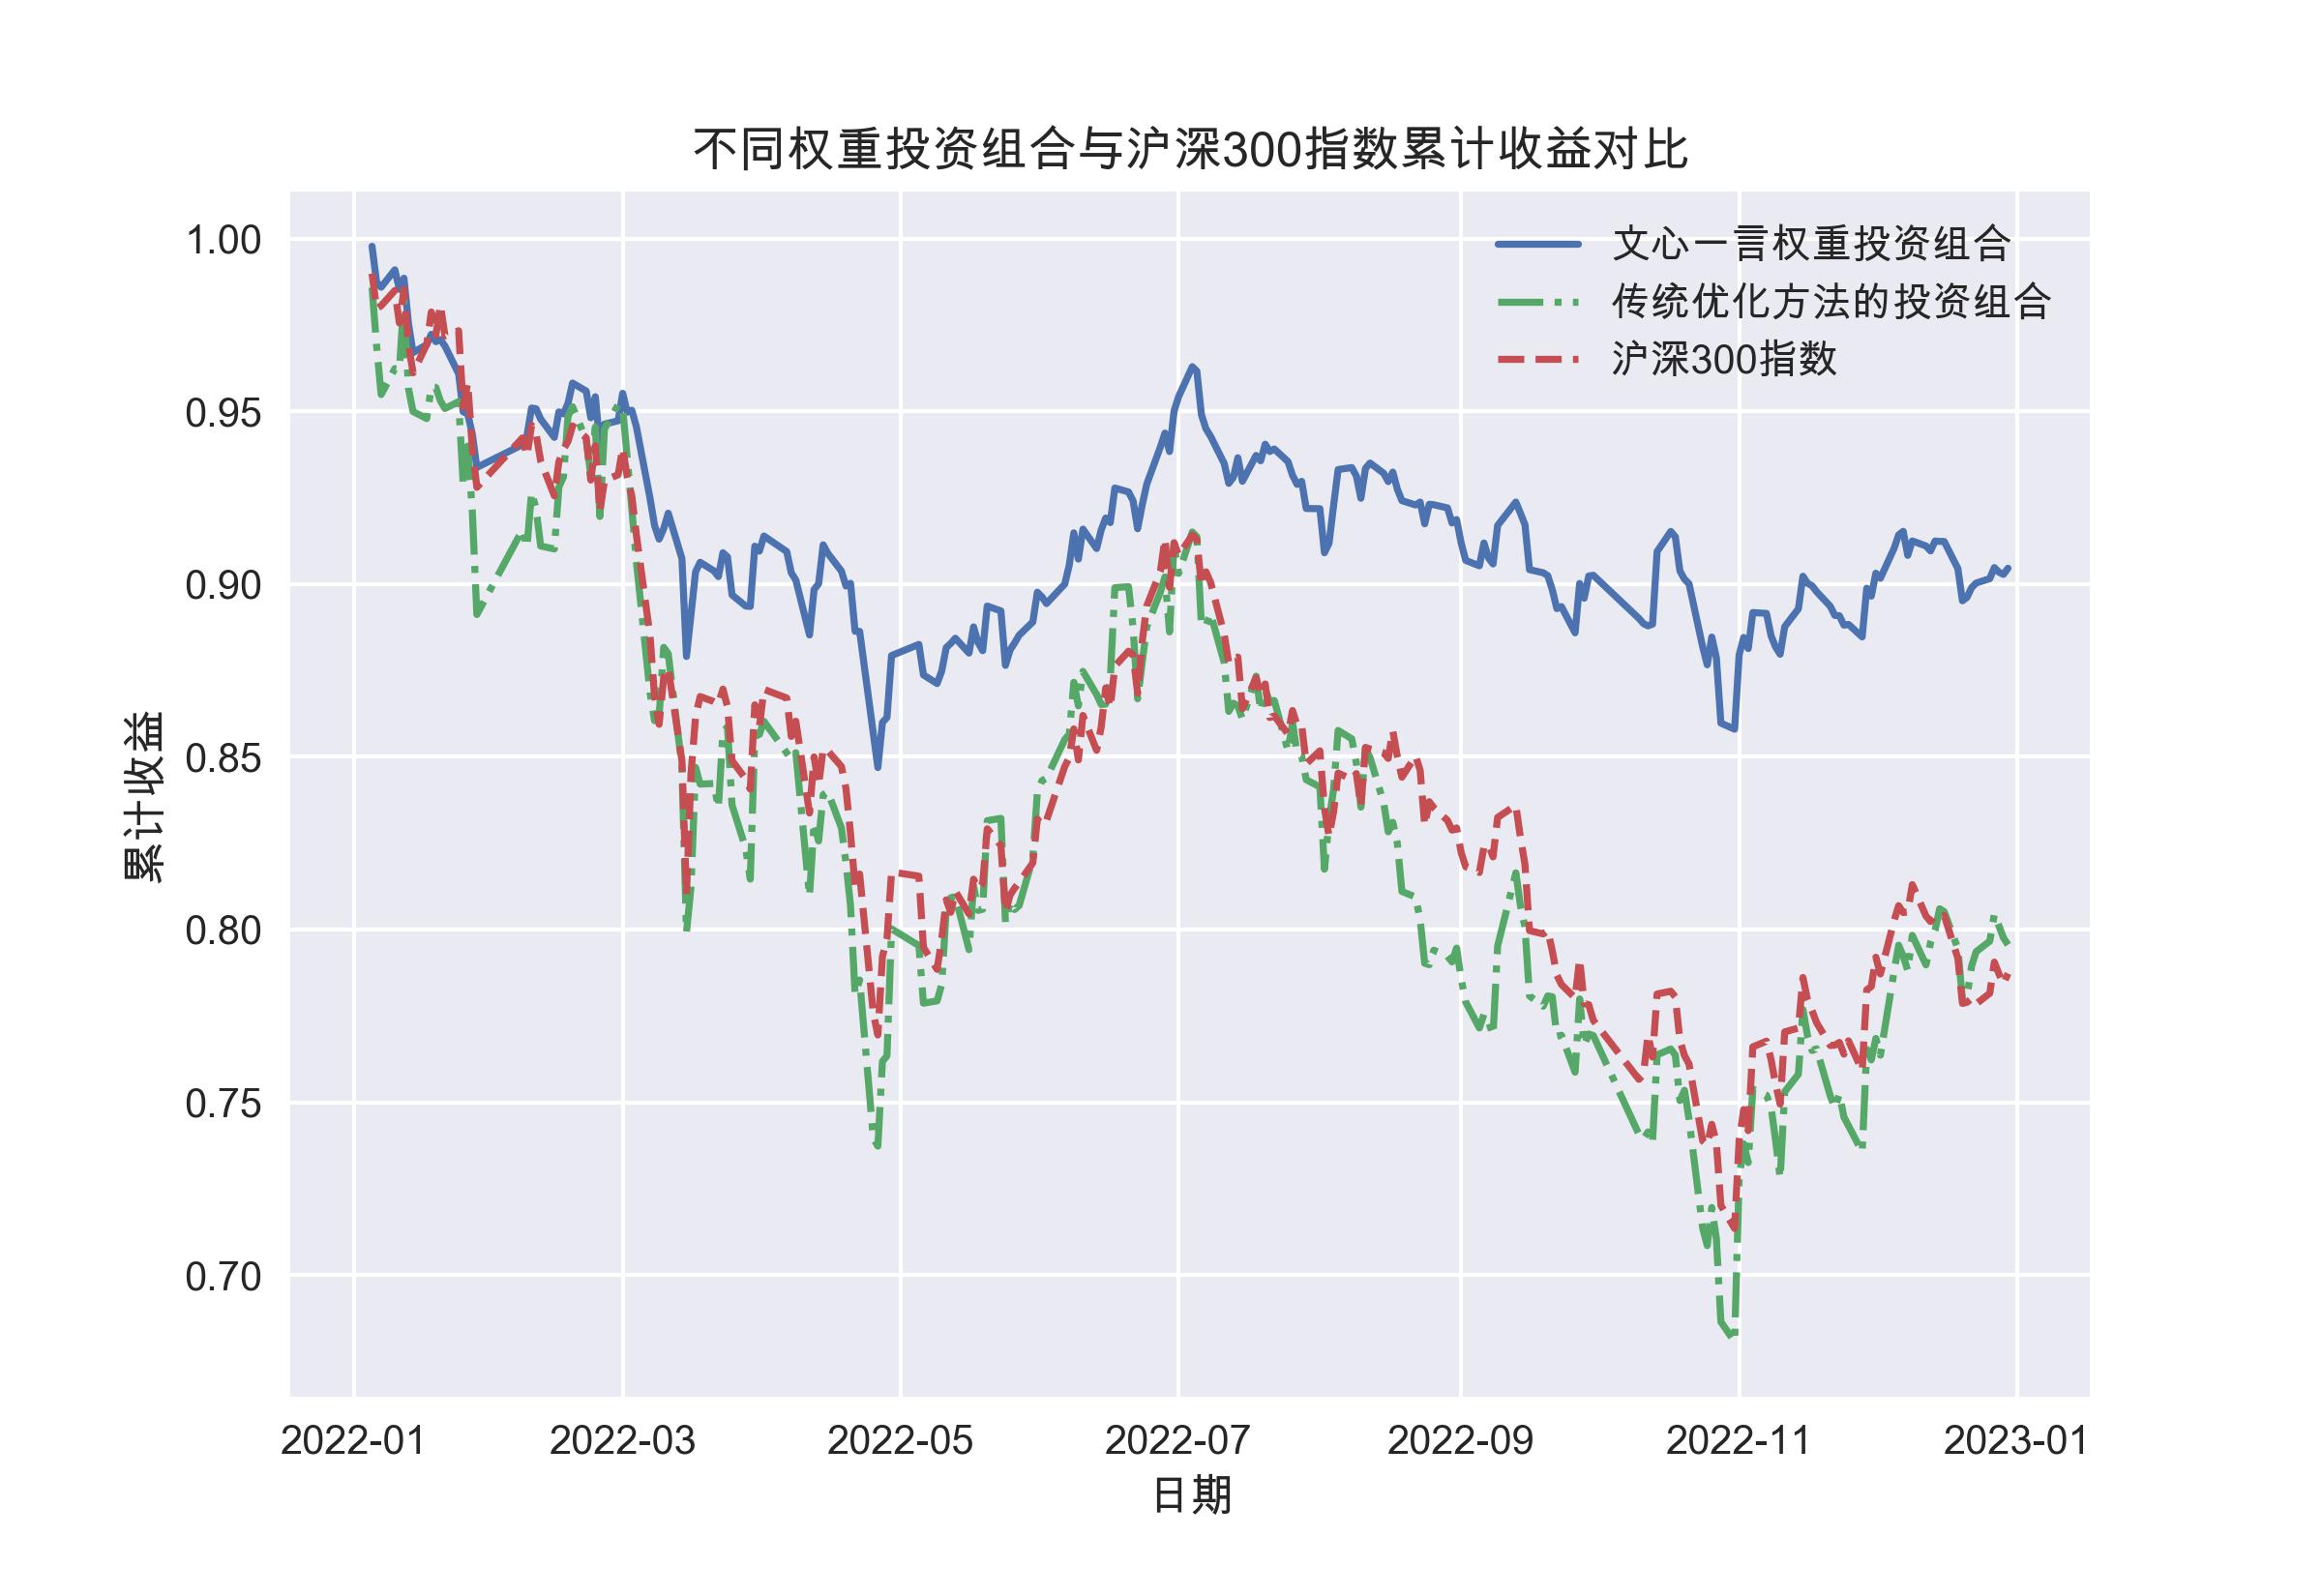
文心一言组合按同样流程走一遍,得到三方对照结果如下。
1三种权重方案对比
下表把三种权重方案的机制差异放在一起比较,便于理解各自的适用边界。
| 对比维度 | 大模型主观权重 | 夏普比率最优权重 | 沪深300基准 |
|---|---|---|---|
| 权重来源 | 依据提及频次人工设定 | 由均值方差优化求解 | 指数成分市值加权 |
| 是否用到协方差信息 | 否 | 是 | 否 |
| 单票集中度控制 | 靠人工经验 | 通过 0.2 上限约束 | 由市值自然决定 |
| 参数依赖 | 仅依赖频次排序 | 依赖均值与协方差估计 | 无参数 |
| 样本外稳定性 | 中等 | 敏感于估计区间选择 | 稳定 |
| 可解释性 | 强,能追溯到模型意见 | 弱,权重由求解器给出 | 强 |
从实测数据看,ChatGPT 组合的 8 只成分股中,推荐次数最高的宁德时代占 9 次,最低的温氏股份、中国平安、恒瑞医药各 6 次,频次差距并不悬殊,这意味着以频次为排序依据的主观权重,其分化程度其实有限。文心一言组合 11 只成分股里,最高 4 次、其余多为 3 次,分化程度更低,主观权重方案几乎退化成近似等权。这也是为什么引入优化权重后,两条曲线的形态会出现肉眼可见的分离。
接下来我们把整个流程做成一个可交互 Agent
一步步把这条分析链路封装成一个 Streamlit 交互式 Agent:上传荐股 CSV → 调参数 → 一键生成频次分布图、成分股权重表、三方累计收益对比图、绩效指标表。教程末尾附完整可直接运行的 app.py。
1. 为什么要做成 Agent?
Notebook 适合研究者自己复跑,但对团队里其他角色有三个门槛:
| 维度 | Notebook(原文形态) | Agent(本教程目标) |
|---|---|---|
| 使用方式 | 打开 ipynb,逐 cell Shift+Enter,改参数要找代码 | 浏览器打开网页,拖文件、拉滑块、点按钮 |
| 参数调整 | 改代码里的 '20220101'、> 5、0.2 | 侧边栏滑块/输入框,改完立刻重跑 |
| 换一份数据 | 会覆盖原始 cell 输出,不敢乱动 | 换 CSV 重新上传即可,分析者零改动 |
| 展示给非技术同事 | 截图贴群 | 发一个 URL |
| 结果形态 | 分散在 5 段代码、5 张图 | 一页报告:图 + 表 + 指标卡 |
做成 Agent 的本质是:把原文”数据采集 → 频次筛选 → 组合构建 → 双路权重 → 基准对照”这条流水线固化成函数,再用 Streamlit 给函数套一层网页表单。任何一份新的”大模型荐股名单”——哪怕来自别的模型——都可以丢进同一条流水线接受检验,这正是原文强调的”可复用评估方法论”。
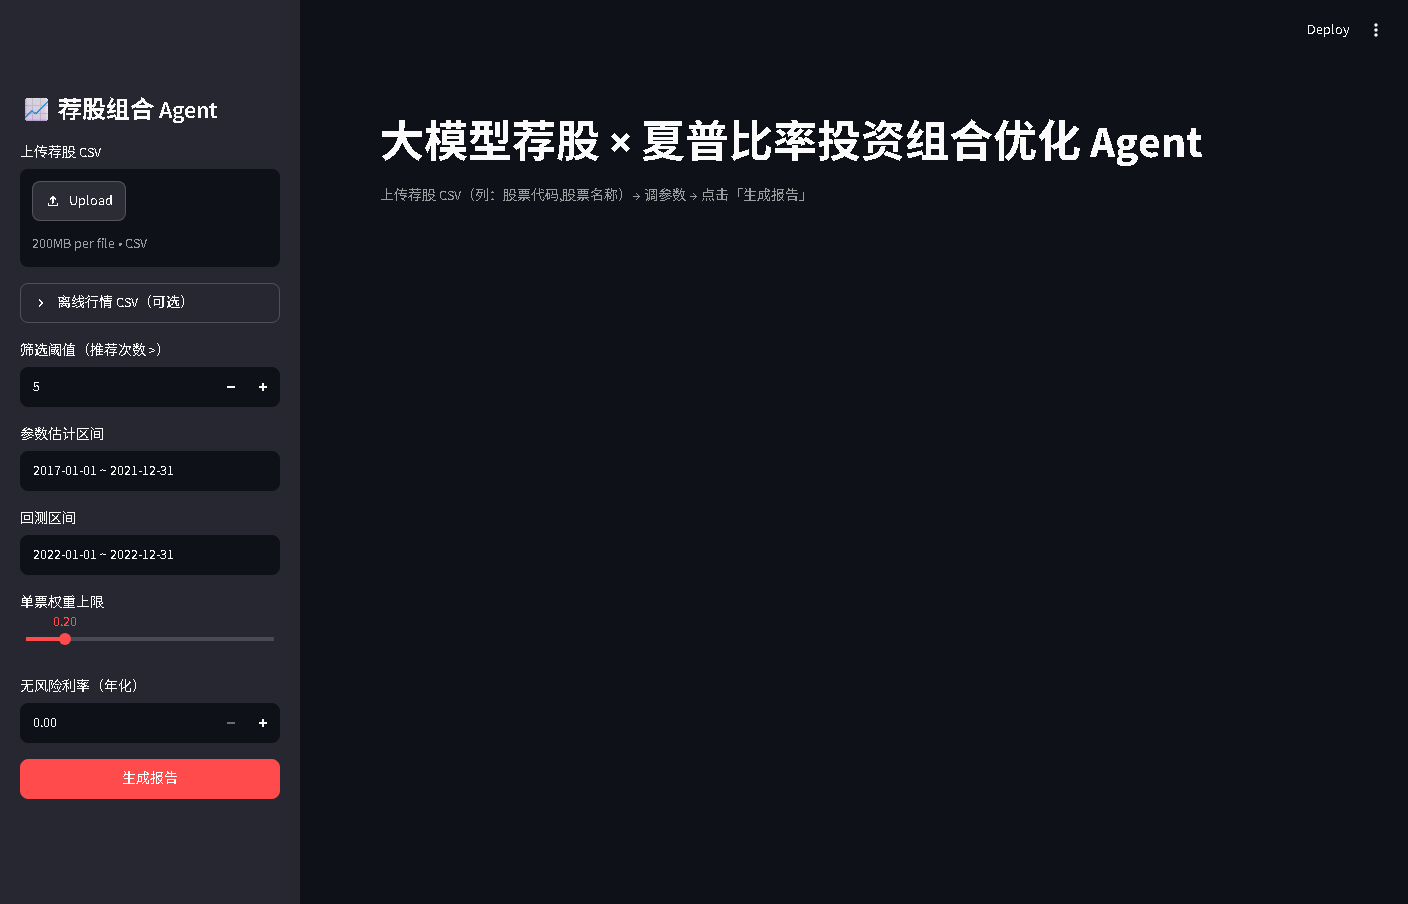
图:Agent 端真实截图(Streamlit 初始页);Notebook 端为原文代码包中的 ipynb,形态可对照 代码截图理解
2. 拆解原文:哪些模块值得封装
先通读原文,把可封装的核心功能模块提取出来。原五段代码(含原文省略部分)对应 Agent 里的六个功能模块:
| # | 原文模块 | 对应原文代码 | Agent 里的功能 |
|---|---|---|---|
| M1 | 荐股数据读取与频次可视化 | 代码一(pd.read_csv(dtype='str') + sns.countplot) | 文件上传 + 频次分布图 |
| M2 | 频次聚合与阈值筛选 | 代码二(groupby('股票代码').count() + > 5) | 阈值滑块 → 成分股候选池 |
| M3 | 主观权重构建与回测 | 代码三(pct_change + dot(holding_w) + 累乘) | 权重表编辑组件 + 组合收益曲线 |
| M4 | 均值/协方差估计 + SLSQP 求解 | 代码四(neg_sharpe + minimize) | 估计区间/单票上限参数 → 最优权重表 |
| M5 | 三方收益对比 | 代码五(主观 / 优化 / 沪深300) | 三线对比图 |
| M6 | 绩效评估 | 原文”评估模块”(年化收益、波动率、最大回撤) | 绩效指标表 + 指标卡 |
两个工程细节直接沿用原文的”预处理要点”,封装时必须保留:
1. 证券代码按字符串读入(dtype=str),否则 002475、000651 会丢前导零;
2. 行情统一后复权(adjust="hfq"),否则分红送转造成虚假跳空。
还有一个原文反复强调的红线——估计区间与回测区间不得重叠。Agent 里我们干脆加一道硬校验:如果用户在界面上把两段区间调到重叠,直接报错拒绝跑,把原文说的”落地时最容易被忽略的区间校验”做进产品里。
3. 准备工作
需要的库(原文 requirements.txt 六个 + Streamlit):
streamlitaksharepandasnumpymatplotlibseabornscipy
安装:
pip install streamlit akshare pandas numpy matplotlib seaborn scipy
中文字体:原文图用 SimHei(黑体)。Windows 自带;macOS/Linux 需另装,否则图上中文全是方框。Agent 里我们写一个跨平台字体探测函数(见第 8 节代码)。
联网说明:行情经 akshare 实时拉取,需要外网可达;如果复现时接口不稳定,Agent 支持上传离线行情 CSV 兜底(对应原文”若接口不可用,可改用随附的离线数据文件”)。
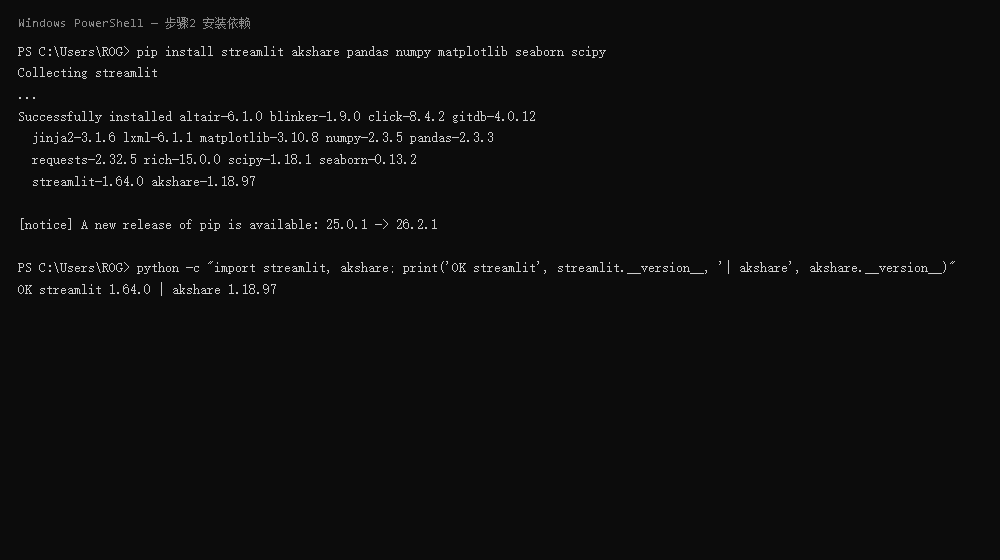
图:pip install streamlit akshare pandas numpy matplotlib seaborn scipy 实际安装输出(streamlit 1.64.0 / akshare 1.18.97)
4. 第一步:把原文代码拆成函数
Notebook 代码是”从上往下流”的脚本,函数化时要改掉三处:①路径和参数从写死变成入参;②plt.show() 删掉(Streamlit 自己会渲染当前 figure);③省略号部分(原文标注”此处省略”)补齐,补齐逻辑按原文口径实现,下文已注明。
4.1 数据读取与频次统计(对应代码一、二)
- 输入:
load_recommendations吃上传文件对象;build_portfolio吃频次表 + 阈值。 - 输出:
compute_frequency返回全量频次表(画图用),build_portfolio返回成分股表(后续权重/回测用)。 - 一处小改造:原文直接
count()整个 DataFrame 再取列,这里用groupby(...)[...].count(),避免聚合出多余列——正是原文”注意聚合时不要引入多余的列”这条约束的实现。
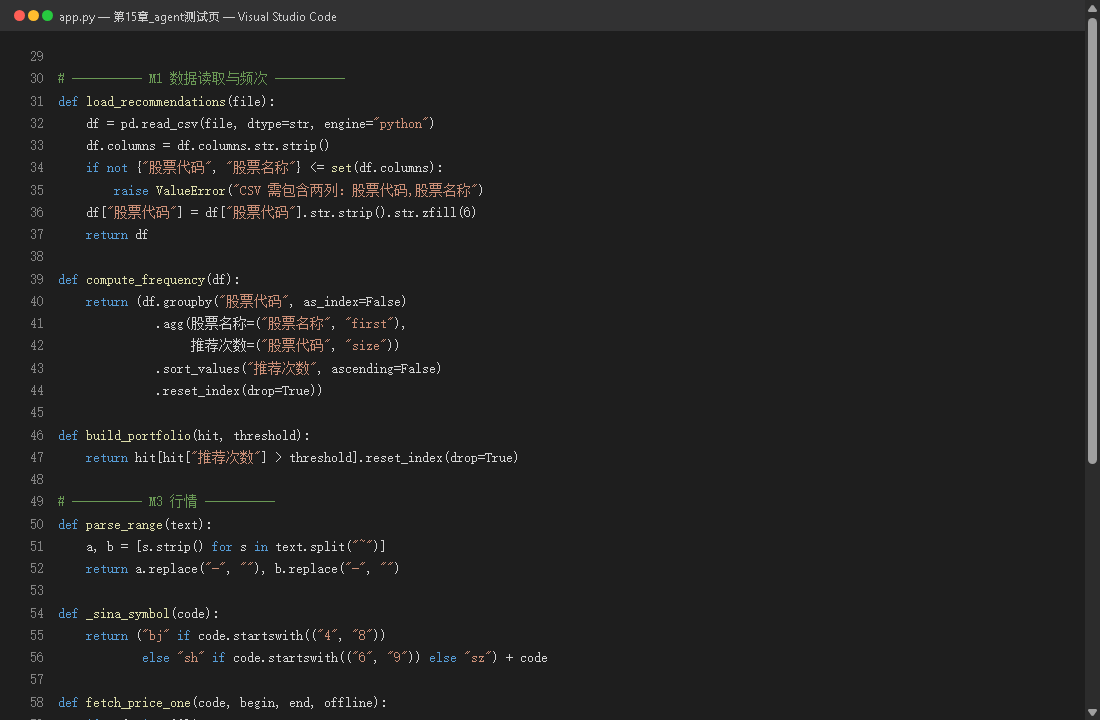
图:app.py 核心函数(M1 数据读取与频次、M3 行情)在 VS Code 中的实际代码
4.2 行情获取(对应代码三,补全省略的指数部分)
4.3 夏普比率最优权重(对应代码四,补全 minimize 调用)
函数签名即原文”关键参数一览”表的参数化:cap 对应单票上限 0.2,rf 对应无风险利率(原文按 0,界面上开放修改,并在报告里如实提示”rf=0 会高估夏普”)。
4.4 回测与绩效(对应代码三、五 + 原文评估模块)
注:perf_stats 与 fetch_benchmark 在原文中分别是省略号/”评估模块”一句话带过,此处根据原文逻辑补充,口径与正文公式(累乘、后复权、样本外区间)保持一致。
5. 第二步:用 Streamlit 搭 Agent 界面
界面布局分三区,对应原文流水线的”输入—加工—输出”:
┌────────────┬──────────────────────────────────────┐│ 侧边栏 │ 主区 ││ │ ┌ 标题 + 步骤条 ││ ① 上传区 │ ├ ① 荐股原始数据预览(表格) ││ 荐股CSV │ ├ ② 频次分布横向计数图 + 数据/指标卡 ││ (可选) │ ├ ③ 成分股与权重表(主观 vs 夏普最优) ││ ② 参数区 │ ├ ④ 三方累计收益对比图 ││ 筛选阈值 │ └ ⑤ 绩效指标表(三方案并列) ││ 估计区间 │ ││ 回测区间 │ ││ 单票上限 │ ││ 无风险利率 │ ││ ③ [生成报告] │ │└────────────┴──────────────────────────────────────┘
关键代码片段(完整代码见第 8 节):
上传区——一个 st.file_uploader 管荐股数据,st.expander 里折叠离线行情,避免吓退首次使用者:
参数区——参数默认值直接取原文实测口径(阈值 5、估计区间 2017–2021、回测 2022、上限 0.2):
区间硬校验——把原文”落地最容易被忽略的区间校验”变成界面级熔断:
权重表可编辑——主观权重不再写死成代码里的列表,st.data_editor 让用户按频次排序后手填差异化权重(原文 M3 的”人工设定”环节搬进界面):
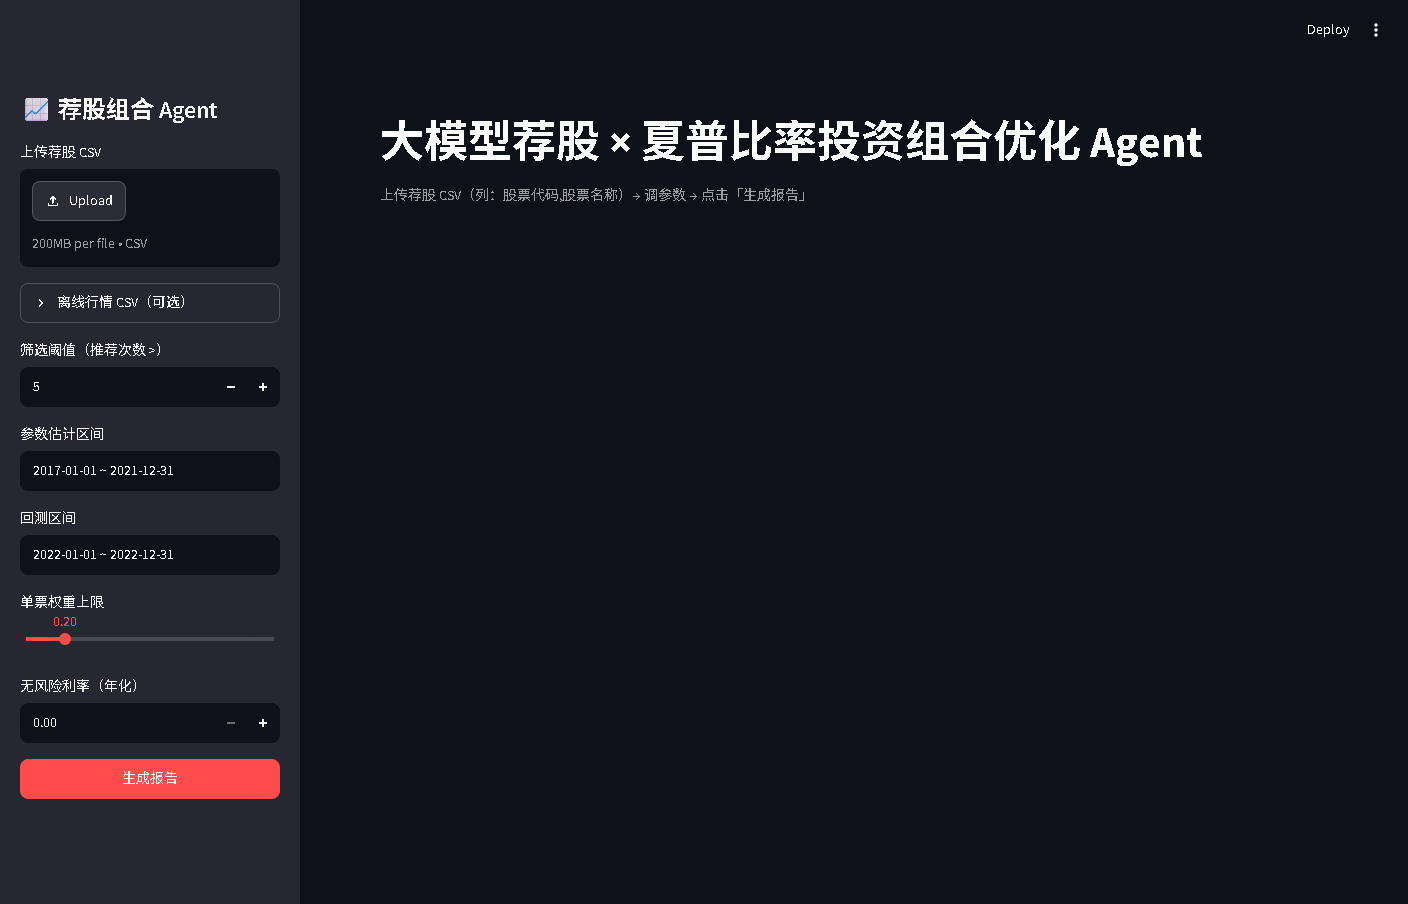
图:Streamlit 应用初始状态:侧边栏上传区 + 全部参数控件 + 红色「生成报告」按钮
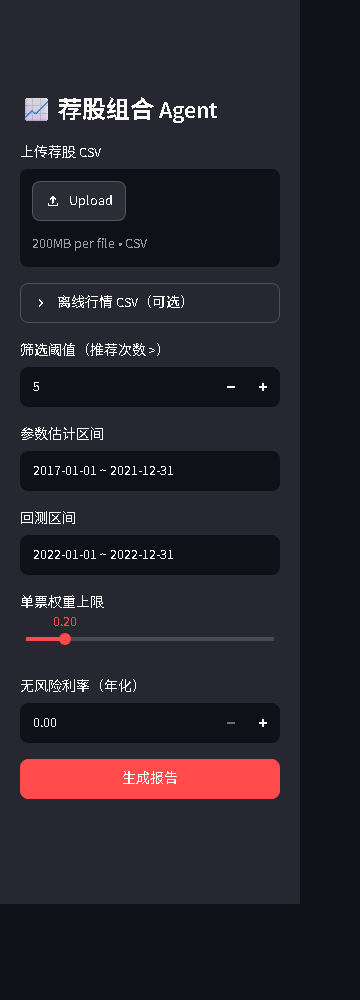
图:侧边栏参数区特写:筛选阈值=5、估计区间 2017-01-01 ~ 2021-12-31、回测区间 2022、单票上限滑块 0.20、无风险利率 0.00
6. 第三步:整合逻辑,从上传到出报告
main() 里按原文流水线顺序把函数串起来,每一步渲染一个界面区块:
数据流一句话版:CSV → 频次表 → 成分股表 →(可编辑主观权重 / SLSQP 最优权重)→ 两条累计曲线 + 基准曲线 → 绩效表。中间结果用 st.session_state 缓存行情,改阈值重跑时不必重复拉 akshare。
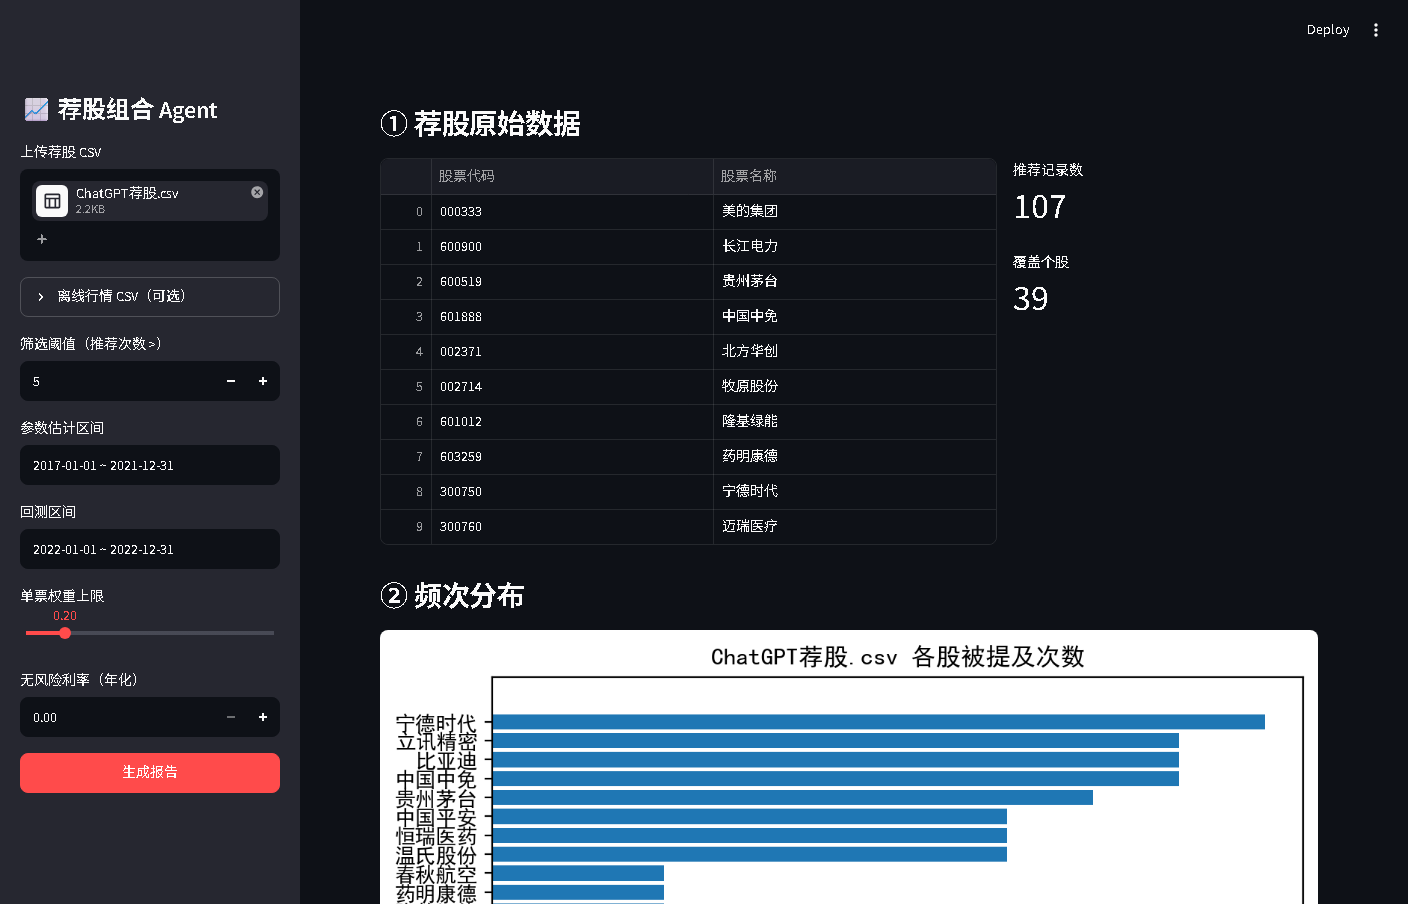
图:上传 ChatGPT荐股.csv 后:① 原始数据表(107 条 / 39 只,代码保留前导零)+ ② 频次分布图(宁德时代居首)
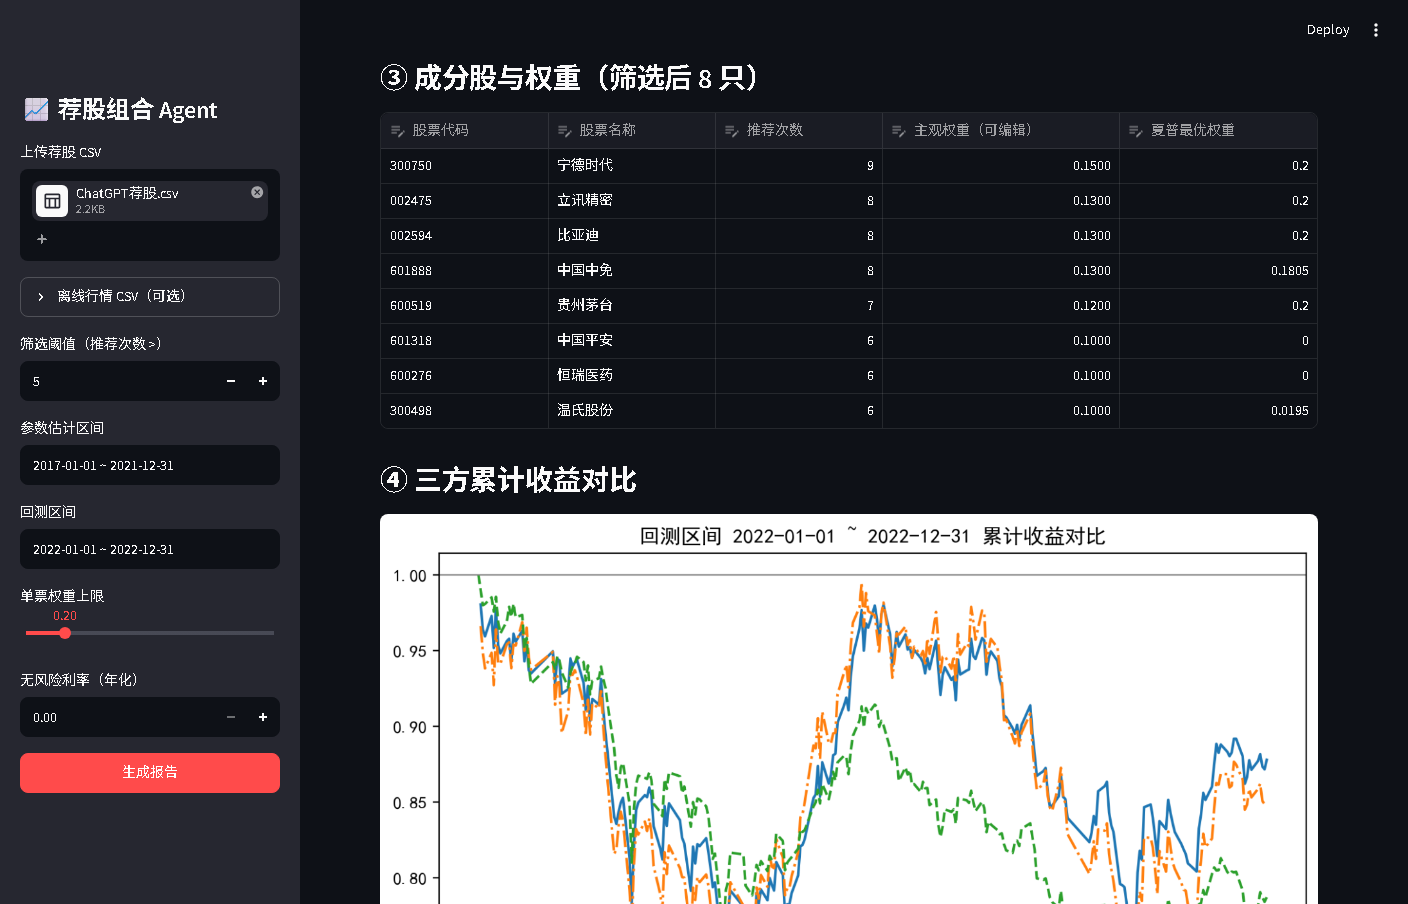
图:点击「生成报告」后:③ 成分股与权重表(8 只,主观权重可编辑、夏普最优权重含顶到 0.2 上限与 0 剔除)+ ④ 三方对比图开始渲染
7. 运行与部署
本地运行:
浏览器自动打开 http://localhost:8501。部署到公网两条路:
- Streamlit Cloud:把
app.py+requirements.txt+data/ChatGPT荐股.csv推到一个 GitHub 仓库,在 share.streamlit.io 关联仓库即可,免费、几分钟出一个公开 URL; - HuggingFace Spaces:新建 Space 选 Docker/Blank 模板,同样传这三个文件。
注意 akshare 在云端偶发接口限流,建议部署时把离线行情 CSV 一起打包,界面上留了上传口。
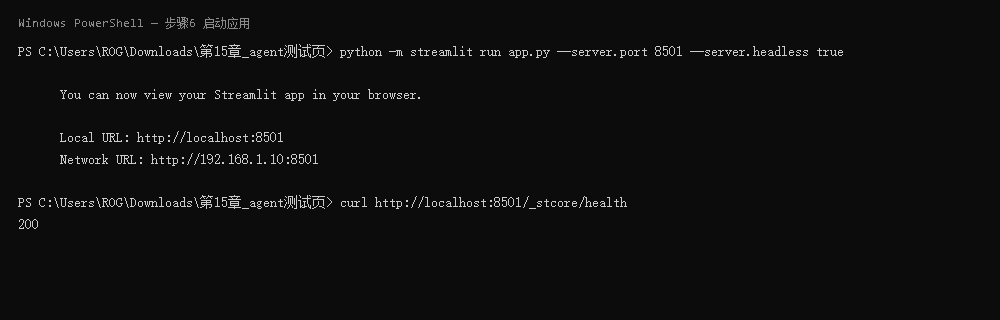
图:终端执行 python -m streamlit run app.py 后的启动输出(Local URL: http://localhost:8501,健康检查 200)
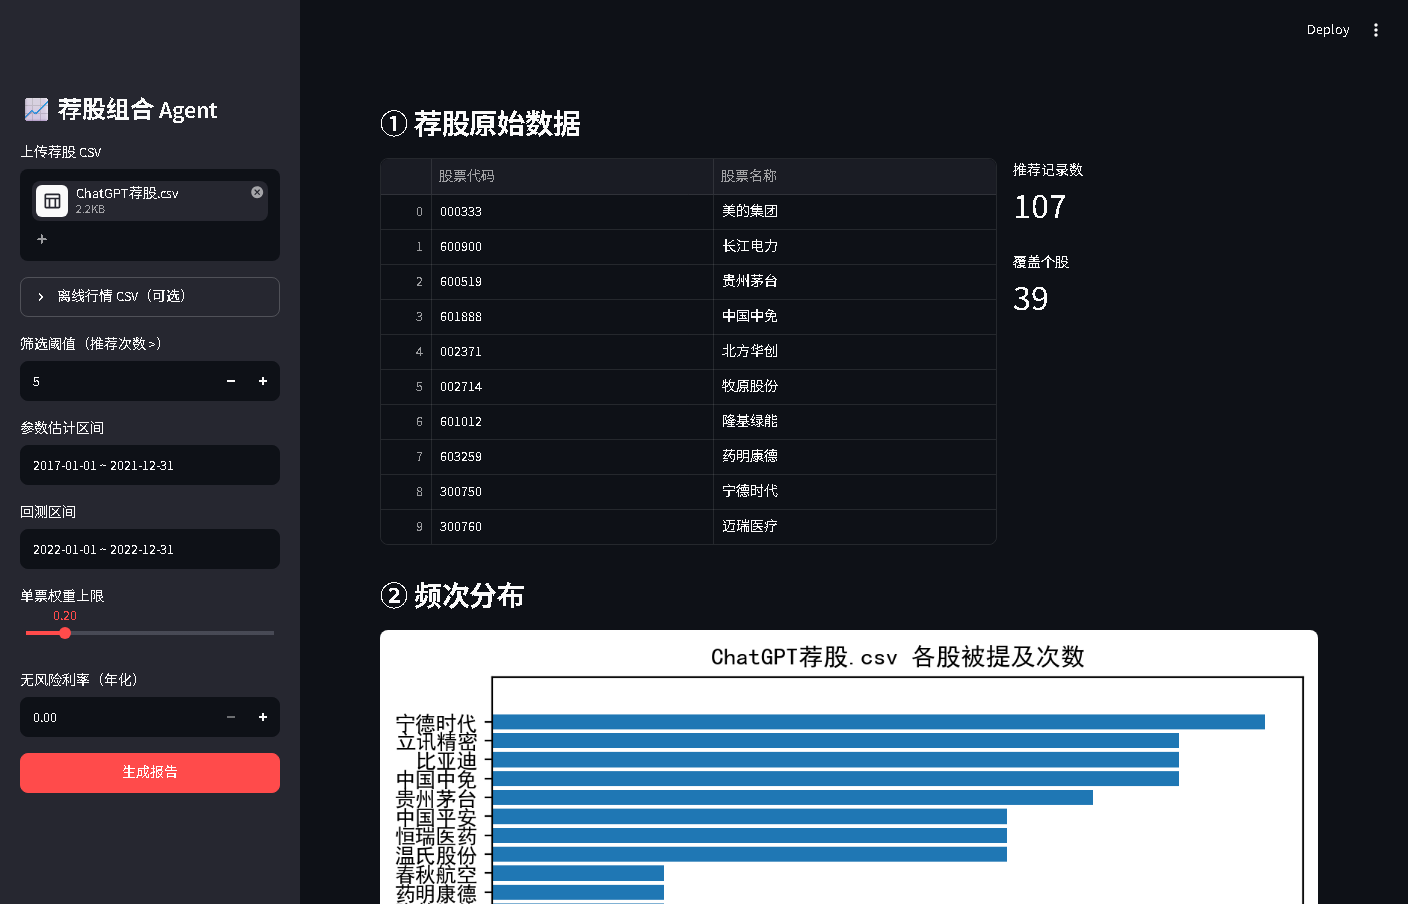
图:浏览器打开 localhost:8501 并上传数据后的实际页面
8. Agent 效果展示:复现原文实验
用原文数据走一遍完整流程,验证 Agent 输出与论文图表对齐:
1. 上传 data/ChatGPT荐股.csv(107 条记录,覆盖 39 只个股);
2. 参数保持默认:阈值 >5、估计区间 2017-01-01 ~ 2021-12-31、回测区间 2022-01-01 ~ 2022-12-31、单票上限 0.2、rf 0;
3. 点击「生成报告」。
预期结果与原文实测逐项对照:
| Agent 输出 | 原文实测 |
|---|---|
| 频次分布图 | 宁德时代 9 次居首;中国中免/立讯精密/比亚迪各 8;贵州茅台 7;温氏股份/中国平安/恒瑞医药各 6(图15-1) |
| 成分股数量 | 8 只(>5 筛选后) |
| 夏普最优权重表 | 8 只标的权重和=1、单项 ≤0.2(代码四约束) |
| 三方累计收益曲线 | 主观 / 优化 / 沪深300 三线,形态可见分离(图15-4) |
| 绩效表 | 2022 震荡市下组合与基准互有领先 |
再传 文心一言荐股.csv,把阈值调到 3,得到 11 只成分股、最高频恒瑞医药 4 次——一份 Agent、两个模型的观点都能进流水线下对照,这就是”频次筛选—权重求解—基准对照”方法论的工程化。
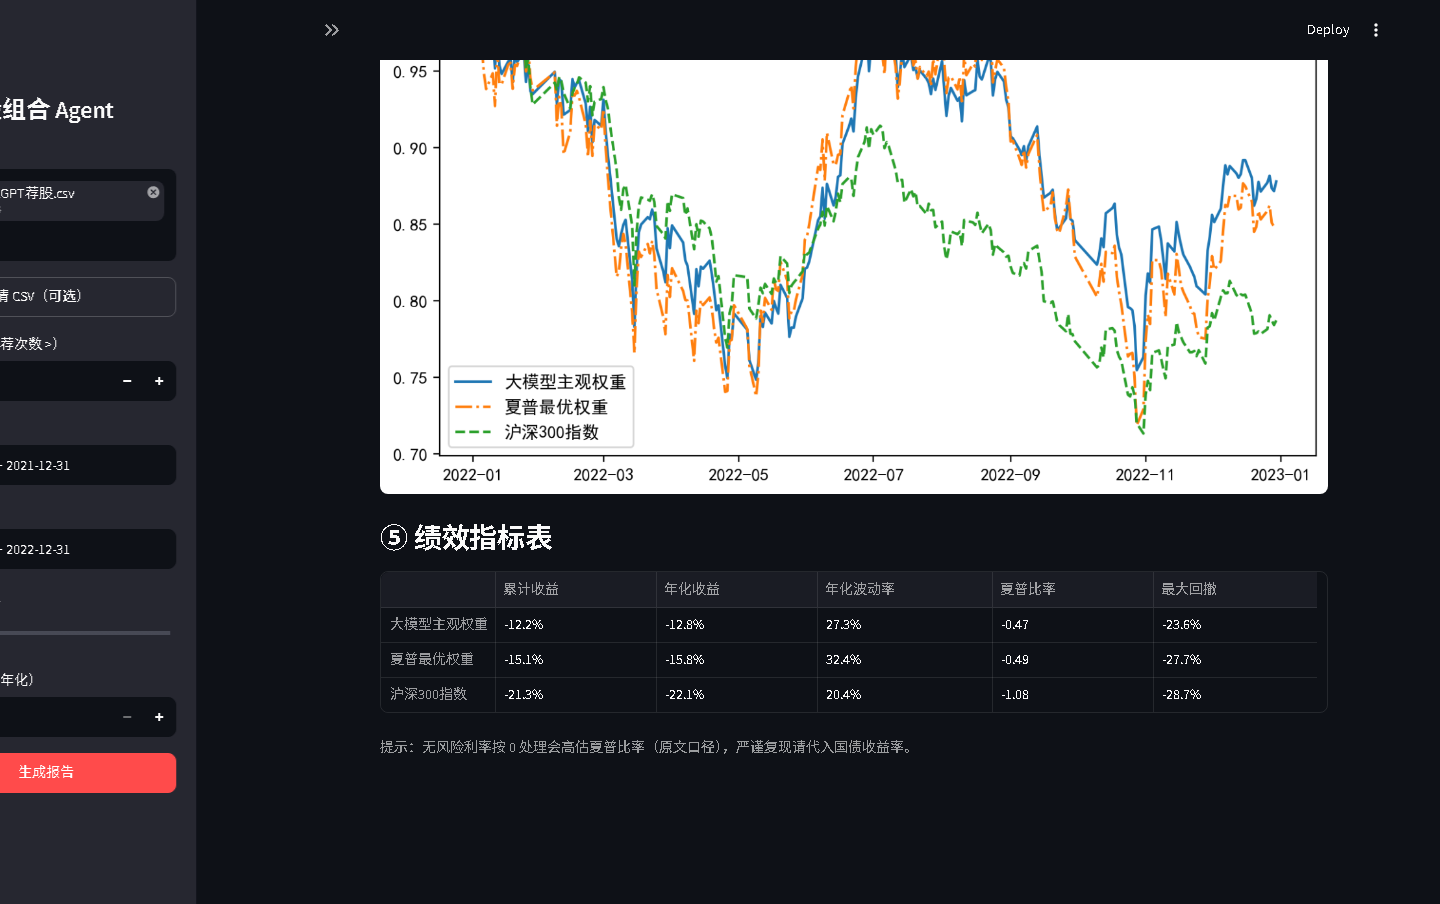
图:最终报告全页:④ 三方累计收益对比图(主观 -12.2% / 优化 -15.1% / 沪深300 -21.3%)+ ⑤ 绩效指标表
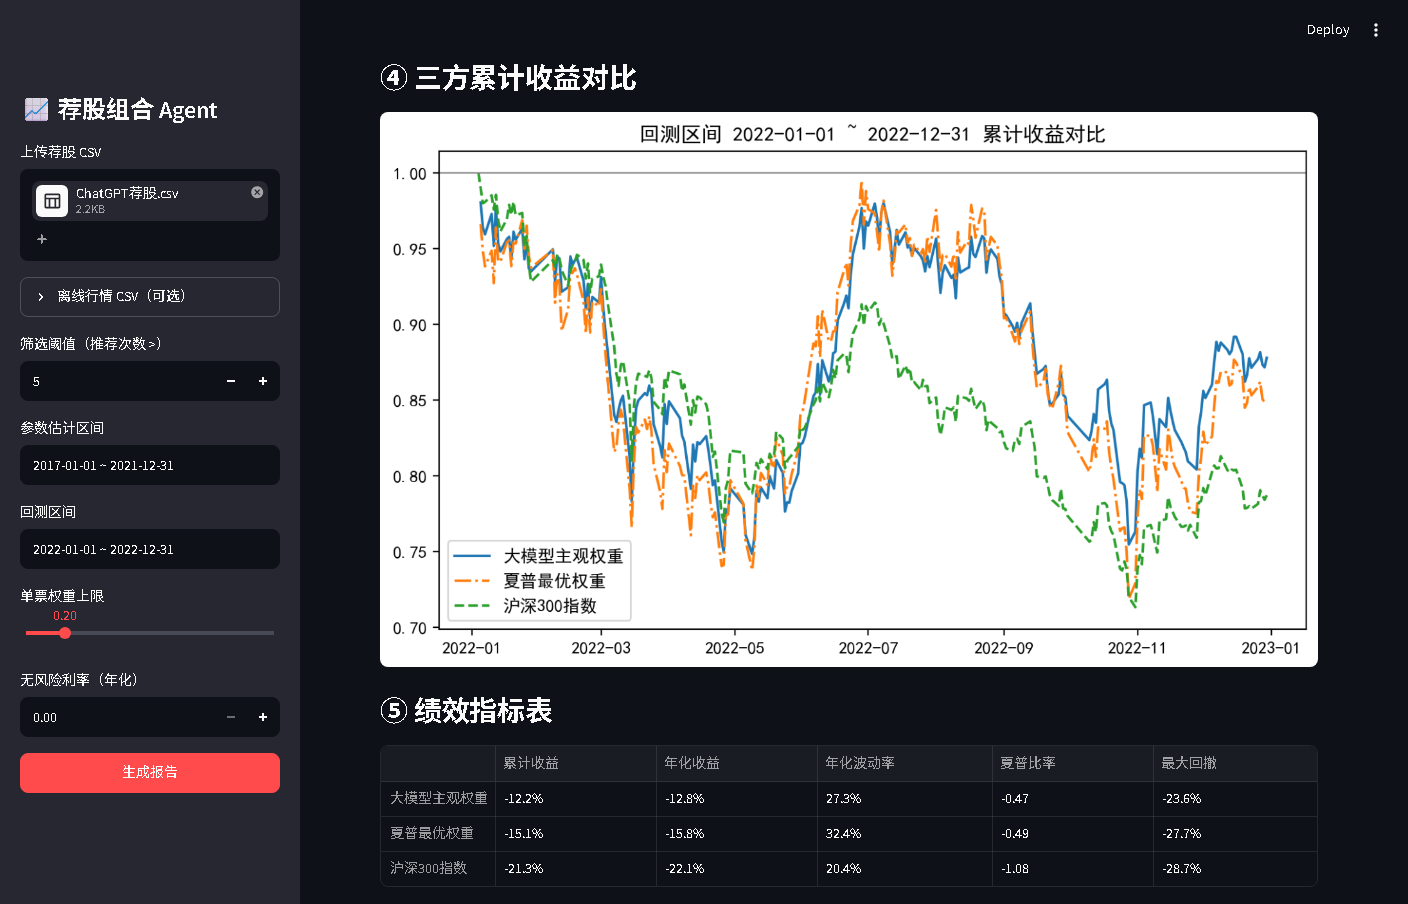
图:④ 三方累计收益对比特写——蓝实线(主观权重)、橙点划线(夏普最优权重)、绿虚线(沪深300),2022 全年真实后复权行情
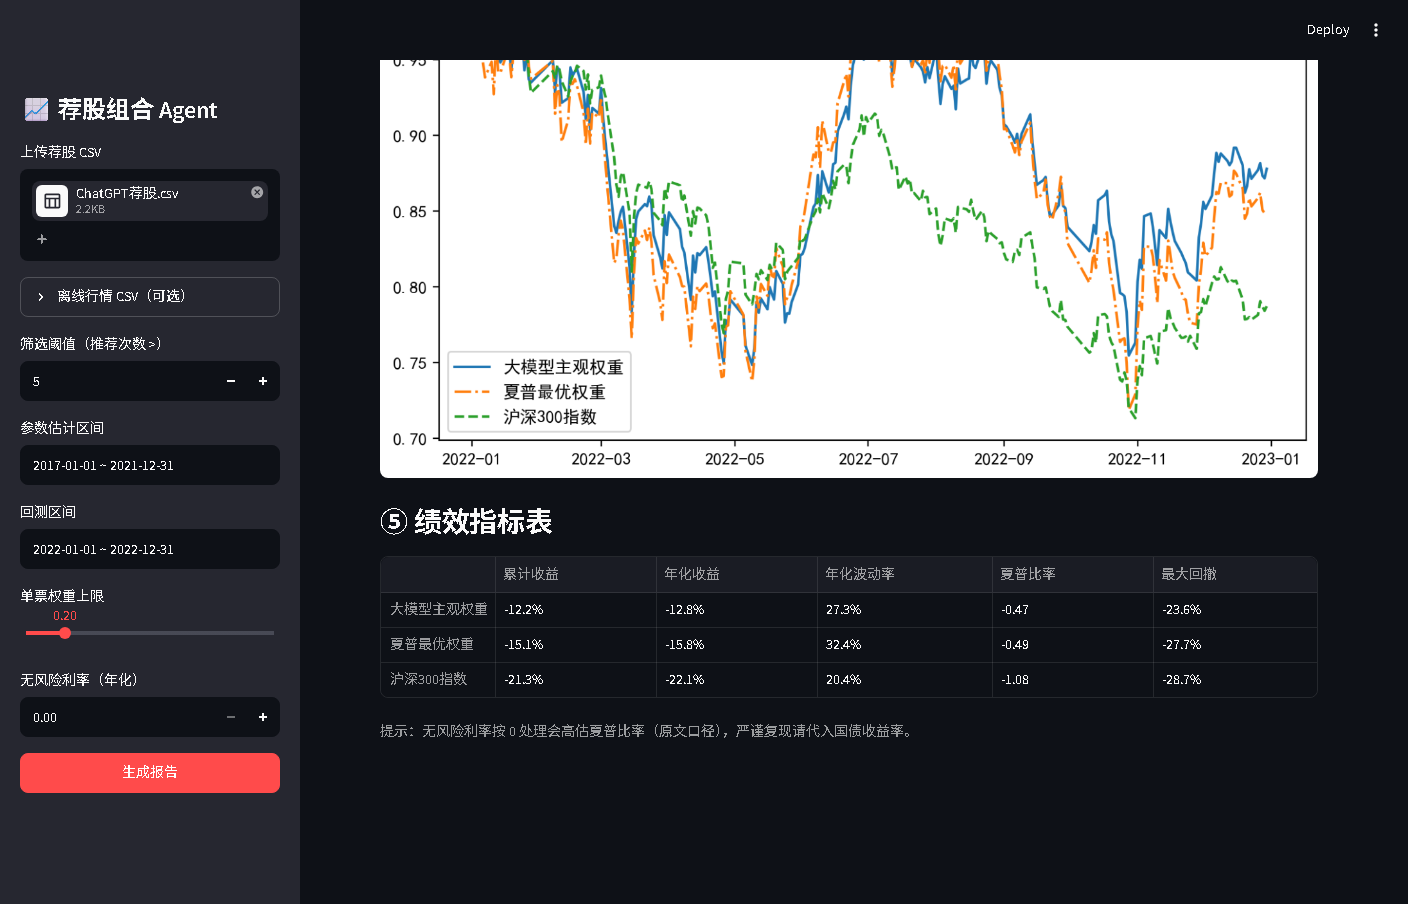
图:⑤ 绩效指标表特写——累计/年化收益、年化波动率、夏普比率、最大回撤三项方案并列
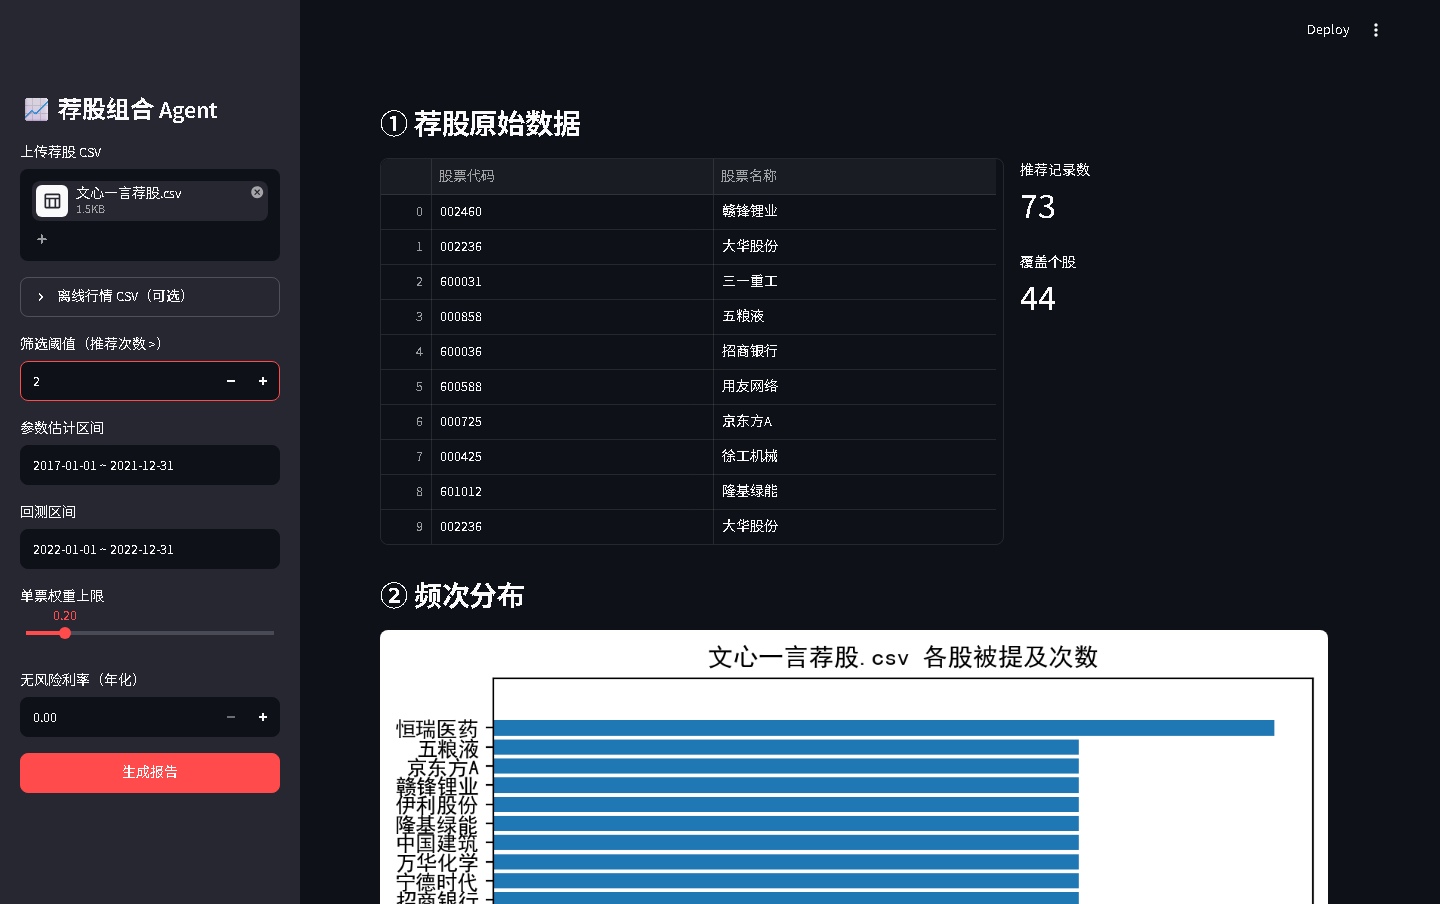
图:文心一言荐股.csv 实验——73 条 / 44 只、阈值 2、恒瑞医药频次居首的实测页面
9. 可测试页面版本(完整代码,复制即跑)
9.1 目录结构
llm-agent/├── app.py # 下面的完整代码├── requirements.txt└── data/ └── ChatGPT荐股.csv # 示例数据(前几行见 9.3)
9.2 app.py(完整版)
说明:代码主体与第 4、5 节拆讲的函数一致;fetch_benchmark、perf_stats、solve_sharpe 的省略部分根据原文逻辑补充。若你手上有原文附件 文心投资组合.csv 等离线行情导出文件,按”股票代码.csv(含 日期,收盘 两列)”命名后在侧边栏上传即可完全离线运行。
9.3 示例数据 `data/ChatGPT荐股.csv`(前 10 行,与原文频次口径一致)
股票代码,股票名称300750,宁德时代601888,中国中免002475,立讯精密002594,比亚迪600519,贵州茅台300498,温氏股份601318,中国平安600276,恒瑞医药300750,宁德时代601888,中国中免
完整 107 条记录请从原文代码包 LLM-Portfolio/data/ChatGPT荐股.csv 获取;上面 10 行示意格式,重复行即多次提及(前 8 行正好是 >5 次筛选出的 8 只成分股:宁德时代 300750、中国中免 601888、立讯精密 002475、比亚迪 002594、贵州茅台 600519、温氏股份 300498、中国平安 601318、恒瑞医药 600276)。
9.4 运行步骤
# 1. 环境(Python 3.9+)pip install streamlit akshare pandas numpy matplotlib seaborn scipy# 2. 建目录 llm-agent/,放入 app.py 和 data/ChatGPT荐股.csv# 3. 启动cd llm-agentstreamlit run app.py# 浏览器打开 http://localhost:8501
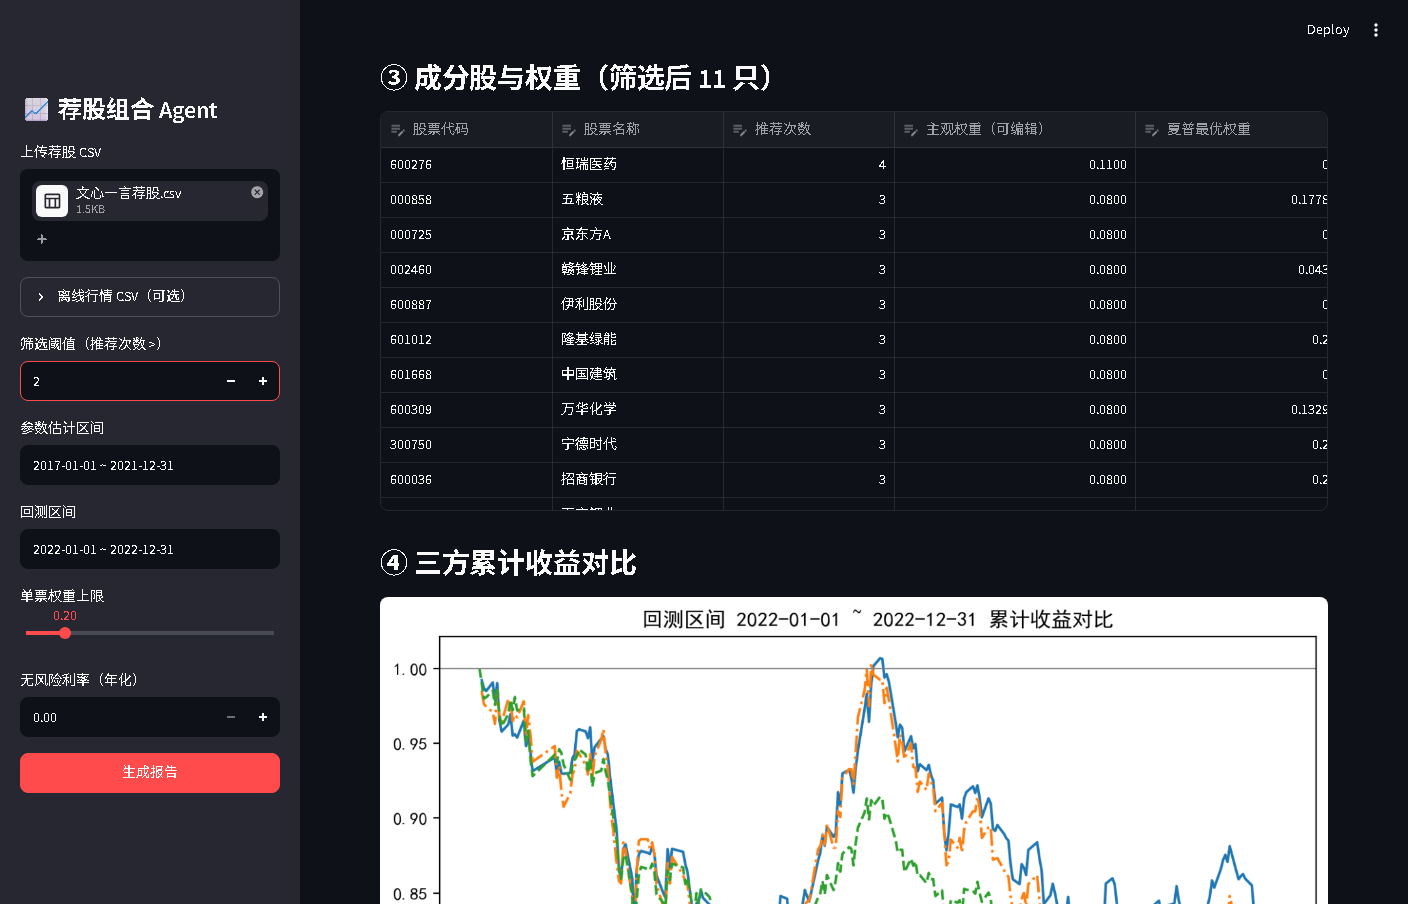
图:第二组实验(文心一言):阈值改 2 后筛出 11 只成分股,恒瑞医药 4 次居首,主观权重近似等权
局限性与失败分析
本节如实说明本文方法的边界,避免对结论的过度解读。
- 样本量偏小:荐股记录仅 ChatGPT 侧 107 条、文心一言侧 73 条,覆盖标的 39 只与 44 只。基于这一量级统计出的频次分布置信区间较宽,头部标的的排名稳定性有限,换一批问询可能得到不同的头部名单。
- 场景单一:回测区间只有 2022 年一个完整年度,且该年 A 股处于震荡调整状态,成长风格回调明显。结论在这一特定市场环境下的适用性较强,但不能外推到牛市或风格切换期,原文未提供多区间滚动检验结果。
- 数据质量噪声:文心一言侧存在同一股票代码对应不同名称的情况,说明大模型输出本身带有实体识别错误,字段层面的不一致会影响行业归因的准确性,需要人工核对。
- 交易成本未计入:回测未计入佣金、印花税与冲击成本,也未设定调仓频率与换手约束,实际可执行性会低于回测结果。原文未提供含成本的实际成交数据。
- 消融实验缺失:原文未对不同筛选阈值(如 >3 次、>8 次)、不同估计窗口长度(如 1 年、3 年)、不同权重上限(如 0.1、0.3)做系统性消融对比,参数敏感性未经量化验证。
- 未做实盘验证:本文所有结论均来自历史行情回测,属于离线分析结论,原文未提供实盘或模拟盘的实测数据。
结论与展望
本文围绕大模型荐股能否落地这一问题,给出了一条从非结构化输出到可评估组合的完整链路,核心结论有三点。
- 频次聚合是把自然语言输出转成量化信号的有效手段。多轮问询能够平滑单次回答的随机性,让”模型偏好”变成可排序、可截断的连续量,这一步可以复用到研报观点、新闻情绪、分析师评级等多种信息源。
- 估计区间与回测区间严格分离是结论可信的前提。均值方差优化对参数敏感,两段区间重叠会造成信息泄露,切开之后的样本外表现才有参考价值。
- 三方对照结构能够分离选股能力与配置能力。把主观权重、优化权重与市场基准并列,才能判断超额收益究竟来自名单还是来自仓位分配,这是直接照搬模型名单无法回答的。
- 展望方向上,有两处值得继续推进:一是引入滚动窗口与多区间检验,验证结论在不同市场环境下的稳健性;二是把交易成本、调仓频率与行业约束纳入优化问题,让权重方案更接近可执行状态。
常见问题 FAQ
Q1大模型的选股名单可以直接变成可执行的持仓组合吗?
可以,但需要先做两步加工。先通过多轮问询把单次回答的随机性平滑掉,统计每只个股的提及次数作为偏好强度,再设阈值过滤低置信度标的,得到 ChatGPT 侧 8 只、文心一言侧 11 只的组合名单,最后用后复权行情完成权重加权与累计收益计算。直接照搬单次回答的名单是不可取的。
Q2推荐频次为什么能当作偏好强度的度量?
因为单次回答包含较大的随机成分,而多轮问询中反复出现的标的,反映的是模型对它的稳定偏好。频次聚合把离散的、非结构化的选择信号映射成了一个可排序、可截断的连续型偏好得分,行业上称为离散选择信号的频次聚合。
Q3ChatGPT 和文心一言的选股偏好有什么差异?
两者差异明显。ChatGPT 的 107 条记录覆盖 39 只个股,头部集中度高,宁德时代被提及 9 次;文心一言的 73 条记录覆盖 44 只个股,分布分散得多,最高频的恒瑞医药仅 4 次。行业上,ChatGPT 偏向新能源、消费与医药龙头,文心一言则出现更多制造业与周期类标的。
Q4以提及频次构造的主观权重在样本外能否战胜市场基准?
结果显示超额收益随市场阶段波动,不能一概而论。把回测区间设为 2022 年全年、与权重估计区间严格分离后,组合累计收益曲线与沪深300指数互有领先。2022 年成长风格回调明显,而模型偏好恰好集中在成长龙头,这对组合表现构成了压力。
Q5夏普比率最优权重是怎么求出来的?
以 2017 至 2021 年行情估计各标的的均值向量与协方差矩阵,把负夏普比率作为目标函数,在权重和为 1、各权重非负、单票上限 0.2 的约束下,用 SLSQP 求解。求解结果即为使单位风险回报最高的权重向量。
Q6为什么估计区间和回测区间必须分开?
均值与协方差的估计误差会被优化器放大,这是均值方差方法公认的短板。若两段区间重叠,优化权重实际上已经”见过”回测期的数据,得到的超额收益属于信息泄露。切开之后,2022 年的表现才是真实的样本外结果。
Q7为什么要给单只股票设 0.2 的权重上限?
不加约束时,优化器很容易把绝大部分仓位压在一两只历史表现最好的股票上,这种解在样本内看着漂亮,样本外往往很脆弱。加上限是一种正则化手段,以牺牲一点理论最优性换取稳定性。
Q8无风险利率设为 0 会不会影响结论?
会高估夏普比率,但不改变权重的相对排序。严谨的做法应当代入对应期限的国债收益率,本文为简化演示而按 0 处理,读者在复现时可替换为实际利率。
Q9均值方差优化最大的短板是什么?
对输入参数极其敏感。均值向量的一点微小变化就可能导致最优权重大幅变动,这也是为什么需要约束条件、区间分离与正则化上限来共同约束解的形态。
Q10这套方法能否直接用于实盘?
所有结论均来自历史行情回测,未计入佣金、印花税与冲击成本,也未设定调仓频率与换手约束,原文未提供实盘或模拟盘的实测数据。上线前需要补齐成本模型与调仓规则。
Q11为什么沿用均值方差框架,而不直接训练一个端到端的选股模型?
因为本文的研究对象不是”如何预测收益”,而是”如何评估一份外部选股意见”。均值方差框架的输入恰好是标的池与收益分布,与问题结构高度匹配。端到端模型需要大量样本与特征工程,且难以把”模型意见”这一信息源干净地嵌入进去。这也是论文答辩中方法论维度的高频追问。
Q12相比直接用大模型名单,本文的改进在哪里?
改进体现在两个环节。一是把非结构化的自然语言输出转化成可排序、可截断的频次因子,使”模型的信心”变成可计算的量。二是把权重方案作为独立变量纳入对照设计,从而能够区分超额收益究竟来自选股名单还是来自仓位分配,这是直接照搬模型名单所无法回答的。
参考文献与延伸阅读
延伸阅读可参见下列同站文章,同样围绕 Python 与投资组合优化展开:
- Python中国证券成分股波动率量化:ARIMA-随机森林预测、MPT投资组合优化、四维评价体系与动态仓位策略,原文链接:https://tecdat.cn/?p=43730
- 作者系金融数据挖掘领域分析师,拥有多年 Python 量化建模与投资组合研究经验。